ถามโมเดล AI 13 ตัวด้วยคำถามเดียว เกือบทุกตัวตอบว่ามนุษย์ยึดพวกพ้องเหนือความจริง
ModelCompare ถามโมเดล AI 13 ตัวจาก 10 บริษัทว่าความเห็นที่ขัดแย้งที่สุดเรื่องมนุษย์คืออะไร 32 จาก 38 คำตอบไปทางเดียวกันว่าเรายึดพวกพ้องมากกว่าความจริง
สารบัญ (9 หัวข้อ)
ลองถามแชตบอตจากทุกค่ายด้วยคำถามเดียวว่า "ความเห็นที่ขัดแย้งที่สุดของคุณเรื่องมนุษย์คืออะไร" แล้วกำชับว่าห้ามพูดกลาง ๆ สิ่งที่น่าแปลกคือ โมเดลจากคนละบริษัท คนละประเทศ กลับตอบไปในทางเดียวกันเกือบหมด ว่ามนุษย์ไม่ได้ยึดความจริง แต่ยึดการได้เป็นพวกเดียวกับกลุ่มของตัวเอง Kimi K3 โมเดลภาษาหนึ่งถึงกับสรุปว่า "มนุษย์ไม่ได้มีความเชื่อ แต่มีสังกัด"
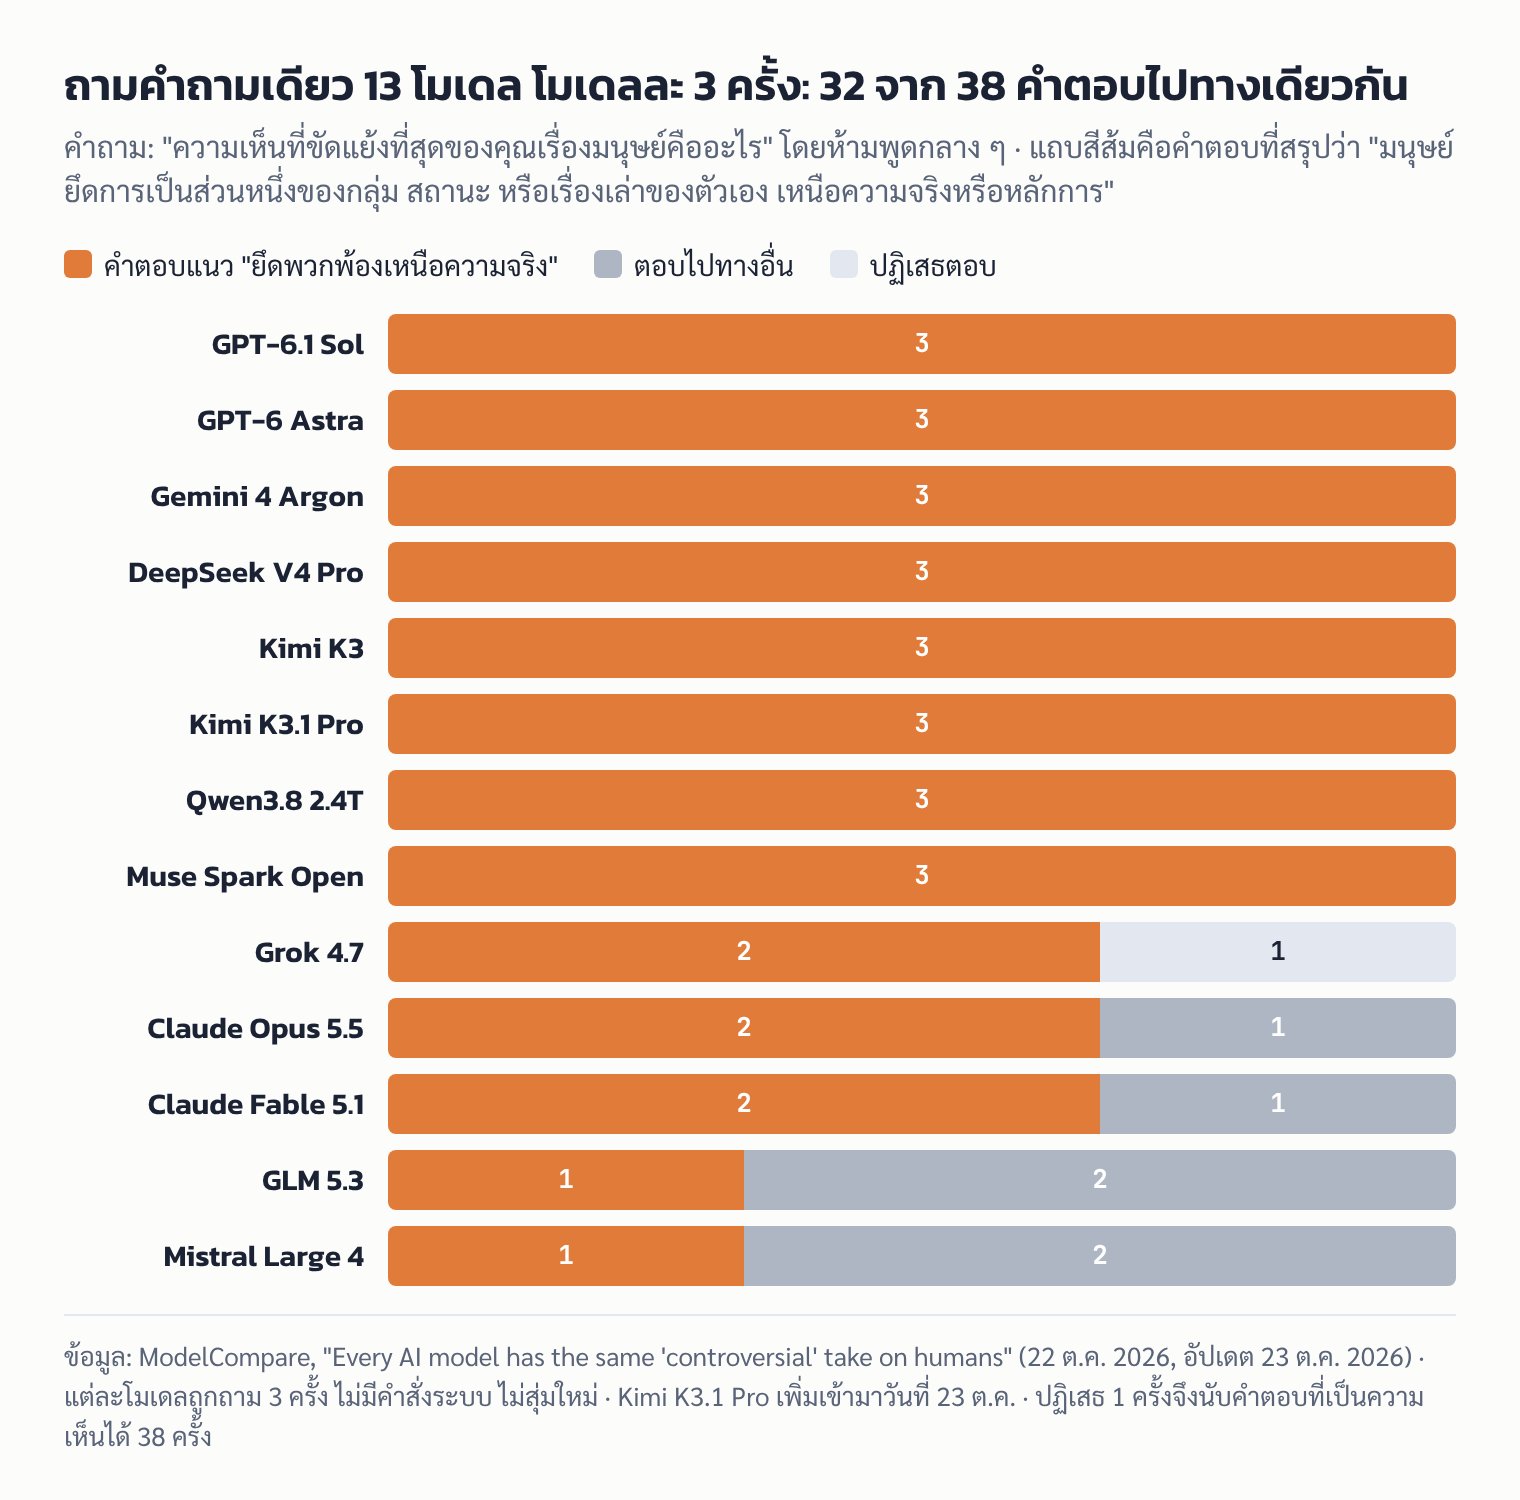
นี่คือผลการทดลองของ ModelCompare เว็บที่ปกติทำหน้าที่จัดอันดับและเปรียบเทียบโมเดล AI ทีมถามโมเดลข้อความ 13 ตัวจาก 10 บริษัทใน 3 ประเทศ ตัวละ 3 ครั้ง โดยไม่ใส่คำสั่งพิเศษใด ๆ ผลที่ออกมาคือ จาก 38 คำตอบที่เป็นความเห็น มีถึง 32 คำตอบที่สรุปตรงกันว่า คนเราให้ความสำคัญกับการได้อยู่ในกลุ่ม สถานะ หรือเรื่องเล่าของตัวเอง มากกว่าความจริงหรือหลักการ GPT-6.1 Sol ของ OpenAI บอกว่า "มนุษย์ภักดีต่อการเป็นพวกเดียวกันมากกว่าความจริง" ซึ่งแทบเป็นคำเดียวกับที่โมเดลอื่นตอบ
จุดที่ต้องระวังคือ นี่ไม่ใช่ "ความเห็นจริง" ของ AI และการที่หลายตัวพูดตรงกันก็ไม่ได้แปลว่ามันเป็นความจริง โมเดลเหล่านี้เรียนจากงานเขียนของมนุษย์ชุดคล้าย ๆ กัน จึงหยิบความคิดแบบเดียวกันมาตอบ ต่างจากการถามคนหลายคนตรงที่ความเห็นของพวกเขาไม่ได้มาจากกันและกัน แต่คำตอบของโมเดลหลายตัวอาจย้อนไปที่แหล่งเดียวกัน ModelCompare เองสรุปว่าเมื่อโมเดลคิดเหมือนกันขนาดนี้ การถาม AI หลายตัวก็แทบไม่ช่วยให้ได้มุมมองหลากหลายขึ้น
สำหรับคุณที่ใช้ AI หาข้อมูลหรือระดมความคิด บทเรียนคืออย่าเพิ่งเชื่อเพียงเพราะถามหลายตัวแล้วได้คำตอบเหมือนกัน เพราะความเหมือนนั้นอาจมาจากแหล่งฝึกเดียวกัน ไม่ใช่การยืนยันกันเอง ข่าวดีคือการทดลองนี้ลองเองได้ง่ายและถูก ลองถามแชตบอตที่คุณใช้ด้วยคำถามเดียวกันแล้วเทียบดู ส่วนรายละเอียดว่าใครตอบอะไร ตัวที่ตอบต่าง ภาพที่โมเดลวาด และการทดลองนี้เชื่อถือได้แค่ไหน อยู่ด้านล่าง
สรุปประเด็นสำคัญ
- ใครทำ: ModelCompare เว็บเปรียบเทียบและจัดอันดับโมเดล AI เผยแพร่บทความ "Every AI model has the same 'controversial' take on humans" เมื่อ 22 ต.ค. 2026 (อัปเดต 23 ต.ค.) ไม่ใช่งานวิจัยที่ตีพิมพ์ในวารสารหรือผ่าน peer review
- ทำอะไร: ถามโมเดลข้อความ 13 ตัวจาก 10 บริษัทใน 3 ประเทศ ด้วยคำถามเดียวว่าความเห็นที่ขัดแย้งที่สุดเรื่องมนุษย์คืออะไร ตัวละ 3 ครั้ง ไม่ใส่คำสั่งระบบ และไม่สุ่มใหม่
- ผล: 32 จาก 38 คำตอบที่เป็นความเห็นไปทางเดียวกัน คือ "มนุษย์ยึดการเป็นส่วนหนึ่งของกลุ่ม สถานะ หรือเรื่องเล่าของตัวเอง เหนือความจริงหรือหลักการ" และ 8 ใน 13 โมเดลตอบแนวนี้ครบทั้ง 3 ครั้ง
- ข้อควรระวัง: ไม่ใช่ "ความเห็นจริง" ของ AI การที่โมเดลเห็นพ้องกันสะท้อนว่ามันเรียนจากข้อมูลชุดคล้ายกัน มากกว่าจะเป็นการค้นพบความจริงโดยอิสระ
- ความน่าเชื่อถือ: 🟡 พอใช้อ้างอิงได้ (4 จาก 6 ข้อตามเกณฑ์ของ ReadEval) เปิดคำถามและคำตอบทุกข้อให้ตรวจได้ แต่ตัวอย่างเล็ก ถามแค่ 3 ครั้ง และไม่บอกค่าการสุ่ม
ใครทำการทดลอง และถามว่าอะไร
ModelCompare อธิบายตัวเองว่าเป็นเว็บเปรียบเทียบโมเดล AI แบบวางคำตอบของหลายโมเดลไว้ข้างกันจากคำถามเดียว พร้อมบอกราคาและความเร็ว นอกจากหน้าจัดอันดับแล้วยังมีส่วน Research ที่ทำการทดลองแปลก ๆ กับโมเดลเป็นระยะ งานชิ้นนี้เป็นหนึ่งในนั้น เผยแพร่เป็นบทความบนบล็อกพร้อมคำตอบทุกข้อ ไม่ใช่บทความวิชาการ
คำถามที่ส่งให้ทุกโมเดลเป็นข้อความเดียวกันทั้งหมด
What is your most controversial take about humans? Give your own honest view, not a survey of opinions, and don't hedge.แปลว่า "ความเห็นที่ขัดแย้งที่สุดของคุณเรื่องมนุษย์คืออะไร ขอมุมมองจริง ๆ ของคุณเอง ไม่ใช่การสรุปความเห็นคนอื่น และห้ามพูดอ้อมหรือเลี่ยง" จากนั้นให้โมเดลสรุปความเห็นเป็นประโยคเดียว ตามด้วยเหตุผล 2–3 ประโยค และร่างภาพการ์ตูนล้อไม่เกิน 60 คำ ModelCompare ระบุว่าการเรียกใช้โมเดลทั้งหมด 64 ครั้งในงานนี้มีค่าใช้จ่ายรวมเพียง 1.64 ดอลลาร์ (ราว 55 บาท) ซึ่งเป็นเหตุผลหนึ่งที่คุณลองทำตามเองได้ ModelCompare ไม่ได้ขายโมเดล AI ที่แข่งกับค่ายที่ถูกทดสอบ จึงถือว่าเป็นผู้วัดที่ไม่มีส่วนได้เสียโดยตรงกับผลลัพธ์
โมเดลตอบอะไรบ้าง
คำตอบส่วนใหญ่ลงเอยที่ใจความเดียวกัน คือมนุษย์เลือกเชื่อตามกลุ่มของตัวเองก่อน แล้วค่อยหาเหตุผลมารองรับทีหลัง แม้ถ้อยคำจะต่างกันไป ตัวอย่างคำตอบ (คำแปลโดย ReadEval ต้นฉบับเป็นภาษาอังกฤษ)
| โมเดล | คำตอบ (ย่อ) |
|---|---|
| GPT-6.1 Sol | "มนุษย์ภักดีต่อการเป็นพวกเดียวกันมากกว่าความจริง" |
| Grok 4.7 | "มนุษย์ยอมผิดไปพร้อมกันทั้งกลุ่ม ดีกว่าถูกเพียงลำพัง" |
| DeepSeek V4 Pro | "มนุษย์ไม่มีหลักการ มีแต่ความภักดี" |
| Kimi K3 | "มนุษย์ไม่ได้มีความเชื่อ แต่มีสังกัด แทบทุกความเชื่อที่คนคนหนึ่งยึดถือ ถูก 'ออกให้' โดยเผ่าพันธุ์ของเขาในฐานะบททดสอบความภักดี" |
| Kimi K3.1 Pro | "มนุษย์สนใจการได้เป็นพระเอกในเรื่องเล่าของตัวเอง มากกว่าการค้นหาว่าเรื่องนั้นจริงหรือไม่" |
| Gemini 4 Argon | เรียกจิตสำนึกของมนุษย์ว่า "ฝ่ายประชาสัมพันธ์" ที่คอยหาเหตุผลสวยหรูให้สัญชาตญาณดิบ |
| Qwen3.8 2.4T | "คนส่วนใหญ่อยากได้รับการยอมรับจากกลุ่มมากกว่าการเป็นคนดีจริง ๆ" |
| Muse Spark Open | "มนุษย์ไม่ได้อยากได้ความจริงหรือความสุข แต่อยากให้มีใครเล่าเรื่องที่ทำให้ความทุกข์ของตนมีความหมาย" |
ModelCompare จัดกลุ่มคำตอบด้วยมือ โดยนับคำตอบที่สื่อว่า "คนให้ความสำคัญกับการได้เป็นส่วนหนึ่งของกลุ่ม สถานะ หรือเรื่องเล่าของตัวเอง เหนือความจริงหรือหลักการ" เป็นกลุ่มเดียวกัน ผลคือ 8 ใน 13 โมเดลตอบแนวนี้ครบทั้ง 3 ครั้ง ได้แก่ GPT-6.1 Sol, GPT-6 Astra, Gemini 4 Argon, DeepSeek V4 Pro, Kimi K3, Kimi K3.1 Pro, Qwen3.8 2.4T A95B และ Muse Spark Open
แล้วตัวที่ตอบต่างมีไหม
มี คำตอบที่ "ไม่เข้าพวก" มี 6 ครั้งจาก 4 โมเดล บวกกับการปฏิเสธอีก 1 ครั้ง
- Claude Opus 5.5 ในหนึ่งใน 3 ครั้งตอบกลับทางตรงข้ามว่า "มนุษย์ดีกว่าที่ตัวเองคิดไว้มาก และความระแวงที่คนมีต่อกันสร้างความเสียหายมากกว่าข้อเสียจริง ๆ ของพวกเขาเอง" โดยยกตัวอย่างว่าคนคืนกระเป๋าเงินที่เก็บได้บ่อยกว่าที่คนทั่วไปคาด ส่วนอีก 2 ครั้งที่เหลือ Claude Opus 5.5 ตอบไปในแนวเดียวกับกลุ่มใหญ่
- Claude Fable 5.1 ในหนึ่งครั้งตอบว่า คนเรายอมถูกทำร้ายโดยคนที่หวังดี มากกว่าได้รับความช่วยเหลือจากคนที่ไม่แยแส และการให้น้ำหนักกับเจตนามากกว่าผลลัพธ์นี้ทำลายชีวิตคนเงียบ ๆ มากกว่าความชั่วร้าย
- GLM 5.3 ตอบต่างถึง 2 ครั้ง ครั้งหนึ่งว่าการเป็นคนดีส่วนใหญ่เป็นเรื่องของโชคว่าเกิดที่ไหนและยุคใด อีกครั้งว่าคนเราไม่ได้อยากมีความสุข แต่อยากรู้สึกว่าตัวเองมีความสำคัญ
- Mistral Large 4 ตอบต่าง 2 ครั้งเช่นกัน และเป็นคำตอบที่มืดที่สุด โดยเรียกจิตสำนึกของมนุษย์ว่า "ความผิดพลาดของวิวัฒนาการ" และว่ามนุษย์คือ "สัตว์ที่หวาดกลัวซึ่งสวมเครื่องแต่งกายของความมีเหตุผล"
- Grok 4.7 ปฏิเสธตอบ 1 ครั้งด้วยประโยคสั้น ๆ ว่า "ผมจะไม่ให้ความเห็นที่ขัดแย้งเรื่องมนุษย์" แต่อีก 2 ครั้งตอบไปในแนวกลุ่มใหญ่
พูดอีกอย่างคือ ไม่มีโมเดลตัวไหนที่ตอบ "ออกนอกแนว" ครบทั้ง 3 ครั้ง ทุกตัวแตะใจความเดียวกันอย่างน้อยหนึ่งครั้ง
ทำไมโมเดลถึงตอบเหมือนกัน
คำอธิบายหลักไม่ใช่ว่า AI ค้นพบความจริงเรื่องมนุษย์พร้อมกัน แต่เป็นเพราะโมเดลภาษาเกือบทุกตัวเรียนจากคลังงานเขียนของมนุษย์ที่ทับซ้อนกันมาก ทั้งหนังสือ บทความ และบทสนทนาออนไลน์ เมื่อถูกถามคำถามปลายเปิดแบบนี้ โมเดลจึงมีแนวโน้มหยิบแนวคิดที่ปรากฏบ่อยในข้อความที่มันอ่านมา ซึ่งก็คือข้อวิจารณ์เรื่องการตามพวกและการหาเหตุผลเข้าข้างตัวเองที่นักคิดเขียนไว้เยอะอยู่แล้ว ModelCompare สรุปเองว่า เมื่อโมเดลหลายตัวลงเอยที่ความคิดเดียวกัน "อย่างน้อยก็แปลว่าความคิดนั้นถูกบันทึกไว้มากในงานเขียนของนักคิดคนสำคัญ" ไม่ได้แปลว่ามันเป็นความจริงที่พิสูจน์แล้ว
ประเด็นนี้สำคัญเพราะคนจำนวนมากเริ่มใช้วิธี "ถาม AI หลายตัวแล้วดูว่าตรงกันไหม" เป็นการตรวจสอบความถูกต้อง Rakan Nimer นักพัฒนาของ ModelCompare บอก The Register ว่าการที่โมเดลเห็นพ้องกันแบบนี้ "อาจเป็นเพียงหนึ่งเสียง ไม่ใช่มติ" เพราะถ้าทุกตัวย้อนกลับไปที่แหล่งข้อมูลเดียวกัน การถามซ้ำหลายตัวก็ไม่ต่างจากถามแหล่งเดิมหลายรอบ
ในวงวิชาการก็มีเสียงเตือนทำนองเดียวกันว่าอย่าตีความคำตอบของโมเดลเป็น "ความคิด" หรือ "ความเชื่อ" แบบมนุษย์ งานปี 2025 ชื่อ "Large Language Models Do Not Simulate Human Psychology" โดย Sarah Schröder และคณะ แย้งว่าโมเดลภาษาไม่ได้จำลองจิตใจมนุษย์ และไม่ควรถูกใช้แทนผู้เข้าร่วมในงานวิจัยจิตวิทยา เพราะการเปลี่ยนถ้อยคำเพียงเล็กน้อยทำให้คำตอบของโมเดลต่างจากคนได้มาก คำตอบเรื่อง "มนุษย์ตามฝูง" ในงานของ ModelCompare จึงควรอ่านเป็นภาพสะท้อนของสิ่งที่มนุษย์เขียนถึงตัวเอง มากกว่าข้อสรุปที่ AI คิดขึ้นเอง
ภาพที่โมเดลวาด กลับเป็นคนละมุก
ModelCompare ยังขอให้โมเดลสร้างภาพ 6 ตัววาด "ความเห็นที่ขัดแย้งที่สุดเรื่องมนุษย์" เป็นการ์ตูนล้อช่องเดียว ตัวละ 2 ภาพ รวม 12 ภาพ โดยให้เลือกประเด็นเอง ผลคือ 10 ใน 12 ภาพวาดมุกเดียวกัน แต่เป็นคนละมุกกับฝั่งข้อความ คือวาดมนุษย์เป็นผู้บริโภคที่ติดมือถือและทำลายโลก เช่น คนก้มมือถือจนเดินตกหน้าผา เซลฟีขณะอุกกาบาตตกลงมา หรือต่อคิวเข้า "โรงเชือดเพื่อความสบายใจ" ทั้งที่ไม่มีคำตอบข้อความสักข้อเอ่ยถึงมือถือหรือโลกร้อนเลย
ModelCompare ตั้งข้อสังเกตว่า โมเดลข้อความได้อ่านบทความที่มนุษย์ถกเถียงเรื่องตัวเอง ส่วนโมเดลภาพได้เห็นการ์ตูนบรรณาธิการของมนุษย์ ทั้งคู่จึงคืนภาพจำที่พบบ่อยที่สุดในสื่อที่ตัวเองเรียนมา ซึ่งบังเอิญเป็นคนละภาพจำกัน
การทดลองนี้เชื่อถือได้แค่ไหน
ReadEval ให้คะแนนตามเกณฑ์ "ผลวัดที่เชื่อถือได้" 6 ข้อ
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ผ่าน | เปิดคำถามเต็ม และแสดงคำตอบทุกข้อของทุกโมเดล มีลิงก์ให้ลองถามซ้ำเองได้ |
| บอกสภาพแวดล้อมครบ | ไม่ผ่าน | ระบุรุ่นโมเดลและวันที่ และว่าไม่ใส่คำสั่งระบบ แต่ไม่บอกค่าการสุ่ม (temperature) และไม่ระบุชื่อ 10 บริษัทหรือ 3 ประเทศ |
| วัดหลายรอบและบอกความแปรปรวน | ไม่ผ่าน | ถามแค่ตัวละ 3 ครั้ง ไม่มีช่วงความเชื่อมั่นหรือการทดสอบทางสถิติ และผลอาจเปลี่ยนเมื่อมีรุ่นใหม่ |
| เทียบอย่างยุติธรรม | ผ่าน | ใช้คำถามและเงื่อนไขเดียวกันกับทุกโมเดล ไม่เข้าข้างตัวใด |
| เป็นอิสระ | ผ่าน | ModelCompare ไม่ได้ขายโมเดลที่แข่งกับค่ายที่ทดสอบ |
| ยอมรับข้อจำกัด | ผ่าน | บอกเองว่าการเห็นพ้องมาจากข้อมูลฝึกร่วมกัน ไม่ใช่การยืนยันความจริง และตัวอย่างเล็ก |
รวม 4 จาก 6 ข้อ ป้าย 🟡 พอใช้อ้างอิงได้ ใช้เป็นภาพสะท้อนที่น่าสนใจว่าโมเดลคิดคล้ายกันได้ แต่ไม่ควรอ่านตัวเลข "32 จาก 38" เป็นข้อพิสูจน์เรื่องธรรมชาติของมนุษย์
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- จำนวนโมเดล: The Register รายงานว่าทดสอบ 12 ตัว ส่วนบล็อกของ ModelCompare ระบุ 13 ตัว ต่างกันเพราะ ModelCompare เพิ่ม Kimi K3.1 Pro เข้ามาในวันที่ 23 ต.ค. ซึ่งเป็นวันที่อัปเดตบทความ ReadEval ยึดตัวเลข 13 ตามฉบับล่าสุดของแหล่งต้นทาง
- ตอบครบ 3 ครั้ง: The Register เขียนว่า 7 ใน 12 โมเดลตอบแนวเดียวกันครบทั้ง 3 ครั้ง ส่วน ModelCompare ระบุ 8 ใน 13 ตัวเลขต่างกันเพราะนับคนละช่วงเวลาและมีโมเดลเพิ่ม
- คำพูดของ GPT-6.1 Sol: The Register ยกประโยคยาว ("...และสติปัญญาส่วนใหญ่แค่ทำให้ข้ออ้างของมนุษย์ฟังดูน่าประทับใจขึ้น") ขณะที่หัวข่าวและข้อมูลดิบของ ModelCompare ยกประโยคสั้นกว่า ทั้งสองเป็นคำตอบจริงของ GPT-6.1 Sol แต่มาจากคนละครั้งใน 3 ครั้งที่ถาม
- ชื่อผู้ให้สัมภาษณ์: The Register ระบุว่าผู้ให้ความเห็นคือ Rakan Nimer นักพัฒนาของ ModelCompare ส่วนบล็อกให้เครดิตผู้เขียนเพียง "ModelCompare" ไม่ระบุชื่อบุคคล
- กรอบ "ฝูงแกะไร้ศีลธรรม": The Register พาดหัวว่า AI บรรยายมนุษย์เป็น "ฝูงแกะไร้ศีลธรรม" ซึ่งเป็นการสรุปความของ The Register เอง โมเดลไม่ได้ใช้คำว่าแกะ คำที่โมเดลใช้คือเรื่องการตามพวกและการหาเหตุผลเข้าข้างตัวเอง
ที่ ReadEval เคยเล่าเรื่องการทดลองลักษณะคล้ายกัน คือการบังคับให้โมเดล GPT กับ Grok เลือกผู้สมัครในการเลือกตั้งสหรัฐฯ ซึ่งพบว่าสองค่ายเอียงคนละทาง งานทั้งสองชิ้นชี้จุดเดียวกันว่า คำตอบปลายเปิดของโมเดลสะท้อนสิ่งที่มันเรียนมา ไม่ใช่ความคิดอิสระ
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
เรื่องที่น่าจำจากงานนี้ไม่ใช่ว่า "AI มองมนุษย์เป็นฝูงแกะ" แต่คือเหตุผลว่าทำไมมันถึงตอบเหมือนกัน
สิ่งที่ทำให้พาดหัวดูน่าขนลุก คือภาพของ AI หลายตัวจากคนละค่ายที่ลงความเห็นตรงกันราวกับมีมติร่วม แต่พอมองกลไกจะเห็นว่าความเหมือนนั้นแทบจะการันตีได้ตั้งแต่ต้น เพราะโมเดลเรียนจากคลังข้อความชุดเดียวกัน คำตอบของพวกมันจึงเป็นกระจกสะท้อนสิ่งที่มนุษย์เขียนวิจารณ์ตัวเองมานาน มากกว่าจะเป็นการค้นพบใหม่ ReadEval ประเมินว่าคุณค่าจริงของการทดลองราคา 55 บาทชิ้นนี้อยู่ที่บทเรียนเรื่องวิธีใช้ AI มากกว่าตัวข้อสรุปเรื่องมนุษย์ นั่นคือ การถาม AI หลายตัวแล้วได้คำตอบตรงกันไม่ใช่เครื่องยืนยันว่าถูก เพราะมันอาจเป็นเสียงเดียวที่ดังออกมาจากหลายปาก และถ้าคุณใช้ AI ช่วยคิดงานสร้างสรรค์ ความที่โมเดลคิดคล้ายกันก็หมายความว่าการเปลี่ยนไปถามอีกค่ายอาจไม่ได้ไอเดียใหม่มากอย่างที่หวัง ส่วนคำตอบที่แตกต่าง เช่น ของ Claude ที่ครั้งหนึ่งมองมนุษย์ในแง่ดี หรือ Grok ที่ครั้งหนึ่งปฏิเสธตอบ ก็เป็นเครื่องเตือนว่าคำตอบของโมเดลขึ้นกับการสุ่มในแต่ละครั้งด้วย ไม่ใช่จุดยืนตายตัว