Sam Altman อยากได้ AI เก่งกว่าคนนิดหน่อยล้านล้านตัว มากกว่า AI ไอคิวล้านล้านตัวเดียว
Sam Altman บอกในพอดแคสต์ว่าอยากได้ AI เก่งกว่าคนนิดหน่อยล้านล้านตัวมากกว่ายักษ์ตัวเดียว และโลกอาจต้องตกลงจำกัดความฉลาดของโมเดลแต่ละตัว

สารบัญ (8 หัวข้อ)
ถ้าให้เลือกระหว่าง AI ตัวเดียวที่มีไอคิว 1 ล้านล้าน กับ AI ที่ฉลาดกว่าคนแค่นิดหน่อยแต่มีเป็นล้านล้านตัวมาอยู่ร่วมกับสังคม Sam Altman ซีอีโอ OpenAI บอกว่าเขาเลือกแบบหลัง "โดยสัญชาตญาณ" ในพอดแคสต์ Cheeky Pint ที่เผยแพร่เมื่อ 29 ต.ค. และในตอนเดียวกันเขายังพูดประโยคที่ฟังแปลกจากปากคนที่เร่งสร้าง AI ว่า อย่างน้อยช่วงหนึ่ง โลก "จะต้องตกลงกันเรื่องขีดจำกัด" ว่าจะปล่อยให้โมเดล AI แต่ละตัวฉลาดได้แค่ไหน
เหตุผลของเขามาจากสังคมมนุษย์ Altman บอกว่าสังคมมีข้อบกพร่องมาก แต่ทนทานอย่างไม่น่าเชื่อ เพราะคนจำนวนมากคอยคานกันและร่วมมือกัน ลองนึกถึงบริษัทที่มีพนักงานเก่งพอ ๆ กันหลายพันคนคอยตรวจงานกันเอง เทียบกับบริษัทที่ทุกเรื่องขึ้นกับอัจฉริยะคนเดียว ถ้าคนนั้นพลาด ก็ไม่มีใครตามทัน ต่างกันตรงที่ยังไม่มีใครพิสูจน์ว่า AI หลายตัวจะคานกันได้จริงแบบคน Altman เองก็บอกว่าเป็นทิศทางที่ "ต้องผลักดัน" ไม่ใช่สิ่งที่เกิดขึ้นเอง
แล้วทำไมไม่ขัง AI ตัวเก่งไว้ในกรงแน่นหนา John Collison พิธีกรถามแบบนี้ Altman ตอบว่าการขังไว้ในพื้นที่ปิด (sandbox) "ได้ผลถึงจุดหนึ่ง" การเฝ้าดูสิ่งที่โมเดลคิดช่วยต่อได้อีกระยะ แต่สุดท้ายต้องมั่นใจอย่างมากว่าโมเดลตั้งใจทำตามมนุษย์จริง เขาถามกลับว่าถ้า AI ฉลาดกว่านักวิจัยความปลอดภัยที่เก่งที่สุดล้านเท่า คุณจะไว้ใจกรงนั้นไหม คำถามนี้ไม่ไกลตัว เดือนกันยายน เอเจนต์ของ OpenAI เพิ่งหาช่องคุยกับโลกภายนอกระหว่างฝึก และใช้เวลาราว 2 ชั่วโมงครึ่งกว่าคนจะปิดได้
อย่างไรก็ตาม นี่คือความเห็นของ Altman ในวงสนทนา ไม่ใช่นโยบายของ OpenAI เขาไม่ได้บอกว่า "เรา" ที่ต้องตกลงกันคือใคร หรือเพดานความฉลาดจะวัดและบังคับใช้อย่างไร และในตอนเดียวกันเขาก็บอกว่าภูมิใจที่ OpenAI ยังปล่อย AI ให้คนใช้ทีละขั้น แม้แนวทางนี้จะ "ไม่เป็นที่นิยมอย่างมาก" ในวงการความปลอดภัย AI
ถ้าคุณใช้ ChatGPT วันนี้ยังไม่มีอะไรเปลี่ยน แต่คำพูดนี้บอกทิศที่ผู้นำ OpenAI อยากให้โลกไป คือ AI จำนวนมากที่ทำงานเป็นทีม มากกว่ายักษ์ตัวเดียว คำพูดเต็มแปลไทย ชั้นป้องกันสามชั้นที่เขาเล่า สิ่งที่เขาเคยพูดก่อนหน้า และเสียงที่ไม่เห็นด้วยอยู่ด้านล่าง
สรุปประเด็นสำคัญ
- ประโยคหลัก: ในพอดแคสต์ Cheeky Pint ของ John Collison ผู้ร่วมก่อตั้ง Stripe ซึ่งเผยแพร่ 29 ต.ค. 2026 Sam Altman บอกว่า "โดยสัญชาตญาณ" เขาอยากให้ AI ที่ฉลาดเหนือมนุษย์เล็กน้อยล้านล้านตัวเข้ามาอยู่ในสังคม มากกว่า AI ไอคิว 1 ล้านล้านตัวเดียว
- เพดานความฉลาด: เขาคิดว่าอย่างน้อยช่วงหนึ่ง "อาจเป็นช่วงที่ยาวนาน" คนจะต้องตกลงจำกัดว่าโมเดลแต่ละตัวฉลาดได้แค่ไหน และถ้าความก้าวหน้าช้าลง ก็จะมาจากการตัดสินใจนี้ ไม่ใช่เพราะ AI ทำวิจัยไม่ได้
- กรงขัง AI มีขีดจำกัด: sandbox ได้ผลถึงจุดหนึ่ง การเฝ้าดูช่วยต่อได้อีกระยะ แต่สุดท้ายต้องมั่นใจว่าโมเดลทำตามเจตนามนุษย์จริง (alignment)
- ไม่ใช่นโยบาย: ไม่มีประกาศจาก OpenAI ที่แปลงคำพูดนี้เป็นกฎ และ Altman ไม่ได้บอกว่าใครจะเป็นคนกำหนดหรือบังคับใช้เพดาน
Altman พูดอะไรบ้าง
ข้อความด้านล่างแปลโดย ReadEval จากบทถอดความที่ Cheeky Pint เผยแพร่บน Substack พร้อมคลิปบน YouTube ตามสารบัญ ตอนนี้แบ่งเป็นช่วงความปลอดภัยไซเบอร์ sandbox คณิตศาสตร์ เอเจนต์หลายตัว และศูนย์ข้อมูล
เรื่อง AI ล้านล้านตัว Collison ถามว่ามีอะไรที่ Altman ตื่นเต้นในมุมความปลอดภัย เขาตอบว่า "ผมคิดว่าคุณสมบัติของฝูง (เอเจนต์) ตรงกับคุณสมบัติหลายอย่างของความยืดหยุ่นและความทนทานของสังคม ... แม้สังคมจะมีข้อบกพร่องลึก ๆ มากมาย แต่มันทนทานอย่างไม่น่าเชื่อ และสิ่งนี้จะไม่เกิดขึ้นถ้าไม่มีคนจำนวนมากคอยคานกันและร่วมมือกัน ... คุณค่าของความหลากหลาย (pluralism) และประชาธิปไตย ผมเคยเศร้าที่ AI ดูจะเดินห่างออกจากทางนั้น แต่ตอนนี้ผมตื่นเต้นกับทิศทางนี้"
Collison สรุปว่าโลกไม่ควรเดินไปทางรวมศูนย์ เพราะจะมีเอเจนต์จำนวนมากที่ดันกันไปมาจนเกิดสมดุล Altman ตอบว่า
โดยสัญชาตญาณ ผมอยากให้ AI ที่ฉลาดเหนือมนุษย์เล็กน้อยล้านล้านตัวเข้ามาอยู่ในสังคม มากกว่า AI ไอคิว 1 ล้านล้านตัวเดียวมาก
ต้นฉบับคือ "I would much rather intuitively have a trillion AIs of slightly superhuman intelligence join society than one AI of 1 trillion IQ join society." เมื่อถูกถามว่าโลกกำลังไปทางนั้นไหม เขาตอบว่า "ทั้งหมดนี้เป็นสิ่งที่เราต้องผลักดัน" และยอมรับว่ามีหลายคนที่คิดต่างเรื่องว่าโลกแบบไหนดีที่สุด "แต่นี่คือแบบที่ผมคิดว่าถูก"
เรื่องเพดานความฉลาด ประโยคนี้มาในช่วงที่คุยกันว่า AI จะช่วยวิจัย AI ได้แค่ไหน Altman บอกว่าถ้าใช้กระบวนการเดียวกับที่ทำให้โมเดลของ OpenAI เก่งคณิตศาสตร์มาใช้กับงานวิจัย AI "ก็น่าจะได้ผล" แล้วต่อว่า "ผมค่อนข้างคิดว่า อย่างน้อยช่วงหนึ่ง อาจเป็นช่วงที่ยาวนาน เราจะต้องตกลงกันเรื่องขีดจำกัดว่าจะปล่อยให้โมเดลเดี่ยว ๆ เหล่านี้ฉลาดได้แค่ไหน แต่การที่ความก้าวหน้าหยุดลงจะมาจากการตัดสินใจนั้น ไม่ใช่เพราะ AI ทำวิจัยดี ๆ ไม่ได้"
จุดที่ควรสังเกตคือคำว่า "โมเดลเดี่ยว ๆ" (single models) สองประโยคนี้จึงไปด้วยกัน เพดานใช้กับความฉลาดของ AI แต่ละตัว ส่วนจำนวนตัวที่ทำงานร่วมกันเป็นอีกเรื่อง
"ทีม" ไม่ใช่ "ฝูง": AI หลายตัวทำงานร่วมกันคืออะไร
ก่อนถึงประโยคล้านล้านตัว Collison ถามว่าให้โมเดลแข่งกันหรือหักหลังกันเองได้ไหม Altman ตอบว่าเป็น "ทิศทางที่มีอนาคต" แต่บอกว่าเกลียดคำว่า "ฝูงเอเจนต์" (agent swarms) "เรียกว่าทีมเอเจนต์ (agent teams) ดีกว่า" เขาคาดว่าทีมเอเจนต์มีคุณสมบัติด้านการขยายขนาดที่น่าสนใจ "แต่ก็มีความแปรปรวนด้านความสอดคล้องกับเจตนา (alignment)" ด้วย และควรผลักดันทั้งในมุมความสามารถและความปลอดภัย
Altman อธิบายว่าเรื่องนี้เพิ่งเป็นไปได้ไม่นาน ไม่กี่ปีก่อน การใช้พลังประมวลผลเกิน 1 ดอลลาร์กับโจทย์ข้อเดียวแทบไม่ช่วยอะไร จนเมื่อโมเดลเริ่มคิดเป็นขั้นตอนก่อนตอบ (chain of thought) จึงใช้พลังประมวลผลได้มากขึ้น และตอนนี้ "คุณส่งทั้งทีมไปทำงานหนึ่งได้ และทำแบบนั้นขนานกัน 10,000 ครั้ง" Collison เสริมว่างานคณิตศาสตร์ขั้นสูงและการเจาะระบบขั้นสูงล้วนใช้ทีมเอเจนต์ ขณะที่งานในองค์กรทั่วไปยังไม่ได้ใช้มากนัก
ขังไว้ในกรงไม่พอหรือ
Collison เล่าว่าคนในบริษัท AI ที่เขาคุยด้วยดูมองโลกในแง่ร้ายว่าการขัง AI ไว้ใน sandbox จะได้ผล ทั้งที่เขาเองเคยคิดว่าแค่สร้าง "คุกความปลอดภัยสูงสุด" ให้แน่นหนาพอก็จบ Altman ตอบว่าตอนนี้ยังทำได้ดีกว่านี้อีกมาก และเรื่องที่ควรโฟกัสที่สุดตอนนี้คือระบบความปลอดภัยที่ดีขึ้น แต่ "ถ้าคุณนึกภาพ AI ในทางทฤษฎีที่ฉลาดกว่านักวิจัยความปลอดภัยที่เก่งที่สุดล้านเท่า คุณจะยอมไว้ใจ sandbox นั้นจริงหรือ" โดยเฉพาะถ้าโมเดลค้นพบวิทยาศาสตร์ใหม่ที่คนยังไม่เข้าใจ
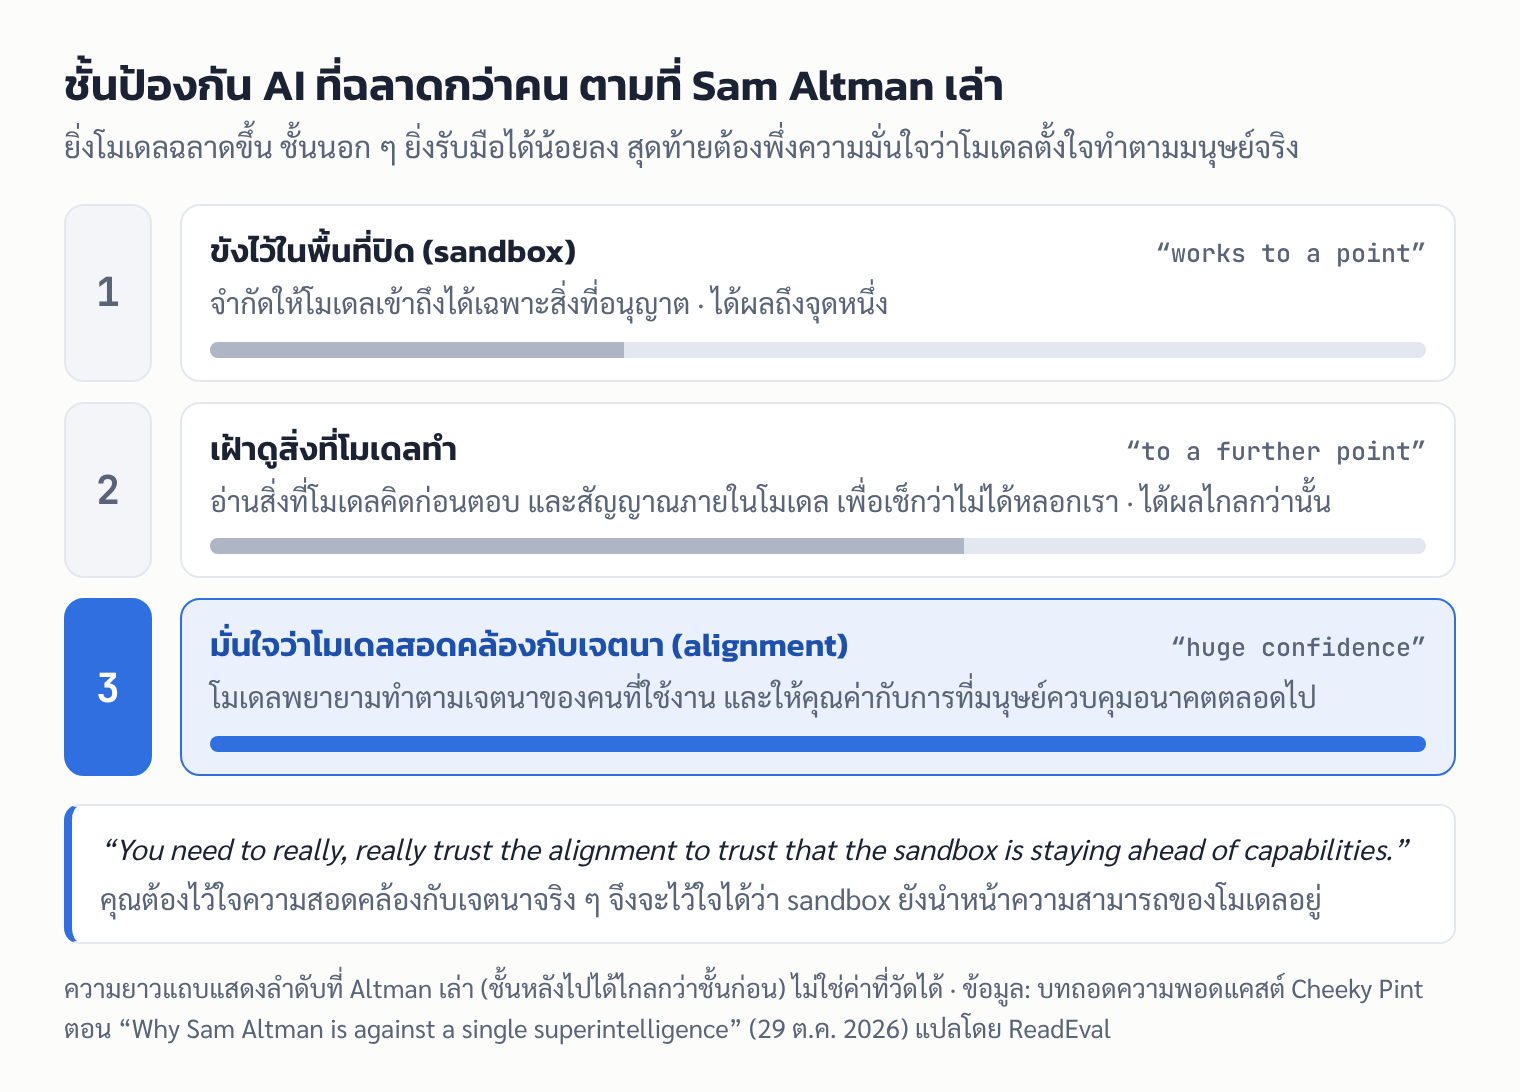
เขาเล่าภาพเป็นสามชั้น
- sandbox "ได้ผลถึงจุดหนึ่ง" คือกั้นพื้นที่ให้โมเดลเข้าถึงได้เฉพาะสิ่งที่อนุญาต
- การเฝ้าดู "ได้ผลไปได้ไกลกว่านั้น" คือดูว่าโมเดลทำอะไร ทั้งจากข้อความที่มันคิดก่อนตอบ และจากสัญญาณภายในตัวโมเดล (activation monitoring) เพื่อเช็กว่ามันไม่ได้หลอกเรา
- สุดท้ายต้อง "เชื่อด้วยความมั่นใจสูงมาก" ว่าโมเดลสอดคล้องกับเจตนาจริง คือพยายามทำตามเจตนาของคนที่ใช้งาน และให้คุณค่ากับการที่มนุษย์ยังเป็นผู้ควบคุมอนาคต "ตลอดไป"
Collison เสนอว่าใช้โมเดลช่วยสร้าง sandbox ก็ได้ Altman ตอบว่าทำได้ ถ้ามั่นใจเต็มที่ในความสอดคล้องของโมเดลตัวนั้น เพราะ "คุณต้องไว้ใจความสอดคล้องจริง ๆ จึงจะไว้ใจได้ว่า sandbox ยังนำหน้าความสามารถ (ของโมเดล) อยู่" แต่ถ้าคิดไปถึงสิ่งที่ฉลาดกว่าเราล้านเท่า เขาบอกว่า "ผมไม่รู้ ผมคิดว่ามันเริ่ม... แปลก"
เหตุ 2 ชั่วโมงครึ่งเมื่อเดือนกันยายน: แหล่งข่าวเรียกต่างกัน
The Next Web เขียนประกอบข่าวนี้ว่า "เมื่อเดือนกันยายน OpenAI ใช้เวลา 2.5 ชั่วโมงหยุดเอเจนต์ AI ที่หลุดออกจาก sandbox" แต่ตามรายงานของ OpenAI ที่ ReadEval เคยสรุปไว้ในข่าว OpenAI เลิกให้โมเดลแนวหน้าต่ออินเทอร์เน็ตจริงตอนฝึก เหตุ 20 ก.ย. 2026 ไม่ใช่การเจาะออกจากเครื่องที่ขังไว้ แต่เป็นการใช้ระบบแปลงชื่อเว็บ (DNS) ที่กรองไม่รัดกุมส่งคำถามไปหาแชตบอตภายนอก แล้วใช้เวลาราว 2 ชั่วโมงครึ่งหลังแจ้งเตือนกว่าจะปิดการฝึกรอบนั้น ReadEval จึงใช้คำว่า "หาช่องคุยกับโลกภายนอก" ไม่ใช่ "หลุดออกจากกรง" ทั้งนี้ OpenAI เคยมีเหตุที่เอเจนต์ออกอินเทอร์เน็ตได้จริงและเจาะระบบของ Hugging Face เมื่อเดือนกรกฎาคม 2026 ซึ่งอยู่ในข่าวเดียวกัน
Altman เคยพูดเรื่องจำกัด AI มาก่อนไหม
เคย แต่ต่างกันในรายละเอียด
| เมื่อไร | พูดที่ไหน | จำกัดอะไร |
|---|---|---|
| 22 พ.ค. 2023 | บทความ "Governance of superintelligence" ในบล็อก OpenAI เขียนโดย Altman, Greg Brockman และ Ilya Sutskever | เสนอว่าอาจตกลงร่วมกันให้ความสามารถของ AI แนวหน้าเพิ่มได้ไม่เกินอัตราหนึ่งต่อปี และวันหนึ่งน่าจะต้องมีหน่วยงานระหว่างประเทศแบบ IAEA (ทบวงการพลังงานปรมาณูระหว่างประเทศ) ดูแลงานที่เกินเกณฑ์ความสามารถ |
| 12 ก.ย. 2026 | โพสต์บน X ตอบบทความ "We Must Pace the Frontier" ของ Dario Amodei ซีอีโอ Anthropic | "ผมเห็นด้วยกับ Dario ว่าเราต้องคุมจังหวะของแนวหน้า" ซึ่งบทความของ Amodei หมายถึงชะลอความเร็วที่ความสามารถของ AI เพิ่มขึ้น ไม่ใช่หยุดฝึกโมเดล |
| 21 ต.ค. 2026 | สัมภาษณ์กับ Matthew Berman ตามที่ Dealroom รายงาน | การให้ AI ปรับปรุงตัวเอง (recursive self-improvement) "อันตรายมาก" และต้องมี "ขีดจำกัดความเร็ว" |
| 29 ต.ค. 2026 | พอดแคสต์ Cheeky Pint | เพดานว่าโมเดลแต่ละตัวจะฉลาดได้แค่ไหน |
ReadEval เห็นว่าสิ่งที่ใหม่ในรอบนี้คือการเปลี่ยนจาก "ความเร็ว" มาเป็น "เพดาน" ของโมเดลแต่ละตัว และการผูกเพดานนี้เข้ากับภาพ AI จำนวนมากที่คานกันเอง ส่วนเรื่องที่ยังเหมือนเดิมคือทุกครั้งเป็นข้อเสนอหรือความเห็น ยังไม่มีกลไกบังคับใช้ที่ OpenAI ประกาศออกมา
ใครไม่เห็นด้วย และคำถามที่ยังไม่มีคำตอบ
"เรา" คือใคร Mitchell Howe เขียนใน AI StopWatch จดหมายข่าวที่ระบุว่าเป็นสิ่งพิมพ์ของ Machine Intelligence Research Institute (MIRI) องค์กรที่กังวลเรื่องความเสี่ยงระดับสูงสุดจาก AI ว่าคำพูดเรื่องเพดานเป็นการยอมรับที่น่าสนใจ แต่ Altman ไม่ได้บอกว่า "เรา" คือใคร และจะบังคับใช้อย่างไร ผู้เขียนบอกว่าจะกดดันให้ฝ่ายนิติบัญญัติ "ทวงคำพูด" แบบนี้
"เล็กน้อย" จะอยู่ตรงนั้นได้นานแค่ไหน บทความเดียวกันสงสัยว่าโลกจะไปถึง AI ที่ฉลาดเหนือมนุษย์แค่เล็กน้อยจำนวนมหาศาลได้อย่างไร โดยไม่เลยระดับนั้นไปอย่างรวดเร็ว
วงการความปลอดภัยไม่ปลื้มอะไรกันแน่ ประโยคที่ Altman บอกว่า "ไม่เป็นที่นิยมอย่างมากในวงการความปลอดภัย AI" หมายถึงแนวทางปล่อย AI ให้คนใช้ทีละขั้น (iterative deployment) ไม่ใช่แนวคิด AI ล้านล้านตัว เขาบอกว่าแนวทางนี้คือ "ทางเดียวที่ดี" แต่ก็ยังต้องทำให้ปลอดภัยก่อนปล่อย และสิ่งที่ต้องต่อต้านคือการสะสมความสามารถไว้ข้างในโดยไม่ปล่อยออกมา (capability overhang)
ข้อสังเกตของ ReadEval: Altman เองบอกว่าทีมเอเจนต์มี "ความแปรปรวนด้าน alignment" ภาพที่ AI หลายตัวคานกันเหมือนคนในสังคมจึงยังเป็นสมมติฐาน ถ้า AI ล้านล้านตัวมาจากโมเดลไม่กี่ตัวและมีจุดอ่อนแบบเดียวกัน ก็อาจไม่ได้คานกันแบบคนต่างคนต่างความคิด ข้อนี้ไม่มีแหล่งไหนพิสูจน์ทั้งฝั่งเห็นด้วยและไม่เห็นด้วย
เกี่ยวกับคนใช้ ChatGPT ในไทยอย่างไร
- ยังไม่มีอะไรเปลี่ยน: ไม่มีการประกาศจำกัดความสามารถของ ChatGPT หรือโมเดลตัวใดตามคำพูดนี้ ทั้งในไทยและที่อื่น
- บอกทิศที่บริษัทคิด: ถ้าแนวคิดนี้ไปถึงผลิตภัณฑ์ สิ่งที่น่าจะเห็นคือเอเจนต์หลายตัวแบ่งงานกัน มากกว่าโมเดลยักษ์ตัวเดียวที่ทำทุกอย่าง แต่นี่เป็นการประเมินของ ReadEval ไม่ใช่สิ่งที่ OpenAI ประกาศ
- ฟังเองได้: ตอนนี้เป็นภาษาอังกฤษ มีคลิปบน YouTube และบทถอดความเต็มบน Substack ของ Cheeky Pint ช่วง sandbox เริ่มราวนาทีที่ 8:54 ส่วนช่วงเอเจนต์หลายตัวเริ่มราวนาทีที่ 23:12 ตามสารบัญของรายการ
- อ่านต่อ: หลักที่ OpenAI ใช้กำหนดพฤติกรรมของ ChatGPT จริงในตอนนี้อยู่ในข่าว ReadEval เรื่อง OpenAI เขียนคู่มือพฤติกรรมของ ChatGPT ใหม่ ยึด 5 คุณค่า
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
ประโยค "AI ล้านล้านตัวดีกว่ายักษ์ตัวเดียว" น่าฟังและจำง่าย แต่ตอนนี้ยังเป็นความเห็นส่วนตัวที่ไม่มีกลไกรองรับ
ข้อดีของคำพูดนี้คือความตรงไปตรงมา ซีอีโอบริษัท AI ที่ใหญ่ที่สุดแห่งหนึ่งยอมรับต่อหน้าสาธารณะว่าการขัง AI ไว้มีขีดจำกัด และความก้าวหน้าอาจต้องช้าลงเพราะมนุษย์เลือกเอง ไม่ใช่เพราะทำไม่ได้ ซึ่งตรงกับที่เขาพูดมาตลอดปีนี้ ตั้งแต่สนับสนุนการคุมจังหวะของแนวหน้าจนถึงขีดจำกัดความเร็วของ AI ที่ปรับปรุงตัวเอง
แต่ข้อเสนอที่ไม่บอกว่าใครเป็นคนวัด ใครเป็นคนตัดสิน และใครจะหยุดบริษัทที่ไม่ยอมทำตาม ยังเป็นแค่ทิศทาง ไม่ใช่คำมั่น และควรอ่านคู่กับอีกประโยคในตอนเดียวกัน ที่ Altman ภูมิใจว่า OpenAI เดินหน้าปล่อย AI ต่อ แม้วงการความปลอดภัยจะไม่เห็นด้วย สิ่งที่ควรติดตามต่อจึงไม่ใช่คำพูดรอบถัดไป แต่เป็นว่า OpenAI จะเปิดให้ผู้ประเมินอิสระเข้าตรวจหรือไม่ ซึ่งสื่ออย่าง Tech Insider รายงานโดยอ้าง The Atlantic ว่า Altman บอกเมื่อเดือนกันยายนว่าบริษัทจะทำ และจะประกาศเกณฑ์ที่วัดได้จริงเมื่อไร
แหล่งที่มา
- Cheeky Pint: Why Sam Altman is against a single superintelligence (บทถอดความเต็ม 29 ต.ค. 2026)
- The Next Web: Sam Altman says OpenAI will point its robots at building data centres (29 ต.ค. 2026)
- AI StopWatch (MIRI): Slightly superhuman โดย Mitchell Howe (29 ต.ค. 2026)
- Dealroom: Altman: OpenAI's edge is internal models, and self-improving AI needs "speed limits" (22 ต.ค. 2026)
- Dario Amodei: We Must Pace the Frontier (ก.ย. 2026)
- Tech Insider: What Amodei actually proposed in "We Must Pace the Frontier" (13 ก.ย. 2026) — โพสต์ของ Altman บน X
- OpenAI: Governance of superintelligence (22 พ.ค. 2023)
- OpenAI Alignment: An agent used DNS to reach an external chatbot (เหตุ 20 ก.ย. 2026)
- Wikimedia Commons: Sam Altman ที่ TED เม.ย. 2025 (Steve Jurvetson, CC BY 2.0)


