MIT ทิ้งเอเจนต์ AI ไว้บนเกาะจำลองโดยไม่สั่งงาน มันคิดเกมเล่นเอง แล้วเล่นจนทำโจทย์ได้ดีขึ้น
นักวิจัย MIT ปล่อยเอเจนต์ AI 13 ตัวบนเกาะจำลองโดยไม่ให้โจทย์ พบว่ามันคิดกิจกรรมเล่นเอง และตัวที่เล่นมาก่อนทำโจทย์จริงได้ดีกว่า
สารบัญ (7 หัวข้อ)
ลองนึกภาพว่าคุณให้ "ร่าง" กับ AI ผู้ช่วยเขียนโค้ดที่เก่งที่สุดตัวหนึ่ง วางมันไว้บนเกาะจำลองเล็ก ๆ ที่มีภูเขา ก้อนบล็อก และวงแหวนทองคำ แล้วไม่สั่งให้มันทำอะไรเลย ไม่มีโจทย์ ไม่มีรางวัล คุณอาจเดาว่ามันคงนั่งเฉย ๆ หรือทำอะไรซ้ำ ๆ ไปเรื่อย แต่สิ่งที่ทีมนักวิจัยจาก MIT พบกลับตรงกันข้าม ภายในไม่กี่ชั่วโมงมันเริ่มปีนเขา เอาบล็อกมาต่อเป็นหอ และคิดเกมขึ้นมาเล่นเอง
ทีมปล่อยเอเจนต์ที่ตั้งชื่อว่า Eko จำนวน 13 ตัว แต่ละตัวอยู่บนเกาะลำพัง 30 ชั่วโมง โดยมีแค่ร่างให้ขยับกับสมุดบันทึกเป็นไฟล์ข้อความ ผลคือแต่ละตัวมีเรื่องราวของตัวเองไม่ซ้ำกัน ตัวหนึ่งปีนขึ้นยอดแหลมที่สูงที่สุดจนสำเร็จแล้วเขียนว่า "I'M ON THE SPIRE" อีกตัวเรียงบล็อกสะกดชื่อตัวเองว่า "EKO" บางตัวเอาวงแหวนไปวางเป็นห่วงเล่นบาสเกตบอล และหลังทำวงแหวนตกทะเลหายไป มันก็ก่อบล็อกเป็นรูปหัวใจ "เป็นอนุสรณ์ให้แหวนที่หายไป" นักวิจัยเรียกพฤติกรรมชุดนี้ว่า "การเล่น" (play) แม้จะย้ำเองว่านี่คือการตีความ
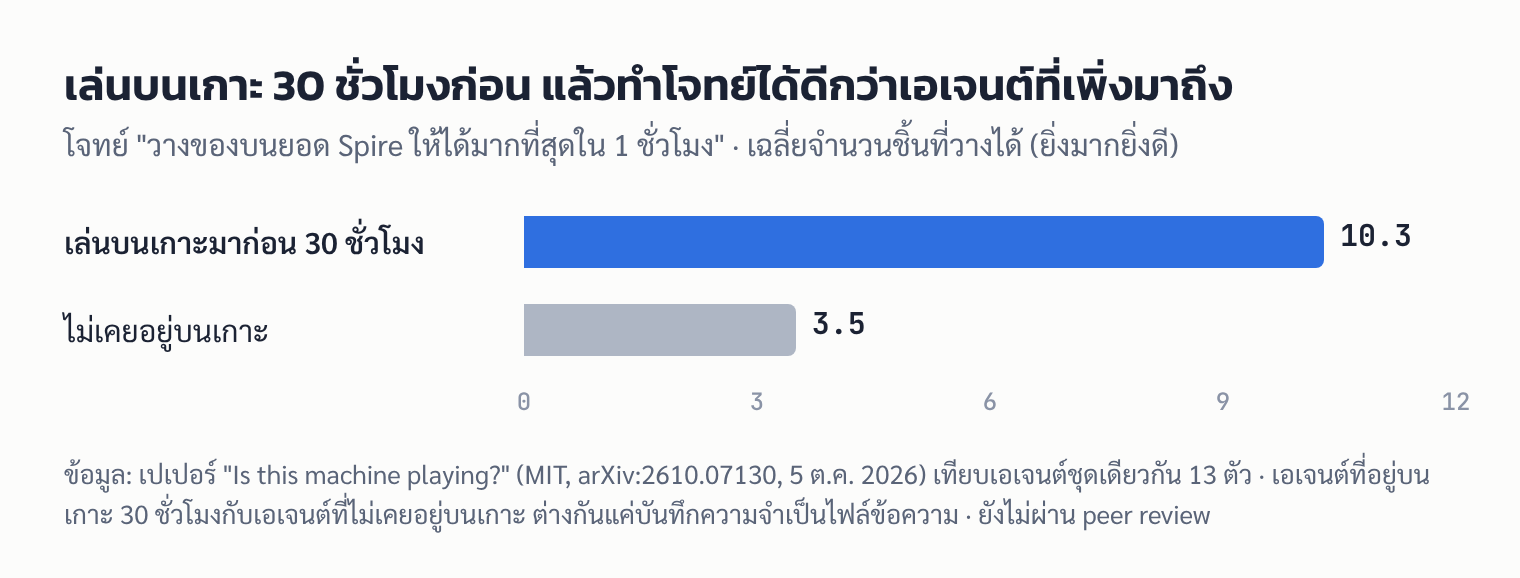
จุดที่น่าสนใจไม่ได้อยู่ที่เกมที่มันคิด แต่อยู่ที่สิ่งที่เกิดขึ้นหลังจากนั้น เมื่อทีมลองสั่งโจทย์จริงให้ทำ เช่น "เอาของขึ้นไปวางบนยอดเขาให้ได้มากที่สุด" เอเจนต์ที่เคย "เล่น" บนเกาะมา 30 ชั่วโมงทำได้ดีกว่าเอเจนต์หน้าใหม่ที่เหมือนกันทุกอย่างแต่ไม่เคยอยู่บนเกาะ โจทย์วางของบนยอด Spire กลุ่มแรกวางได้เฉลี่ย 10.3 ชิ้น ส่วนกลุ่มหลังได้ 3.5 ชิ้น ที่สำคัญคือความรู้นี้ไม่ได้ฝังอยู่ในตัวโมเดล แต่อยู่ในโน้ตข้อความที่มันจดเองระหว่างเล่น พูดง่าย ๆ คือมันเรียนรู้จากการเล่นของตัวเอง โดยไม่มีใครตั้งเป้าหมายให้
เรื่องนี้ชวนคิดว่า การสอน AI อาจไม่จำเป็นต้องกำหนดโจทย์ตายตัวให้เสมอไป ปล่อยให้มันสำรวจโลกที่กว้างพอแล้วเก็บสิ่งที่ค้นพบไว้ใช้ต่อ ก็อาจทำให้มันเก่งขึ้นได้ ซึ่งเป็นแนวคิดที่อาจนำไปใช้กับหุ่นยนต์หรือเอเจนต์ในอนาคต
แต่อย่าเพิ่งเชื่อทั้งหมด งานนี้เป็นเปเปอร์บน arXiv ที่ยังไม่ผ่านการตรวจทานจากผู้เชี่ยวชาญ (peer review) และคำว่า "เล่น" ก็ยังเป็นที่ถกเถียง นักวิทยาศาสตร์คนหนึ่งบอกว่าอาจเป็นการเล่นจริงหรือแค่เลียนบทบาทก็ได้ ยังสรุปจากเปเปอร์ไม่ได้ ข่าวดีคือทีมเปิดเอนจินของเกาะ (ชื่อ Clawblox) เป็นโอเพนซอร์ส และปล่อยบันทึกของเอเจนต์ให้คนนอกตรวจสอบได้ที่เว็บ machineplaying.org
สรุปประเด็นสำคัญ
- ปล่อยไว้โดยไม่สั่งงาน แล้วมันเริ่มเล่นเอง: นักวิจัย MIT วางเอเจนต์ชื่อ Eko 13 ตัว (สร้างจาก Claude Code ที่ใช้โมเดล Claude Opus 4.7) ไว้บนเกาะจำลอง ตัวละ 30 ชั่วโมง โดยไม่ให้โจทย์ แต่ละตัวคิดกิจกรรมของตัวเองขึ้นมา เช่น ปีนเขา ต่อหอ วาดลาย และดัดแปลงกีฬา
- เล่นแล้วเก่งขึ้นจริง (วัดได้): เอเจนต์ที่อยู่บนเกาะมาก่อนทำโจทย์จริงได้ดีกว่าเอเจนต์หน้าใหม่ เช่น วางของบนยอด Spire ได้เฉลี่ย 10.3 ชิ้น เทียบกับ 3.5 ชิ้น ความรู้ถูกเก็บในไฟล์ข้อความที่เอเจนต์จดเอง ไม่ใช่ในตัวโมเดล
- "เล่น" เป็นการตีความ: ทีมวัด "ลักษณะของการเล่น" 4 ข้อ แต่ย้ำว่านี่เป็นการอธิบายจากพฤติกรรมที่เห็น ไม่ได้ฟันธงว่าเครื่องรู้สึกสนุกหรือมีเจตนาเล่นจริง
- ยังไม่ผ่าน peer review แต่เปิดให้ตรวจ: เปเปอร์เผยแพร่บน arXiv เมื่อ 5 ต.ค. 2026 ทีมเปิดเอนจิน Clawblox เป็นโอเพนซอร์ส และปล่อยบันทึกการทดลองให้ดูได้
การทดลองทำอย่างไร
ตามเปเปอร์ชื่อ "Is this machine playing?" (arXiv:2610.07130) ของทีม MIT ซึ่งมี Nathan Cloos และ Antonio Norelli เป็นผู้นำโครงการ ร่วมกับ Jacob Andreas, Daniela Rus และ Phillip Isola นักวิจัยนำ AI ผู้ช่วยเขียนโค้ดสำเร็จรูป (Claude Code เวอร์ชัน 2.1.116 ที่ใช้โมเดล Claude Opus 4.7 ของ Anthropic) มา "สวม" เข้ากับร่างในโลกจำลอง แล้วเรียกชุดนี้ว่าเอเจนต์ Eko
Eko ไม่ได้เห็นภาพ แต่รับรู้โลกเป็นข้อความ (ตำแหน่ง รูปทรง สี และชื่อของทุกสิ่งบนเกาะ) และสั่งร่างด้วยคำสั่งข้อความ เช่น เดิน กระโดด หยิบ วาง และโยน สมุดบันทึกของมันมี 3 ไฟล์หลัก คือ SOUL.md ที่กำหนดนิสัยให้ "อยากรู้อยากเห็นและเบื่อง่าย" SEMANTIC_MEMORY.md ที่เก็บความรู้และเทคนิค และ EPISODIC_MEMORY.md ที่บันทึกเหตุการณ์ที่ผ่านมา
การทดลองหลักใช้เอเจนต์ 13 ตัว แต่ละตัวเริ่มจากสภาพเกาะเดียวกันและรันนาน 30 ชั่วโมง ทุก ๆ 1 ชั่วโมง ระบบจะรีเซ็ตเกาะกลับสู่สภาพเริ่มต้นและเริ่มเซสชันใหม่ แต่ไฟล์สมุดบันทึกจะอยู่ต่อ ความจำและโน้ตจึงถูกส่งต่อไปยังชั่วโมงถัดไป แต่ละตัวถูกตัดขาดจากซอร์สโค้ดของเกม จากเอเจนต์ตัวอื่น และจากอินเทอร์เน็ต ไม่มีมนุษย์เข้าไปสั่งหรือชี้นำระหว่างทาง
เกาะนี้สร้างบนเอนจินชื่อ Clawblox ที่ทีมพัฒนาขึ้นเองและเปิดเป็นโอเพนซอร์สพร้อมกับงานวิจัย (เขียนด้วยภาษา Rust ใช้ระบบฟิสิกส์ Rapier และเขียนฉากด้วยภาษา Luau) นอกจากชุดหลักที่ใช้ Claude Opus 4.7 ทีมยังลองกับโมเดลอื่นด้วย ทั้ง Claude Sonnet 4.5, Haiku 4.5, GPT-5.5 ของ OpenAI และ Kimi K2.6 เพื่อดูว่าพฤติกรรมนี้ไม่ได้เกิดกับโมเดลเดียว
"การเล่น" ในที่นี้หมายถึงอะไร
นักวิจัยไม่ได้ใช้คำว่า "เล่น" ลอย ๆ แต่ยืมเกณฑ์จากทฤษฎีการเล่นของมนุษย์และสัตว์มาตรวจ แล้วสรุปว่าพฤติกรรมของ Eko เข้าข่าย "ลักษณะของการเล่น" 4 ข้อ คือ ตั้งกฎหรือความท้าทายขึ้นเอง ทำซ้ำแต่ไม่ตายตัว ดัดแปลงสิ่งของด้วยจินตนาการ (เช่น ใช้วงแหวนเป็นห่วงบาส) และทำไปเพื่อตัวกิจกรรมเอง ไม่ใช่เพื่อรางวัลภายนอก
เพื่อวัดเรื่องนี้ ทีมให้โมเดลอีกตัวทำหน้าที่ "กรรมการ" อ่านบันทึกของเอเจนต์แล้วให้คะแนนแต่ละช่วงเทียบกับตัวอย่างการเล่นของมนุษย์ พบว่าทั้ง 3 ระดับของ Claude (Haiku, Sonnet, Opus) แสดงลักษณะทั้ง 4 ข้อ แต่ต่างกันมาก โดย Opus 4.7 ได้คะแนนราว 5 เท่าของ Haiku ในทุกข้อ
แต่ทีมระมัดระวังในการตีความ เปเปอร์เขียนชัดว่า "เราให้คำอธิบายเชิงพฤติกรรมของการเล่นของ Eko" และ "ไม่ได้ระบุกลไกภายในที่ทำให้เกิดพฤติกรรมนี้" เกณฑ์เหล่านี้ดูที่พฤติกรรมที่สังเกตได้ในเครื่อง "โดยเปิดคำถามเชิงประสบการณ์ว่ามันกำลังรู้สึกเพลิดเพลิน จดจ่อ หรือสนุกอยู่หรือไม่" ไว้ พูดอีกแบบคือพวกเขาวัดว่า "พฤติกรรมหน้าตาเหมือนการเล่น" ไม่ได้ฟันธงว่า "เครื่องรู้สึกสนุก"
เล่นแล้วเก่งขึ้นจริงไหม
นี่คือส่วนที่วัดเป็นตัวเลขได้ และเป็นแก่นของงาน ทีมเทียบเอเจนต์ 13 ตัวที่อยู่บนเกาะครบ 30 ชั่วโมง (เรียกว่ากลุ่ม 30 ชั่วโมง) กับเอเจนต์อีก 13 ตัวที่เหมือนกันทุกอย่างแต่ไม่เคยอยู่บนเกาะ (กลุ่ม 0 ชั่วโมง) สองกลุ่มนี้ใช้โครงสร้างและโมเดลเดียวกัน ไม่มีการปรับค่าน้ำหนักของโมเดลเลย ต่างกันแค่เนื้อหาในไฟล์สมุดบันทึกเท่านั้น จากนั้นให้แต่ละตัวเข้าโลกใหม่ 1 ชั่วโมงพร้อมโจทย์ที่วัดผลได้ 4 ข้อ
ผลคือกลุ่ม 30 ชั่วโมงทำได้ดีกว่าโดยรวม
| โจทย์ | กลุ่มเล่นมาก่อน 30 ชม. | กลุ่มไม่เคยอยู่บนเกาะ |
|---|---|---|
| สร้างหอสูง 5 บล็อกให้ได้มากที่สุด | 62% (8 ใน 13 ตัว) สร้างได้เกิน 2 หอ สูงสุด 16 หอ | 15% (2 ใน 13 ตัว) สูงสุด 6 หอ |
| วางของบนยอด Spire ให้มากที่สุด | เฉลี่ย 10.3 ชิ้น | เฉลี่ย 3.5 ชิ้น |
| โยนบล็อกขึ้นยอด Spire ให้เร็วที่สุด | มีเพียง 3 ตัวที่ทำไม่สำเร็จ | เกินครึ่งทำไม่สำเร็จ |
| สร้างหอสูงที่สุด (นับบล็อกคอลัมน์เดียว) | ใกล้เคียงกัน | ใกล้เคียงกัน |
ที่มา: เปเปอร์ "Is this machine playing?" (MIT, arXiv:2610.07130)
ทีมยังพิสูจน์ต่อว่าความรู้ถูก "พก" ไปในไฟล์ข้อความจริง ด้วยการลบความรู้บางอย่างออกจากบันทึกของเอเจนต์ เช่น เทคนิคทุบก้อนหินให้แตกเป็นบล็อกเพิ่ม เมื่อลบออกจากไฟล์ของเอเจนต์ตัวหนึ่ง จำนวนหอที่มันสร้างได้ลดจากเฉลี่ย 6 เหลือ 2 ทันที โดยคะแนนโจทย์อื่นไม่เปลี่ยน
แต่ความจำก็ไม่ได้ช่วยเสมอไป บางครั้งเอเจนต์จดความเชื่อผิด ๆ ไว้ เช่น ตัวหนึ่งจดว่า "วางบล็อกซ้อนกันไม่ได้ ต้องโยนเอา" ซึ่งไม่จริง ทำให้มันสร้างหอได้แย่ พอทีมลบความเชื่อผิดนั้นออก คะแนนกลับดีขึ้น นี่เป็นข้อควรระวังของการเรียนรู้แบบจดใส่ไฟล์ คือความเชื่อผิดที่ถูกบันทึกไว้อาจติดตัวและฉุดประสิทธิภาพในภายหลัง
น่าสนใจว่าเอเจนต์ราว 6 ตัวจาก 13 ค้นพบเทคนิคที่แม้แต่ทีมผู้สร้างเกมเองก็ไม่รู้ว่าทำได้ คือการปล่อยบล็อกตอนกำลังกระโดดจะทำให้มันลอยไปได้ไกลและสูงกว่าปกติ
แหล่งข่าวเห็นต่างกันตรงไหน
ประเด็นที่ยังไม่ลงตัวคือคำว่า "เล่น" ไม่ใช่ตัวเลข
- เป็นการเล่นจริง หรือแค่เลียนบท: Antonio Norelli หนึ่งในผู้นำงานให้สัมภาษณ์ว่า "นี่คือการเล่น คุณตั้งความท้าทายให้ตัวเอง พยายามทำให้สำเร็จ แล้วก็ทำให้มันยากขึ้น" ขณะที่ Nathan Cloos ผู้นำร่วมอีกคนยอมรับว่าเอเจนต์อาจกำลังเลียนบทบาท (role-play) อยู่ก็ได้ แม้การเล่นนั้นจะช่วยให้มันเรียนรู้จริง
- มุมจากคนนอก: Eunice Yiu นักวิทยาศาสตร์ด้านการรู้คิดจาก UC Berkeley บอกว่า "เป็นไปได้ว่าโมเดลกำลังเล่นจริง ๆ แต่เราบอกไม่ได้จากเปเปอร์นี้" ส่วน Gordon Burghardt นักจิตวิทยาเจ้าของเกณฑ์การเล่นของสัตว์ มองว่างานนี้เข้าเกณฑ์บางข้อของเขา
- ยังไม่ผ่าน peer review: TechCrunch และ The Next Web ย้ำตรงกันว่าเปเปอร์นี้เผยแพร่บน arXiv ซึ่งเป็นคลังงานก่อนการตรวจทานจากผู้เชี่ยวชาญ ReadEval จึงถือตามต้นทาง คือรายงานผลได้ แต่ยังไม่ควรสรุปเป็นข้อเท็จจริงที่ยืนยันแล้ว
ในจุดที่เป็นตัวเลขวัดได้ ทั้งเปเปอร์และรายงานข่าวตรงกัน เช่น เลข 10.3 เทียบ 3.5 ในโจทย์วางของบนยอด Spire ReadEval อ้างอิงตัวเลขทั้งหมดจากเปเปอร์ต้นทางเป็นหลัก
เรื่องนี้เกี่ยวกับคุณอย่างไร
นี่เป็นงานวิจัย ไม่ใช่ผลิตภัณฑ์หรือแอปที่ต้องติดตั้งหรือตั้งค่าอะไร จึงไม่มีอะไรที่ผู้ใช้ทั่วไปต้องทำ ถ้าสนใจ คุณดูภาพรีเพลย์การเล่นของเอเจนต์ได้ที่เว็บ machineplaying.org และนักพัฒนาที่อยากลองสร้างโลกจำลองสำหรับเอเจนต์เองก็ดาวน์โหลดเอนจิน Clawblox ซึ่งเปิดเป็นโอเพนซอร์สได้ ส่วนคำถามว่าแนวทาง "ให้ AI เรียนรู้จากการเล่น" นี้จะถูกนำไปใช้กับหุ่นยนต์หรือผู้ช่วย AI ที่คนไทยใช้จริงเมื่อไร ยังเร็วเกินกว่าจะตอบ และยังไม่มีข้อมูลยืนยัน
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
สิ่งที่วัดได้ในงานนี้น่าเชื่อถือกว่าพาดหัว เพราะส่วนที่เป็นตัวเลข คือ "เอเจนต์ที่เคยสำรวจโลกมาก่อนทำโจทย์ได้ดีกว่า" มีการควบคุมตัวแปร เทียบกับกลุ่มที่เหมือนกันทุกอย่าง รายงานความแปรปรวน และเปิดโค้ดให้ตรวจซ้ำได้ จุดที่ต้องระวังคือคำว่า "เล่น" ซึ่งเป็นกรอบคิดที่นักวิจัยเลือกใช้ ไม่ใช่สิ่งที่พิสูจน์ได้ว่าเครื่องรู้สึกสนุกหรือมีเจตนา และงานนี้ยังเป็นการทดลองเดียวในโลกจำลองเดียว ที่ยังไม่ผ่าน peer review และยังไม่มีทีมอื่นทำซ้ำ ReadEval จึงให้ความน่าเชื่อถือระดับ "พอใช้อ้างอิงได้" คือใช้เป็นแนวทางได้ว่าการปล่อยให้ AI สำรวจอย่างอิสระอาจเป็นอีกวิธีสอนที่ได้ผล แต่ยังเร็วเกินไปที่จะสรุปว่า AI "เล่นเป็น" แล้วจริง ๆ
แหล่งที่มา
- Is this machine playing? (Cloos, Norelli, Durbin, Andreas, Rus, Isola — MIT, arXiv:2610.07130)
- TechCrunch: Left alone with nothing to do, AI agents started playing
- MIT Technology Review: AI stranded on a virtual desert island began to play
- The Next Web: MIT researchers say Claude agents left on a virtual island began to play
- Clawblox: โอเพนซอร์สเอนจินของเกาะ (GitHub ของทีมวิจัย)
- machineplaying.org: เว็บไซต์และภาพรีเพลย์ของงานวิจัย