OpenAI เปิดข้อมูลการใช้ ChatGPT ทำงานเกือบ 100 ประเทศ คนอเมริกันใช้ช่วยตัดสินใจมากสุด
OpenAI จัดข้อความเรื่องงานใน ChatGPT เป็น 165 ประเภทงาน ในสหรัฐฯ ช่วยตัดสินใจมากสุด 21.6% แต่เป็นข้อมูลที่วัดสินค้าตัวเอง และยังยืนยันไม่ได้ว่ามีไทย

สารบัญ (11 หัวข้อ)
- สรุปประเด็นสำคัญ
- Signals คืออะไร และข้อมูลรอบนี้นับอะไรบ้าง
- OpenAI จัดหมวดข้อความอย่างไร
- คนอเมริกันและคนเยอรมันใช้ ChatGPT ทำงานอะไร
- ประเทศอื่นเป็นอย่างไร
- ChatGPT ถูกใช้ต่างจากงานจริงในเศรษฐกิจแค่ไหน
- มีข้อมูลของไทยไหม
- ถ้าอยากเปิดดูเอง หรือไม่อยากให้แชตถูกนับ
- สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- ความน่าเชื่อถือของข้อมูล
- บทวิเคราะห์จาก ReadEval
ถ้าให้เดาว่าคนทำงานพิมพ์อะไรใส่ ChatGPT บ่อยที่สุด หลายคนคงตอบว่าให้ช่วยเขียนอีเมลหรือเขียนโค้ด แต่ข้อมูลชุดใหม่ที่ OpenAI เปิดเผยกลับชี้ว่า ในสหรัฐฯ งานที่ผู้ใช้ขอมากที่สุดคือให้ AI ช่วยตัดสินใจและแก้ปัญหา คิดเป็นราว 1 ใน 5 ของข้อความเรื่องงานทั้งหมด ส่วนในเยอรมนีและเกาหลีใต้ หมวดนี้ก็อยู่อันดับหนึ่งเช่นกัน
ข้อมูลนี้เป็นส่วนหนึ่งของ OpenAI Signals โครงการเปิดข้อมูลการใช้ ChatGPT ของบริษัท รอบนี้ OpenAI นำข้อความเรื่องงานของผู้ใช้บัญชีส่วนตัวในเกือบ 100 ประเทศ มาจัดเข้า 165 ประเภทงาน ตามฐานข้อมูลอาชีพของกระทรวงแรงงานสหรัฐฯ (O*NET) นึกถึงห้องคัดแยกจดหมายที่ลบชื่อและที่อยู่บนซองออกก่อน แล้วให้เครื่องอ่านเนื้อความและหย่อนแต่ละฉบับลงช่องเดียว สิ่งที่ประกาศคือแต่ละช่องมีจดหมายกี่เปอร์เซ็นต์ ไม่มีตัวจดหมาย ต่างจากห้องคัดแยกจริงตรงที่ข้อความหนึ่งมักเข้าได้หลายช่อง และในการทดสอบของ OpenAI เอง แม้แต่คนสองคนก็ยังคัดข้อความเดียวกันลงคนละช่องอยู่บ่อย ๆ
ยังไม่จบแค่นั้น ในรอบปีที่ผ่านมา คนอเมริกันใช้ ChatGPT ช่วยคิดงานสร้างสรรค์และช่วยร่างคำแนะนำไปให้คนอื่นมากขึ้น ขณะที่งานประเภทสั่งการหรือจัดการคอมพิวเตอร์ลดลงชัดเจน และเมื่อดูรวมหลายสิบประเทศ งานยอดนิยมกลุ่มบนสุดกินสัดส่วนน้อยลง พูดง่าย ๆ คือคนเอา ChatGPT ไปใช้กับงานที่หลากหลายขึ้น
ข้อมูลนี้มาจากการใช้งานจริง ไม่ใช่แบบสอบถาม แต่ต้องอ่านอย่างระวัง นี่คือ OpenAI วัดสินค้าของตัวเอง ตัวเลขเป็นสัดส่วนของคำขอ ไม่ได้บอกว่าใช้มากขึ้นหรือทำงานได้ดีขึ้น ไม่นับบัญชีองค์กรและเครื่องมือเขียนโค้ด Codex และคนนอกตรวจการจัดหมวดซ้ำไม่ได้ ReadEval จึงให้ระดับ "พอใช้อ้างอิงได้"
สำหรับคนไทย มีรายงานว่าข้อมูลชุดอื่นของ Signals มีไทยอยู่แล้ว แต่ ReadEval ยังยืนยันไม่ได้ว่ากราฟประเภทงานชุดนี้มีไทยให้เลือก เพราะหน้าเว็บของ OpenAI ไม่เปิดให้ระบบของเราเข้าอ่าน คุณลองเปิดกราฟแล้วเลือกประเทศเองได้ และถ้าไม่อยากให้แชตของคุณถูกนับในข้อมูลแบบนี้ ให้ปิดตัวเลือก "Improve the model for everyone" ด้านล่างมีวิธีที่ OpenAI จัดหมวด ตัวเลขรายประเทศ และขั้นตอนทีละข้อ
สรุปประเด็นสำคัญ
- เกิดอะไรขึ้น: 26 ต.ค. 2026 ทีมวิจัยเศรษฐศาสตร์ของ OpenAI เปิดข้อมูล OpenAI Signals v3.0 พร้อมบทความ "ChatGPT's expanding world of work" ที่จัดข้อความเรื่องงานใน ChatGPT เป็น 165 ประเภทงานตาม O*NET รายไตรมาส ตั้งแต่ไตรมาส 1 ปี 2025 ถึงไตรมาส 3 ปี 2026 ครอบคลุมเกือบ 100 ประเทศ
- ผลหลัก: ในสหรัฐฯ หมวด "ตัดสินใจและแก้ปัญหา" ใหญ่ที่สุดที่ 21.6% ของคำขอเรื่องงาน (ไตรมาส 1 ปี 2026) หมวดให้คำปรึกษาผู้อื่นเพิ่มจาก 5.5% เป็น 9.0% ส่วนหมวดทำงานกับคอมพิวเตอร์ลดจาก 11.7% เหลือ 6.7%
- ใช้กับงานหลากหลายขึ้น: ใน 74 ประเทศที่มีข้อมูลครบทุกไตรมาส งานสิบอันดับแรกลดจาก 56.0% เหลือ 51.1% ของข้อความเรื่องงาน
- ข้อจำกัดและความน่าเชื่อถือ: นับเฉพาะบัญชีส่วนตัว เป็นสัดส่วนไม่ใช่ปริมาณ ใส่สัญญาณรบกวนเพื่อความเป็นส่วนตัว และยังยืนยันไม่ได้ว่ามีไทยในกราฟประเภทงาน ReadEval ให้ 🟡 พอใช้อ้างอิงได้ (3 จาก 6 ข้อ)
Signals คืออะไร และข้อมูลรอบนี้นับอะไรบ้าง
เอกสารแนะนำ Signals ของ OpenAI ลงวันที่กุมภาพันธ์ 2026 เรียกโครงการนี้ว่าโครงการข้อมูลสาธารณะที่อัปเดตเป็นระยะ เพื่อบอกว่าใครใช้ ChatGPT ใช้ที่ไหน และใช้ทำอะไร บริษัทเขียนไว้ในเอกสารนี้ว่า "เราแชร์รูปแบบ ไม่ใช่ตัวคน" (We share patterns, not people)
ข้อมูลรุ่น v3.0 ที่ออกเมื่อ 26 ต.ค. 2026 มีรายละเอียดตามที่ PPC Land และ Relevant Audience สรุปจากไฟล์และคำอธิบายวิธีการของ OpenAI ดังนี้
| เรื่อง | รายละเอียด |
|---|---|
| ตัวอย่างข้อความ | 1,000,000 ข้อความต่อเดือน ตั้งแต่ ก.ค. 2024 ถึง ก.ย. 2026 (รุ่นนี้เพิ่มตัวอย่างของเดือนเก่าจาก 300,000 เป็น 1,000,000) |
| บัญชีที่นับ | บัญชีส่วนตัวแผน Free, Go, Plus และ Pro ที่ระบุอายุ 18 ปีขึ้นไป |
| ที่ไม่นับ | บัญชีองค์กร (Enterprise), Codex, บัญชีที่ลบไปแล้ว, ผู้ที่เลือกไม่ให้ใช้ข้อมูลฝึกโมเดล, ผู้อายุต่ำกว่า 18 หรือไม่ระบุอายุ |
| ข้อมูลประเภทงาน | 165 ประเภทงาน เกือบ 100 ประเทศ รายไตรมาส ไตรมาส 1 ปี 2025 ถึงไตรมาส 3 ปี 2026 |
| การเผยแพร่ | ไฟล์ CSV 24 ไฟล์ ใช้ต่อได้ภายใต้สัญญาอนุญาต CC BY 4.0 (ต้องอ้างที่มา) |
จุดที่ต้องจำคือตัวเลขทั้งหมดเป็น "สัดส่วน" OpenAI ไม่ได้บอกจำนวนข้อความทั้งหมด ถ้าหมวดหนึ่งมีสัดส่วนลดลง ก็อาจเป็นเพราะหมวดอื่นโตเร็วกว่า ไม่ได้แปลว่าคนใช้หมวดนั้นน้อยลงในจำนวนจริงเสมอไป และข้อมูลนี้ไม่ได้วัดว่างานเสร็จเร็วขึ้นหรือดีขึ้น
OpenAI จัดหมวดข้อความอย่างไร
OpenAI ระบุว่าไม่มีนักวิจัยคนใดอ่านแชต ทุกขั้นทำด้วยระบบอัตโนมัติ เอกสาร Signals และงานวิจัย "How People Use ChatGPT" ของ OpenAI ที่ใช้วิธีเดียวกันอธิบายขั้นตอนไว้ดังนี้
- สุ่มข้อความ จากบัญชีที่เข้าเกณฑ์ เดือนละ 1,000,000 ข้อความ
- ลบข้อมูลที่ระบุตัวบุคคลได้ ในงานวิจัยปี 2025 ขั้นนี้ใช้เครื่องมือภายในชื่อ Privacy Filter ซึ่งเป็นโมเดลภาษา (LLM) อีกตัวหนึ่ง
- ให้โมเดลภาษาจัดหมวด โดยถามทีละเรื่อง ได้แก่ เป็นเรื่องงานหรือไม่ หัวข้ออะไร เป็นการถาม สั่งให้ทำ หรือแค่ระบายความรู้สึก และเฉพาะข้อความเรื่องงาน ตรงกับงานประเภทไหนใน O*NET ในงานวิจัยปี 2025 โมเดลได้อ่านข้อความก่อนหน้า 10 ข้อความเป็นบริบทด้วย เช่น ข้อความ "ขออีก 10 ข้อ" จะเข้าใจได้ก็ต่อเมื่อเห็นคำถามก่อนหน้า
- รวมเป็นสัดส่วนและใส่สัญญาณรบกวน ด้วยเทคนิคความเป็นส่วนตัวเชิงอนุพันธ์ (differential privacy) แล้วซ่อนกลุ่มที่เล็กเกินไป ปัดเศษทศนิยม 3 ตำแหน่ง แล้วจึงเผยแพร่
PPC Land รายงานว่า v3.0 ใช้คำสั่งจัดหมวดชุดเดียวกับงานวิจัยปี 2025 ซึ่งตอนนั้นใช้โมเดล gpt-5-mini แต่หน้าเว็บของ OpenAI รอบนี้ไม่ได้ระบุว่าใช้โมเดลตัวไหน
O*NET กับ 165 ประเภทงาน: ONET เป็นฐานข้อมูลที่กระทรวงแรงงานสหรัฐฯ สนับสนุน แบ่งงานทุกอาชีพเป็นกิจกรรมหลายระดับ ระดับกลางที่เรียกว่า Intermediate Work Activities มี 332 ประเภท (ตามที่งานวิจัยปี 2025 ใช้ ONET รุ่น 29.0) Signals แสดงแยกรายการ 165 ประเภท ส่วนงานที่พบในแชตไม่สม่ำเสมอพอจะถูกรวมไว้ในหมวด "อื่น ๆ" ในกราฟ ประเภทงานย่อยถูกจัดเป็นกลุ่มใหญ่ เช่น "ตัดสินใจและแก้ปัญหา" หรือ "คิดสร้างสรรค์" ซึ่งเป็นตัวเลขที่สื่อนำมารายงาน
ระบบจัดหมวดแม่นแค่ไหน: งานวิจัยปี 2025 ทดสอบตัวจัดหมวดประเภทงานกับข้อความสาธารณะ 100 ข้อความจากชุดข้อมูล WildChat โดยให้คนสองคนจัดหมวดด้วย ผลคือคนสองคนเห็นตรงกันในระดับต่ำ ค่าความสอดคล้อง (kappa) อยู่ราว 0.3 (เนื้อความของรายงานระบุ 0.27 ส่วนตารางในภาคผนวกระบุ 0.37) โดย 0 คือตรงกันพอ ๆ กับการเดา และ 1 คือตรงกันทุกข้อ เมื่อนับโมเดลเป็นผู้จัดหมวดอีกรายหนึ่ง ค่าความสอดคล้องรวมเพิ่มเป็น 0.47 ซึ่งอยู่ระดับปานกลาง แปลว่าโมเดลจัดหมวดได้สอดคล้องกับคนพอ ๆ กับที่คนสอดคล้องกันเอง หรือดีกว่าเล็กน้อย ผู้วิจัยอธิบายว่ามีตัวเลือกให้เลือกมากและข้อความหลายข้อกำกวม เช่น การขอให้ช่วยเขียนเรื่องสั้น อาจนับเป็น "สร้างเนื้อหาบันเทิง" หรือ "เขียนงานเพื่อศิลปะหรือการค้า" ก็ได้ ผลทดสอบนี้เป็นของงานวิจัยปี 2025 OpenAI ไม่ได้เผยผลทดสอบชุดใหม่ของ v3.0
สัญญาณรบกวนมากแค่ไหน: PPC Land รายงานค่า ε (epsilon) ซึ่งเป็นตัวกำหนดระดับความเป็นส่วนตัว โดยหลักการ ค่ายิ่งต่ำยิ่งใส่สัญญาณรบกวนมาก ข้อมูลเดือน ก.ค.–ก.ย. 2026 ใช้ ε = 1, เม.ย.–มิ.ย. 2026 ใช้ 2, ม.ค.–มี.ค. 2026 ใช้ 3 และเดือน ธ.ค. 2025 ลงไปใช้ 5 แปลว่าข้อมูลไตรมาสล่าสุดมีสัญญาณรบกวนมากที่สุด ช่องที่มีน้อยกว่า 100 (หลังถ่วงน้ำหนักและใส่สัญญาณรบกวน) จะถูกซ่อน ส่วนไฟล์ประเภทงานใช้เกณฑ์ขั้นต่ำ 1,000 ต่อไตรมาส หมวดเล็กและประเทศเล็กจึงคลาดเคลื่อนได้มากกว่า
คนอเมริกันและคนเยอรมันใช้ ChatGPT ทำงานอะไร
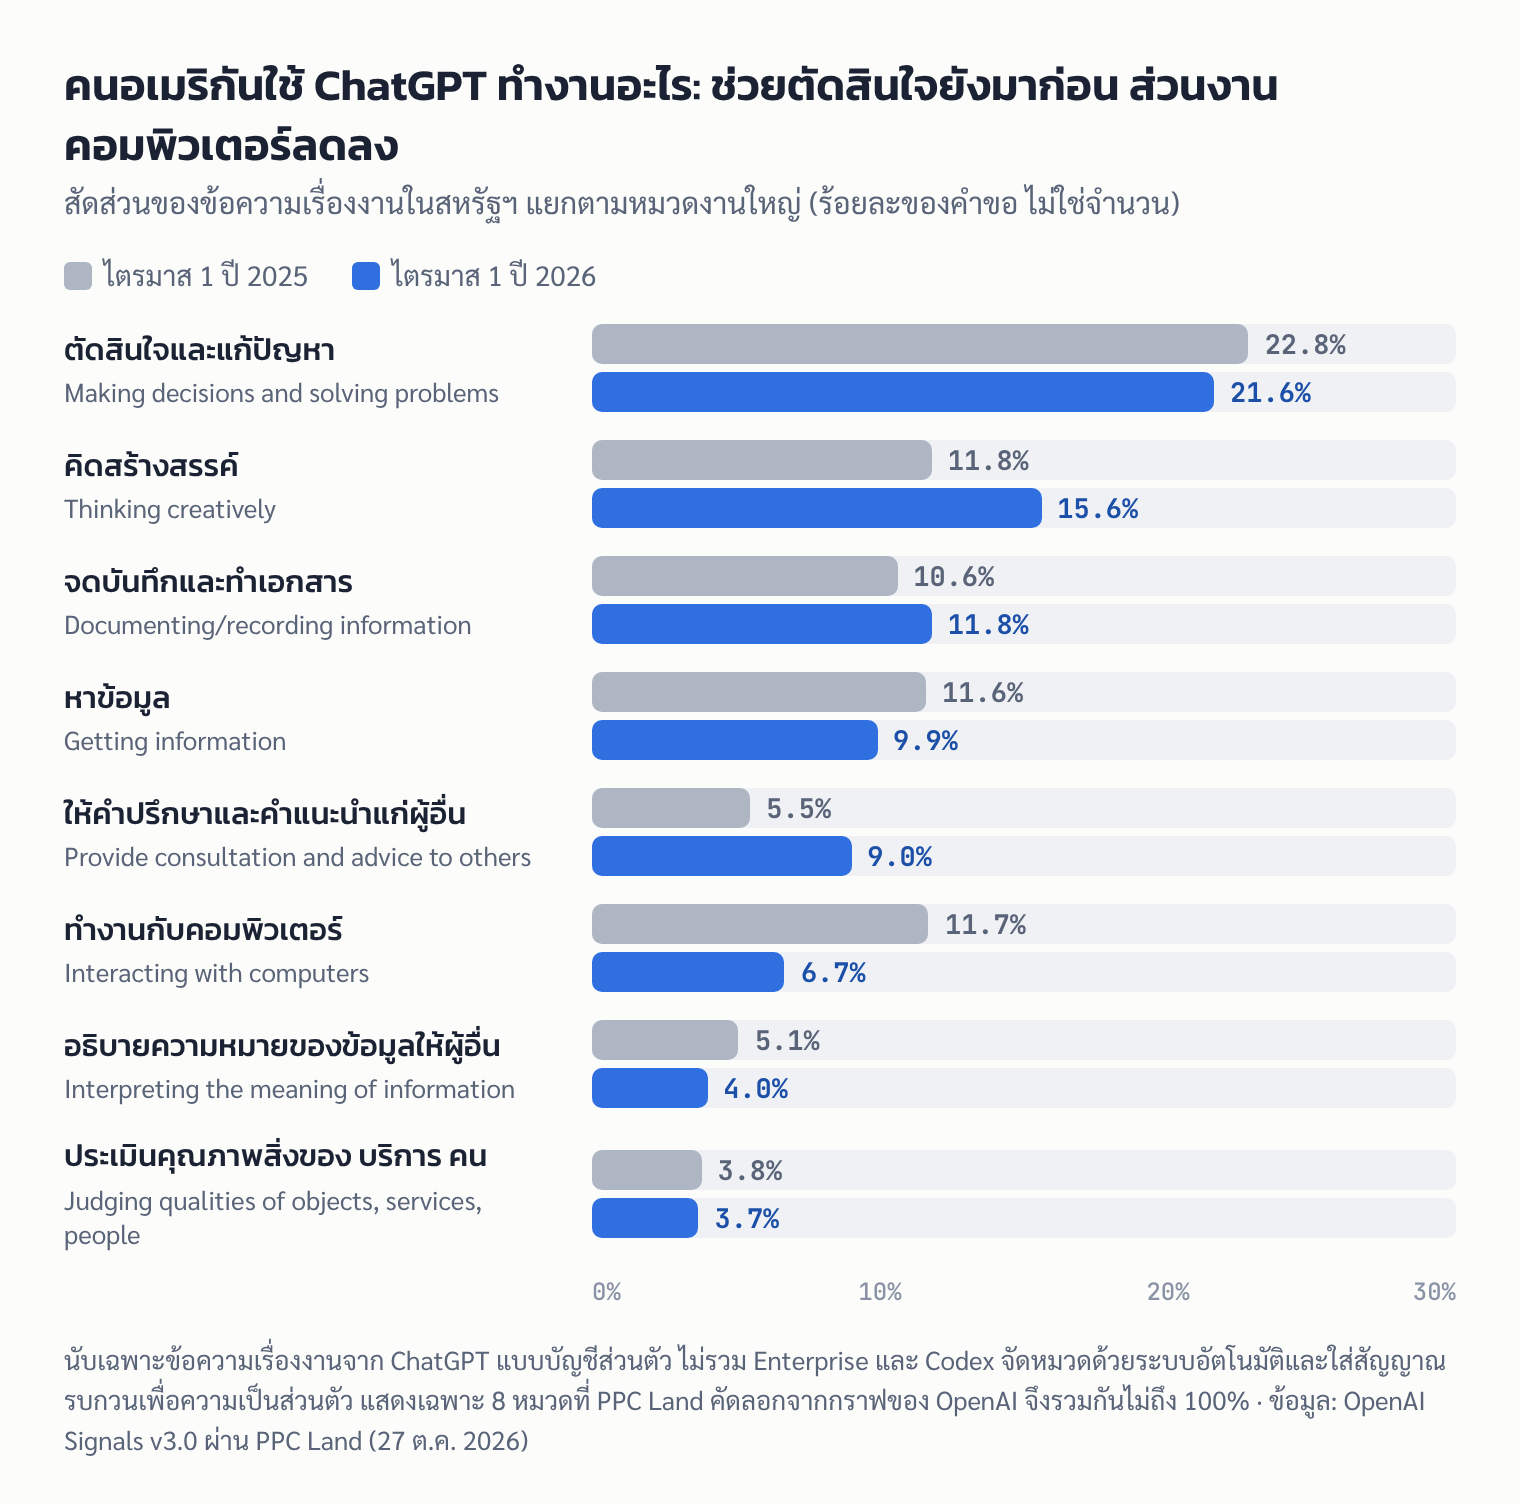
PPC Land คัดตัวเลขจากกราฟแบบโต้ตอบของ OpenAI มาเทียบสองประเทศ โดยใช้ไตรมาส 1 ปี 2025 กับไตรมาส 1 ปี 2026
| หมวดงาน | สหรัฐฯ 2025 | สหรัฐฯ 2026 | เยอรมนี 2025 | เยอรมนี 2026 |
|---|---|---|---|---|
| ตัดสินใจและแก้ปัญหา | 22.8% | 21.6% | 22.0% | 19.4% |
| คิดสร้างสรรค์ | 11.8% | 15.6% | 11.3% | 13.1% |
| จดบันทึกและทำเอกสาร | 10.6% | 11.8% | 10.3% | 11.4% |
| หาข้อมูล | 11.6% | 9.9% | 10.7% | 9.1% |
| ให้คำปรึกษาและคำแนะนำแก่ผู้อื่น | 5.5% | 9.0% | 7.1% | 11.7% |
| ทำงานกับคอมพิวเตอร์ | 11.7% | 6.7% | 12.7% | 8.4% |
| อธิบายความหมายของข้อมูลให้ผู้อื่น | 5.1% | 4.0% | 9.5% | 8.6% |
| ประเมินคุณภาพสิ่งของ บริการ หรือคน | 3.8% | 3.7% | 3.2% | 3.1% |
ตัวเลขทั้งหมดเป็นไตรมาส 1 ของแต่ละปี
- ช่วยตัดสินใจยังนำ แต่สัดส่วนลดลงเล็กน้อย ทั้งสองประเทศ
- ขอคำแนะนำเพื่อนำไปให้คนอื่นเพิ่มขึ้นมากที่สุด สหรัฐฯ จาก 5.5% เป็น 9.0% เยอรมนีจาก 7.1% เป็น 11.7%
- งานคอมพิวเตอร์ลดลงมากที่สุด OpenAI ไม่ได้อธิบายสาเหตุ ReadEval ตั้งข้อสังเกตว่าข้อมูลชุดนี้ไม่นับ Codex จึงบอกไม่ได้ว่างานกลุ่มนี้ลดลงจริง หรือย้ายไปทำในเครื่องมืออื่น
- คนเยอรมันใช้ ChatGPT อธิบายความหมายของข้อมูลให้คนอื่น มากกว่าคนอเมริกันกว่าสองเท่า (8.6% เทียบกับ 4.0%)
ประเทศอื่นเป็นอย่างไร
DigitalToday ของเกาหลีใต้ ซึ่งอ้างรายงานของ GIGAZINE สรุปตัวอย่างจากเอเชียไว้ดังนี้
- ญี่ปุ่น: ไตรมาส 1 ปี 2025 หมวดตัดสินใจและแก้ปัญหานำ ตามด้วยทำงานกับคอมพิวเตอร์ แต่พอถึงไตรมาส 3 ปี 2026 หมวดตัดสินใจลดเหลือ 15.9% และหมวดคิดสร้างสรรค์ขึ้นเป็นอันดับหนึ่ง
- เกาหลีใต้: หมวดตัดสินใจและแก้ปัญหาอยู่อันดับหนึ่งทั้งไตรมาส 1 ปี 2025 และไตรมาส 3 ปี 2026 แต่อันดับรองเปลี่ยนจากงานคอมพิวเตอร์และหาข้อมูล เป็นคิดสร้างสรรค์และจดบันทึกข้อมูล
ภาพรวมจาก 74 ประเทศที่มีข้อมูลครบทุกไตรมาส งานสิบอันดับแรกกินสัดส่วน 56.0% ของข้อความเรื่องงานในไตรมาส 1 ปี 2025 และลดเหลือ 51.1% ในไตรมาส 3 ปี 2026 OpenAI ตีความว่าการใช้งานกระจายตัวมากขึ้น
OpenAI ยังบอกว่าแต่ละประเทศเริ่ม "ถนัด" งานต่างกันมากขึ้น โดยดูจากค่าความต่างของสัดส่วนงานระหว่างประเทศ (average total variation distance) ซึ่งเพิ่มจาก 22.2% เป็น 23.0% PPC Land อธิบายว่าค่า 23% แปลว่าต้องย้ายคำขอราวหนึ่งในสี่ของประเทศหนึ่งไปไว้หมวดอื่น สัดส่วนงานจึงจะเหมือนอีกประเทศ และชี้ว่าค่านี้ขยับเพียง 0.8 จุดในเจ็ดไตรมาส จึงยังไม่ค่อยหนักแน่นพอจะยืนยันข้อสรุปเรื่องความถนัดเฉพาะของแต่ละประเทศ
ChatGPT ถูกใช้ต่างจากงานจริงในเศรษฐกิจแค่ไหน
OpenAI เทียบสัดส่วนงานใน ChatGPT ของสหรัฐฯ กับสัดส่วนงานจริงของคนทำงานทั้งประเทศ (ถ่วงตามจำนวนคนในแต่ละอาชีพ) ผลคือกลุ่มงานวางแผนและตัดสินใจกินสัดส่วนในแชตสูงกว่าในเศรษฐกิจจริงราวสี่เท่า ส่วนหมวด "อื่น ๆ" ซึ่งรวมงานอย่างขนย้ายของ ขับยานพาหนะ และดูแลเวชระเบียน คิดเป็นราว 43% ของงานในเศรษฐกิจสหรัฐฯ แต่แทบไม่ปรากฏในแชต DigitalToday รายงานว่าหมวดนี้มีเพียง 2.4% ของการใช้ ChatGPT
พูดง่าย ๆ คือ ChatGPT ถูกใช้หนักกับงานโต๊ะและงานคิด แต่งานที่ต้องใช้มือหรือร่างกายยังแทบไม่เกี่ยว PPC Land ตั้งข้อสังเกตว่า OpenAI ไม่ได้บอกเกณฑ์ที่ใช้ตัดงานเข้ากลุ่ม "อื่น ๆ" และไม่ได้ระบุว่าใช้ข้อมูลการจ้างงานชุดไหนถ่วงน้ำหนัก
มีข้อมูลของไทยไหม
สิ่งที่ยืนยันไม่ได้: ReadEval เปิดหน้าบทความและหน้าดาวน์โหลดข้อมูลของ OpenAI เมื่อ 28 ต.ค. 2026 แต่เซิร์ฟเวอร์ปฏิเสธการเข้าถึง (HTTP 403) และไม่มีสื่อใดที่เราอ่านระบุรายชื่อประเทศในกราฟประเภทงาน PPC Land พูดถึงแค่สหรัฐฯ กับเยอรมนี ส่วน DigitalToday พูดถึงสหรัฐฯ ญี่ปุ่น และเกาหลีใต้ เราจึงยังยืนยันไม่ได้ว่าในกราฟประเภทงานมีไทยให้เลือก
สิ่งที่มีรายงาน: ไทยมีข้อมูลในไฟล์อื่นของ Signals v3.0 ตามที่สองแหล่งรายงาน
- Relevant Audience บริษัทการตลาดดิจิทัลในไทย คำนวณจากข้อมูลหัวข้อสนทนาว่า ข้อความเรื่องงานของคนไทยคิดเป็น 35.5% ในเดือน ก.ย. 2026 (ทั้งโลก 32.2%) และหัวข้อ "เขียน" ยังเป็นหัวข้อที่ใหญ่ที่สุดของไทยที่ 27.0% ส่วนอันดับการใช้ต่อหัวประชากรของไทยอยู่ที่ 106 ในไตรมาส 3 ปี 2026
- PPC Land ยกตัวอย่างไทยในตารางเรื่องงานว่า 51.0% ของคำขอด้านมัลติมีเดียของคนไทยเป็นเรื่องงาน
ไทยมีข้อมูลในไฟล์ชุดอื่นก็จริง แต่นั่นไม่ได้แปลว่ามีในกราฟประเภทงานด้วย เพราะไฟล์ประเภทงานใช้เกณฑ์ขั้นต่ำต่อไตรมาสสูงกว่า ReadEval ไม่ได้เปิดไฟล์ CSV เองจึงตรวจตัวเลขของไทยซ้ำไม่ได้
ถ้าอยากเปิดดูเอง หรือไม่อยากให้แชตถูกนับ
เปิดกราฟและเลือกประเทศ
- เข้าหน้า openai.com/index/chatgpt-expanding-world-of-work/
- ในกราฟแบบโต้ตอบ เลือกประเทศและไตรมาสที่ต้องการ (PPC Land อธิบายว่ากราฟแสดงสัดส่วน "ของประเทศและไตรมาสที่เลือก")
- กราฟเริ่มจากกลุ่มใหญ่ เช่น Planning and decisions หรือ Developing and advising คลิกที่กลุ่มเพื่อดูประเภทงานย่อยข้างใน
- ถ้าต้องการตัวเลขดิบ ดาวน์โหลดไฟล์ CSV และคำอธิบายข้อมูล (data dictionary) ได้ที่ openai.com/signals/data-download/ ใช้ต่อได้ถ้าอ้างที่มา
ไม่ให้แชตใหม่ถูกนำไปใช้ฝึกโมเดล เอกสาร Signals ระบุว่าไม่นับผู้ที่เลือกไม่ให้ใช้ข้อมูลฝึกโมเดล ในบัญชีส่วนตัวทำได้ดังนี้ (ตามหน้าการควบคุมข้อมูลของ OpenAI)
- ใน ChatGPT เปิดเมนูบัญชี แล้วเลือก Settings
- เลือก Data controls
- ปิดสวิตช์ Improve the model for everyone
การตั้งค่านี้มีผลกับแชตใหม่หลังจากปิด OpenAI ไม่ได้ระบุว่าข้อความที่เคยถูกสุ่มเข้าตัวอย่าง Signals ไปแล้วจะถูกนำออกหรือไม่
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- กลุ่มวางแผนและตัดสินใจเทียบกับเศรษฐกิจจริง: PPC Land รายงานว่ากลุ่มนี้คิดเป็น 35.8% ของคำขอเรื่องงานใน ChatGPT ของสหรัฐฯ เทียบกับ 9.3% ของงานในเศรษฐกิจ ส่วน DigitalToday รายงาน 39.6% เทียบกับ 9.3% ReadEval เปิดหน้าต้นฉบับไม่ได้จึงตัดสินไม่ได้ว่าตัวเลขไหนถูก ทั้งสองแหล่งตรงกันว่าสูงกว่าเศรษฐกิจจริงหลายเท่า
- "1 ใน 5" เป็นตัวเลขไตรมาสไหน: ตัวเลข 21.6% ที่สื่อหลายแห่งใช้เป็นพาดหัวเป็นของไตรมาส 1 ปี 2026 ไม่ใช่ไตรมาสล่าสุด (ไตรมาส 3 ปี 2026) PPC Land ไม่ได้อธิบายว่าทำไมเลือกไตรมาสนี้ ส่วน DigitalToday ระบุเพียงว่าหมวดนี้นำในสหรัฐฯ ตลอดช่วงข้อมูล
- จำนวนประเทศ: ข้อมูลประเภทงานครอบคลุม "เกือบ 100 ประเทศ" แต่มีเพียง 74 ประเทศที่มีข้อมูลครบทุกไตรมาส ขณะที่ข้อมูล Signals ส่วนอื่นครอบคลุมกว่า 170 ประเทศ ตัวเลขเหล่านี้จึงไม่ได้ขัดกัน แต่หมายถึงข้อมูลคนละชุด
- ความถนัดเฉพาะของแต่ละประเทศ: OpenAI บอกว่าประเทศต่าง ๆ ถนัดงานต่างกันมากขึ้น แต่ PPC Land ชี้ว่าตัวชี้วัดที่ใช้ขยับเพียง 0.8 จุด
ความน่าเชื่อถือของข้อมูล
ReadEval ให้คะแนนตามเกณฑ์ 6 ข้อ ได้ 3 ข้อ อยู่ในระดับ 🟡 พอใช้อ้างอิงได้ ใช้ดูทิศทางได้ แต่ไม่ควรถือตัวเลขทศนิยมเป็นค่าแน่นอน
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ไม่ผ่าน | เปิดไฟล์สัดส่วนให้ดาวน์โหลดและคำสั่งจัดหมวดเคยเปิดไว้ในงานวิจัยปี 2025 แต่แชตต้นทางเป็นข้อมูลภายใน คนนอกจัดหมวดซ้ำไม่ได้ |
| บอกวิธีวัดครบ | ผ่าน | ระบุขนาดตัวอย่าง บัญชีที่นับและไม่นับ ค่า ε เกณฑ์ซ่อนกลุ่มเล็ก และมีคำอธิบายข้อมูล แม้หน้ารอบนี้จะไม่บอกว่าใช้โมเดลตัวไหนจัดหมวด |
| วัดหลายรอบและบอกความแปรปรวน | ไม่ผ่าน | มีข้อมูลรายไตรมาสต่อเนื่อง แต่ไม่มีรายงานช่วงความคลาดเคลื่อนของแต่ละตัวเลข ทั้งที่ใส่สัญญาณรบกวนไว้ |
| เทียบอย่างยุติธรรม | ผ่าน | ใช้การใช้งานจริงและวิธีจัดหมวดเดียวกันทุกประเทศและทุกไตรมาส ไม่ได้เลือกงานทดสอบมาเอง |
| เป็นอิสระ | ไม่ผ่าน | OpenAI วัดผลิตภัณฑ์ของตัวเอง และไม่มีบุคคลภายนอกตรวจการจัดหมวด |
| ยอมรับข้อจำกัด | ผ่าน | ระบุเองว่านับเฉพาะบัญชีส่วนตัว ไม่รวม Enterprise และ Codex น่าจะนับงานธุรกิจต่ำกว่าจริง และเป็นสัดส่วนไม่ใช่ปริมาณ |
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
ข้อมูลชุดนี้บอกได้ดีว่าคนใช้ ChatGPT ทำงานแบบไหน แต่ยังบอกไม่ได้ว่า ChatGPT ทำให้งานดีขึ้นหรือแย่ลง จุดแข็งคือเป็นข้อมูลการใช้งานจริงที่เปิดให้ดาวน์โหลด และ OpenAI อธิบายวิธีปกป้องความเป็นส่วนตัวไว้ละเอียดกว่าข้อมูลบริษัททั่วไป จุดอ่อนคือทุกตัวเลขผ่านโมเดลที่บริษัทเลือกเอง ในหมวดที่แม้แต่คนสองคนยังจัดไม่ค่อยตรงกัน และข้อมูลไตรมาสล่าสุดมีสัญญาณรบกวนมากที่สุด ภาพที่น่าคิดกว่าตัวเลขคือคนใช้ AI ช่วย "ตัดสินใจ" และ "ให้คำแนะนำคนอื่น" มากขึ้น งานทดลองของ Anthropic ที่ ReadEval เคยรายงานพบว่านักวิเคราะห์มืออาชีพเลือกตามฝั่งที่ AI ถูกตั้งให้เชียร์ถึง 86% โดยแทบไม่มีใครรู้ตัว ส่วน Anthropic เองก็รายงานแนวโน้มคล้ายกันใน Economic Index เดือนมีนาคม 2026 ว่างานสิบอันดับแรกบน Claude.ai ลดจาก 24% เหลือ 19% ของบทสนทนา แต่ทั้งหมดนี้ก็เป็นข้อมูลที่บริษัท AI วัดสินค้าของตัวเองเช่นกัน ถ้าคุณใช้ ChatGPT ช่วยตัดสินใจเรื่องงาน ให้ใช้เพื่อเห็นทางเลือกมากขึ้น แล้วตัดสินเองด้วยข้อมูลที่ตรวจแล้ว ส่วนคนไทยที่อยากรู้ว่าประเทศเราใช้ทำงานแบบไหน วิธีที่ตรงที่สุดตอนนี้คือเปิดกราฟแล้วลองเลือกประเทศเอง เพราะตัวเลขของสหรัฐฯ หรือญี่ปุ่นไม่จำเป็นต้องสะท้อนการใช้งานในไทย
แหล่งที่มา
- OpenAI: ChatGPT's expanding world of work (Signals v3.0)
- OpenAI Signals: data download (CSV, CC BY 4.0)
- OpenAI Signals Global Report (กุมภาพันธ์ 2026): วิธีการและการปกป้องความเป็นส่วนตัว
- Chatterji et al. (OpenAI): How People Use ChatGPT (ก.ย. 2025) วิธีจัดหมวดและผลทดสอบความแม่นยำ
- PPC Land: Americans use ChatGPT at work most to make decisions
- PPC Land: Writing drops from 34% to 21% of ChatGPT requests (วิธีการของ Signals v3.0)
- DigitalToday: How office workers use ChatGPT differs by country
- Relevant Audience: OpenAI Signals v3.0 (ตัวเลขของไทย)
- Techgenyz: ChatGPT at Work: 165 Work Activities
- OpenAI Help: Data Controls FAQ
- Anthropic: AI agents and expert judgment calls

