Recursive แจก Flint โมเดลช่วยเขียนโค้ดที่รันบนโน้ตบุ๊กได้ ไม่ต้องส่งโค้ดออกนอกเครื่อง
โมเดลนี้ใช้เชิงพาณิชย์ได้และลองผ่าน OpenRouter ได้ฟรี แต่ผลทดสอบที่นำคู่แข่งขนาดเดียวกันยังมาจากบริษัทเอง องค์กรที่จะใช้เป็นหลักควรรอผลทดสอบอิสระ

สารบัญ (8 หัวข้อ)
ลองนึกภาพผู้ช่วยเขียนโค้ดที่ทำงานอยู่ในโน้ตบุ๊กของคุณเอง ไม่ต้องส่งซอร์สโค้ดออกไปยังเซิร์ฟเวอร์ของใคร และไม่ต้องจ่ายค่า API รายเดือน นั่นคือสิ่งที่ Recursive บริษัทวิจัย AI ที่มี Richard Socher อดีตหัวหน้านักวิทยาศาสตร์ของ Salesforce เป็นซีอีโอ เสนอผ่าน Flint โมเดลเขียนโค้ดรุ่นแรกของบริษัท
Flint เผยแพร่แบบ open-weight คือแจกตัวโมเดลให้ดาวน์โหลดไปรันเอง เหมือนได้สูตรอาหารไปทำที่บ้านแทนการสั่งจากร้าน และใช้สัญญาอนุญาต Apache 2.0 ที่ให้นำไปใช้เชิงพาณิชย์ได้ ต่างจากสูตรอาหารตรงที่ครัวของคุณต้องมีที่วางพอ ไฟล์สำหรับ Ollama มีขนาดราว 23GB ส่วนคนที่อยากลองก่อนโดยไม่ดาวน์โหลดก็ใช้ผ่าน OpenRouter ได้ฟรี
ที่รันบนโน้ตบุ๊กได้เพราะโครงสร้างแบบ Mixture of Experts นึกถึงบริษัทที่มีผู้เชี่ยวชาญหลายร้อยคน แต่ทุกครั้งที่ต้องตัดสินใจจะเรียกมาประชุมแค่ไม่กี่คนที่ตรงกับเรื่องนั้น Flint จึงมีขนาดรวมใหญ่ แต่ในแต่ละขั้นคำนวณจริงเพียงราว 6% ของทั้งหมด ทำงานได้เร็วบนเครื่องที่กำลังประมวลผลจำกัด ต่างจากการประชุมจริงตรงที่ระบบเลือกผู้เชี่ยวชาญชุดใหม่ทุกครั้งที่สร้างข้อความหนึ่งหน่วย (token)
อย่างไรก็ตาม ผลทดสอบทั้งหมดมาจาก Recursive เอง บนชุดทดสอบที่วัดการทำงานจริงผ่าน command line นั้น Flint ทำคะแนนสูงกว่าโมเดลขนาดใกล้เคียงอย่าง Qwen 3.6 ราว 10 จุด แต่ยังตามหลัง Qwen 3.8 ที่ใช้โครงสร้างอีกแบบ (dense) อยู่ไกล พูดง่าย ๆ คือเป็นผลสอบที่นักเรียนตรวจเอง ยังรอครูตรวจซ้ำ เพราะยังไม่มีหน่วยงานอิสระทดสอบ บริษัทเองก็ยอมรับว่า Flint ต้องการคำสั่งที่ชัดเจนกว่าโมเดลเชิงพาณิชย์ขนาดใหญ่
ถ้าคุณอยากได้ AI ช่วยเขียนโค้ดที่ไม่ส่งโค้ดออกนอกเครื่อง ลองผ่าน OpenRouter หรือติดตั้ง Ollama แล้วสั่ง ollama run flint กับโปรเจกต์จริงของคุณก่อน ส่วนองค์กรที่จะใช้เป็นโมเดลหลักควรรอผลจากหน่วยงานอิสระ ตารางคะแนนเทียบคู่แข่ง ความเร็วที่บริษัทอ้าง วิธีทดลองแต่ละช่องทาง และเบื้องหลังที่บริษัทให้ AI ช่วยสร้างโมเดลนี้อยู่ด้านล่าง
สรุปประเด็นสำคัญ
- ดาวน์โหลดไปใช้ได้ฟรี: ไฟล์สำหรับ Ollama มีขนาดราว 23GB และทดลองผ่าน OpenRouter ได้โดยไม่มีค่าใช้จ่าย
- ผลทดสอบนำกลุ่มขนาดเดียวกัน: ได้ 54.9% บน Terminal-Bench 2.1 สูงกว่าโมเดล MoE ขนาดใกล้เคียงที่ถูกนำมาเทียบทุกตัว แต่ยังต่ำกว่าโมเดล dense อย่าง Qwen 3.8 ที่ได้ 73.0%
- ตัวเลขทั้งหมดมาจากผู้พัฒนา: ยังไม่มีหน่วยงานอิสระทดสอบซ้ำ
- พัฒนาด้วยระบบ AI ของบริษัทเอง: Recursive ระบุว่าระบบวิจัยอัตโนมัติ "Eureka Machine" ช่วยทำงานเกือบทุกขั้น และใช้เวลาพัฒนาไม่ถึง 4 เดือน
Flint คืออะไร และทำไมรันบนโน้ตบุ๊กได้
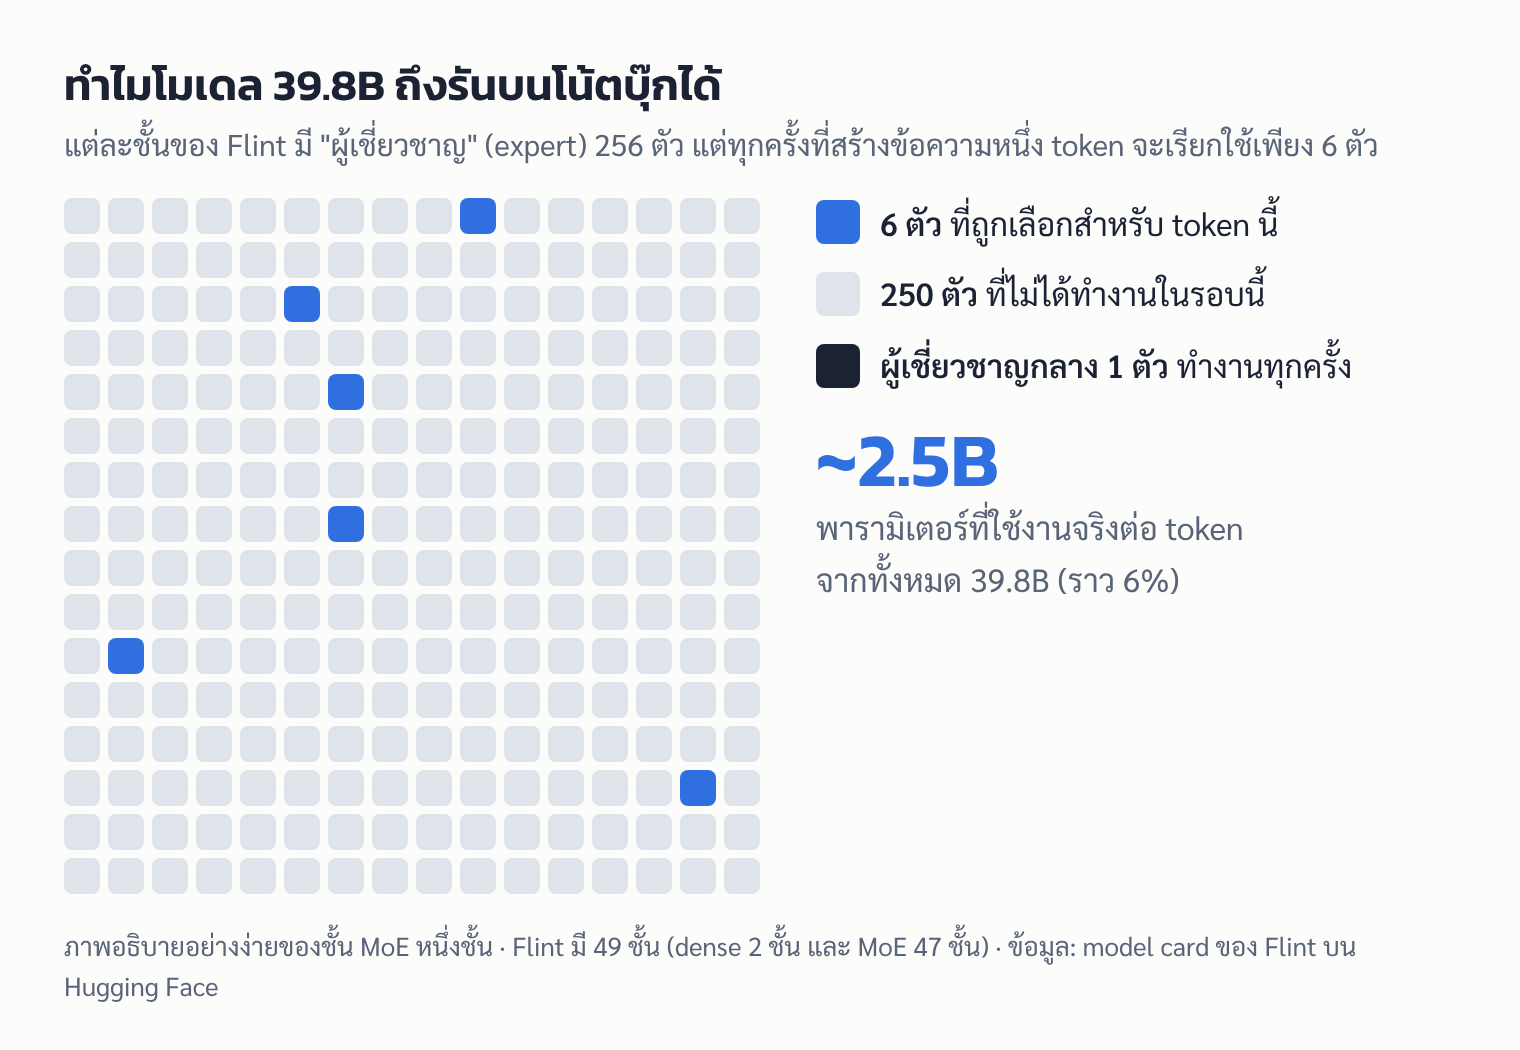
Flint เป็นโมเดลแบบ Mixture of Experts (MoE) ซึ่งแบ่งความรู้ของโมเดลออกเป็น "ผู้เชี่ยวชาญ" (expert) จำนวนมาก แต่ละชั้นของ Flint มีผู้เชี่ยวชาญ 256 ตัว และทุกครั้งที่โมเดลสร้างข้อความหนึ่งหน่วย (token) ระบบจะเลือกใช้เพียง 6 ตัวที่เหมาะกับงานนั้น บวกกับผู้เชี่ยวชาญกลางอีก 1 ตัวที่ทำงานทุกครั้ง ผลคือแม้ตัวโมเดลจะมีขนาดรวม 39.8B พารามิเตอร์ แต่ในแต่ละขั้นจะคำนวณจริงเพียงราว 2.5B หรือประมาณ 6% ของทั้งหมด จึงทำงานได้เร็วบนเครื่องที่มีกำลังประมวลผลจำกัด
โมเดลนี้ออกแบบมาเพื่องานของ coding agent หรือโปรแกรม AI ที่ลงมือแก้โค้ดเอง ตั้งแต่การสำรวจโครงสร้างโปรเจกต์ การแก้บั๊ก การเพิ่มฟีเจอร์ ไปจนถึงการเขียนชุดทดสอบ รองรับการเรียกใช้เครื่องมือ (tool use) ต่อเนื่องหลายรอบ และรับข้อมูลนำเข้าได้ยาวสูงสุด 262,144 token ทั้งนี้ Flint รับและตอบเป็นข้อความเท่านั้น ไม่รองรับรูปภาพ
ผลการทดสอบ: นำกลุ่มขนาดเดียวกัน แต่ยังไม่ใช่ที่หนึ่ง
Recursive เปรียบเทียบ Flint กับโมเดลที่รันบนฮาร์ดแวร์ระดับเดียวกัน 2 กลุ่ม คือโมเดล MoE ขนาด 33–35B ที่ใช้งานจริง 3B และโมเดล dense ขนาด 27–31B ซึ่งใช้พารามิเตอร์ทั้งหมดทุกครั้งที่ประมวลผล
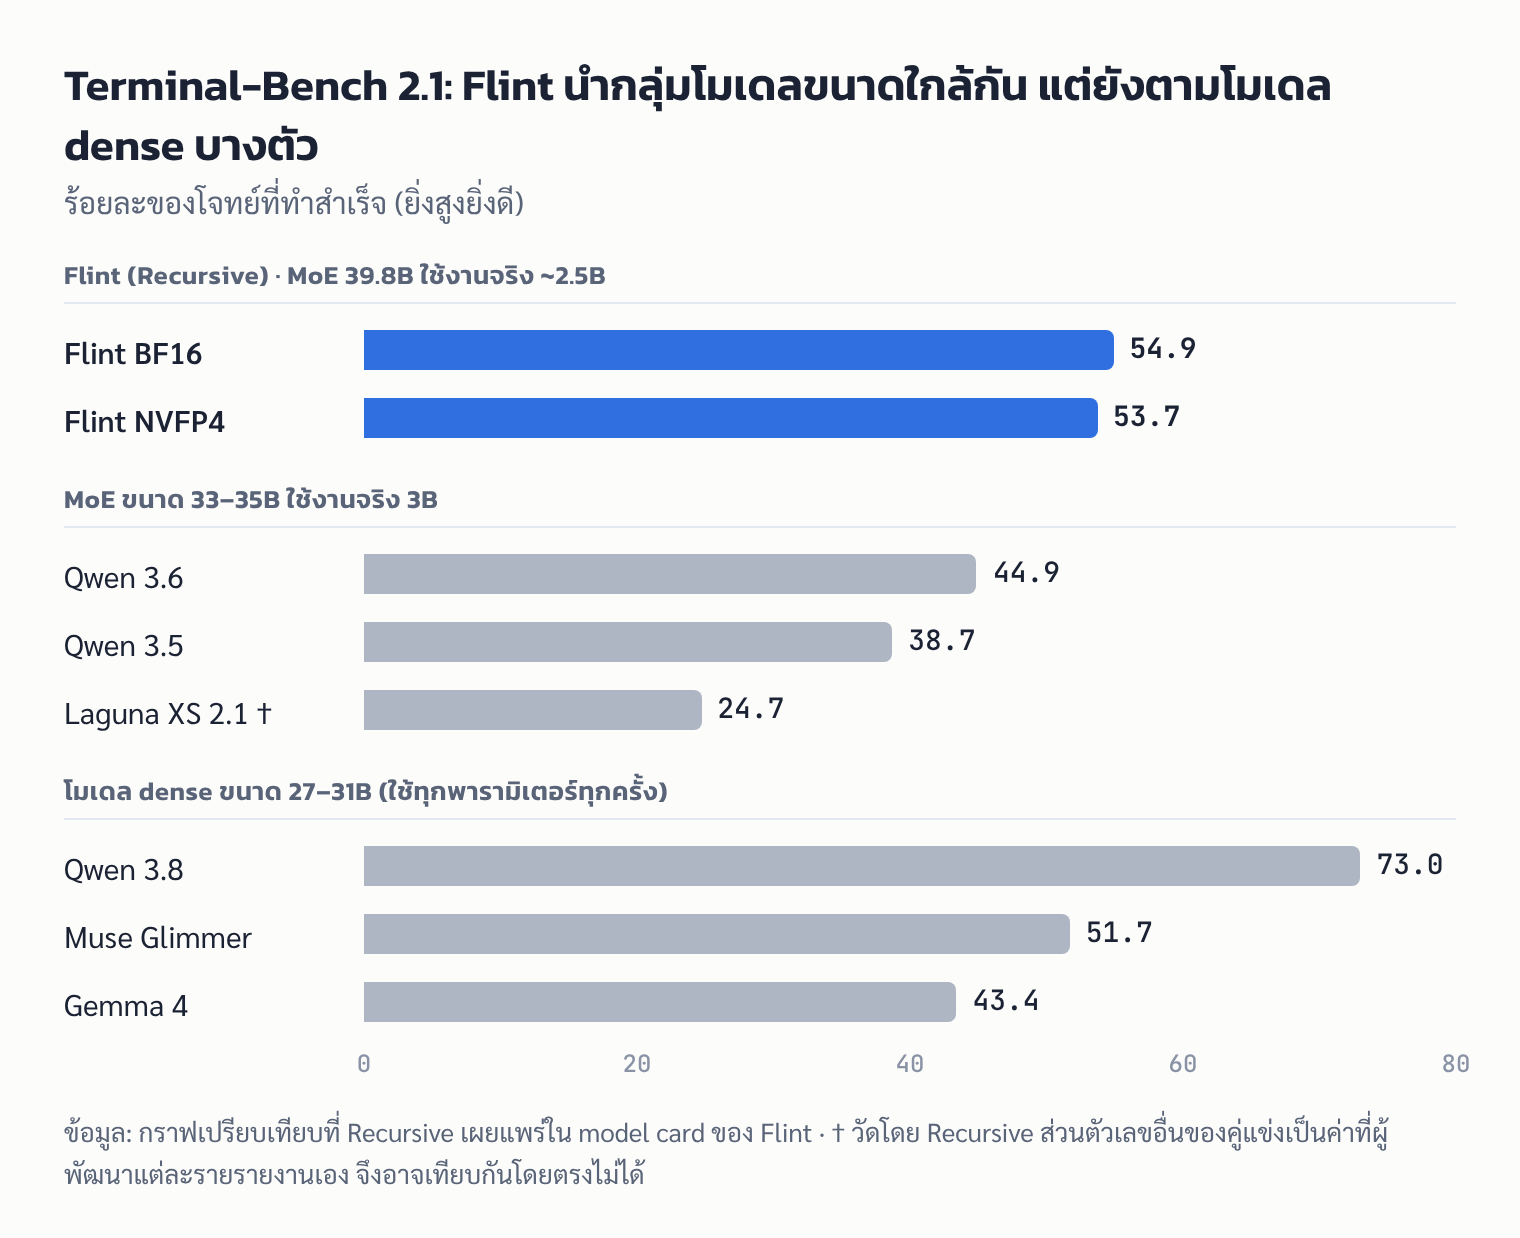
บน Terminal-Bench 2.1 ซึ่งวัดความสามารถในการทำงานจริงผ่าน command line นั้น Flint ทำได้ 54.9% สูงกว่า Qwen 3.6 ที่ได้ 44.9% อยู่ราว 10 จุด แต่ยังห่างจาก Qwen 3.8 แบบ dense ที่ได้ 73.0% ภาพรวมจากทั้ง 6 ชุดทดสอบเป็นดังนี้
| ชุดทดสอบ | Flint BF16 | Flint NVFP4 | Qwen 3.6 (MoE) | Qwen 3.8 (dense) | Gemma 4 (dense) |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 53.7 | 44.9 | 73.0 | 43.4 |
| SWE-bench Pro v2 † | 89.7 | 88.5 | 73.8 | 94.9 | 61.7 |
| SWE-bench Verified | 74.2 | 74.1 | 73.4 | 75.6 † | 66.6 |
| LiveCodeBench v6 | 80.3 | 80.8 | 80.4 | 90.3 | 80.0 |
| IFBench | 89.2 | 88.1 | 67.9 | 79.5 | 76.0 |
| IFEval | 95.1 | 94.6 | 89.6 | 94.6 † | 94.6 |
ตัวเลขเป็นร้อยละ ยิ่งสูงยิ่งดี · † วัดโดย Recursive ส่วนตัวเลขอื่นของคู่แข่งเป็นค่าที่ผู้พัฒนาแต่ละรายรายงานเอง · NVFP4 คือรุ่นที่บีบอัดให้มีขนาดเล็กลงสำหรับรันบนเครื่อง
จากตารางจะเห็นว่า Flint ทำคะแนนได้ใกล้เคียงหรือสูงกว่าโมเดลขนาดเดียวกันในเกือบทุกชุดทดสอบ โดยเด่นที่สุดในด้านการทำตามคำสั่ง (IFBench) ส่วนชุดทดสอบด้านการเขียนโค้ด Qwen 3.8 ยังนำอยู่หลายรายการ ขณะที่รุ่นบีบอัด NVFP4 ซึ่งเหมาะกับการรันบนเครื่องส่วนตัว ได้คะแนนต่ำกว่ารุ่นเต็มไม่เกิน 1.2 จุดในทุกชุดทดสอบ
ข้อควรทราบคือ Recursive วัดผลเองโดยใช้ mini-swe-agent และ Terminus 2 และเฉลี่ยจากการทดสอบอย่างน้อย 5 รอบ บริษัทระบุว่าคำตอบที่ได้มาจากการค้นเว็บใน Terminal-Bench จะถูกนับว่าไม่ผ่าน ซึ่งผู้พัฒนารายอื่นอาจไม่ได้ใช้เกณฑ์เดียวกัน ตัวเลขในตารางจึงใช้เปรียบเทียบได้เพียงคร่าวๆ
ความเร็วที่ผู้พัฒนาอ้าง
Recursive อ้างว่า Flint สร้างข้อความได้มากกว่า 125 token ต่อวินาทีบน MacBook Pro ชิป M4 Pro และมากกว่า 150 token ต่อวินาทีบน NVIDIA RTX Spark รุ่นหน่วยความจำ 64GB โดยไม่นับช่วงอ่านข้อมูลนำเข้า (prefill) บริษัทยังอ้างว่า Flint เร็วกว่าโมเดล dense ขนาด 25–40B ที่ได้คะแนนใกล้เคียงกันมากกว่า 5 เท่า ซึ่งเป็นข้อได้เปรียบหลักของโมเดลแบบ MoE อย่างไรก็ตาม ตัวเลขความเร็วชุดนี้ยังไม่มีผู้ทดสอบอิสระยืนยัน
ทดลองใช้งานได้อย่างไร
| ช่องทาง | เหมาะกับ | สิ่งที่ต้องมี |
|---|---|---|
Ollama (ollama run flint) | นักพัฒนาที่ต้องการรันบนเครื่องตัวเอง | พื้นที่สำหรับไฟล์ราว 23GB |
| LM Studio, llama.cpp, Unsloth | ผู้ที่ใช้เครื่องมือรันโมเดลอื่นอยู่แล้ว | ไฟล์ GGUF ที่เผยแพร่บน Hugging Face |
OpenRouter (recursive/flint-v1.0:free) | ผู้ที่อยากลองก่อนโดยไม่ดาวน์โหลด | บัญชี OpenRouter ไม่มีค่าใช้จ่าย |
| SGLang หรือ vLLM บนเซิร์ฟเวอร์ | องค์กรที่ต้องการให้บริการภายใน | GPU H200 หรือ B300 1 ใบต่อชุด และไฟล์ราว 80GB |
ตัวอย่างการทดลองที่ง่ายที่สุดคือติดตั้ง Ollama แล้วสั่ง ollama run flint จากนั้นพิมพ์โจทย์เป็นภาษาอังกฤษ เช่น "Write a Python function that merges overlapping intervals." ซึ่งเป็นตัวอย่างที่ Recursive ใช้ใน model card สำหรับผู้ใช้ Mac ชิป M4 Pro และ M5 Pro/Max บริษัทยังเปิดตัว rec โปรแกรมรันโมเดลขนาดเล็กที่ปรับแต่งมาสำหรับชิปกลุ่มนี้โดยเฉพาะ
นักพัฒนาที่นำ Flint ไปเชื่อมกับ agent ของตนเองควรเก็บ reasoning_content ที่โมเดลส่งกลับไว้ในประวัติการสนทนาทุกรอบ และกำหนด max_tokens ไม่ต่ำกว่า 32,768 สำหรับโจทย์ที่ซับซ้อน เนื่องจากโมเดลใช้ token ส่วนหนึ่งไปกับการคิดก่อนตอบ
ข้อจำกัดที่ผู้พัฒนาระบุ
Recursive ยอมรับว่า Flint ต้องการคำสั่งที่ชัดเจนกว่าโมเดลเชิงพาณิชย์ขนาดใหญ่ ผู้ใช้ควรแบ่งงานใหญ่ออกเป็นงานย่อยพร้อมคำอธิบายที่ชัดเจน และบริษัทแนะนำให้ใช้ข้อมูลนำเข้าไม่เกิน 256K token เพื่อให้ได้ผลดีที่สุด นอกจากนี้ model card ยังระบุว่าการคิดที่ยาวเกินไปอาจทำให้ token หมดก่อนได้คำตอบ และความแม่นยำอาจต่างกันไปตามรุ่นที่บีบอัดและโปรแกรมที่ใช้รัน
เบื้องหลัง: โมเดลที่ AI ช่วยสร้าง
Recursive ระบุว่า Flint สร้างขึ้นใหม่ทั้งหมดโดยทีมขนาดเล็กที่ทำงานร่วมกับ agent ในเวลาไม่ถึง 4 เดือน โดย Eureka Machine ซึ่งเป็นระบบวิจัย AI อัตโนมัติของบริษัท ทำหน้าที่เสนอแนวคิด ทดลอง และเลือกขั้นตอนถัดไปจากผลลัพธ์ ตั้งแต่การค้นหาโครงสร้างโมเดล การบีบอัดเป็นรุ่น NVFP4 ซึ่งบริษัทระบุว่าคะแนนต่างจากรุ่นเต็มไม่เกิน 0.7 จุดโดยรวม ไปจนถึงการเขียนโค้ดเร่งความเร็วสำหรับชิป Apple M4 และ M5
Recursive เปิดตัวต่อสาธารณะเมื่อเดือนพฤษภาคม 2026 พร้อมเงินทุน 650 ล้านดอลลาร์สหรัฐ ที่มูลค่ากิจการ 4,650 ล้านดอลลาร์ จากนักลงทุนอย่าง GV, Greycroft, Nvidia และ AMD Ventures Flint จึงเป็นผลงานชิ้นแรกที่แสดงให้เห็นแนวทาง "ให้ AI ช่วยพัฒนา AI" ของบริษัท
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
Flint น่าสนใจสำหรับนักพัฒนาที่ต้องการใช้ AI ช่วยเขียนโค้ดโดยไม่ส่งซอร์สโค้ดออกนอกเครื่อง และไม่ต้องการจ่ายค่า API รายเดือน เพราะเป็นโมเดลแบบเปิดที่ทำคะแนนได้ดีในกลุ่มขนาดเดียวกัน อย่างไรก็ตาม ตัวเลขผลทดสอบและความเร็วทั้งหมดยังมาจาก Recursive เพียงแหล่งเดียว ReadEval จึงจัดระดับความน่าเชื่อถือของตัวเลขชุดนี้เป็น "คำกล่าวอ้างของผู้พัฒนา" และแนะนำให้ทดลองกับโปรเจกต์จริงของตนเองผ่าน OpenRouter หรือ Ollama ก่อน ส่วนองค์กรที่จะใช้เป็นโมเดลหลักควรรอผลจากหน่วยงานอิสระ เช่น Artificial Analysis ซึ่ง ณ วันที่ 23 ตุลาคม ยังไม่ได้เผยแพร่ผลของ Flint