ChatGPT ฟรีเลิกเยินยอและตอบสั้นลง แต่เอกสาร OpenAI ชี้ว่าตอบผิดข้อเท็จจริงบ่อยขึ้น
OpenAI ปรับ GPT-6 Luna ของ ChatGPT ฟรีและ Go ให้ตอบกระชับและเลิกเออออ แต่ผลทดสอบของบริษัทเองพบผิดข้อเท็จจริงมากกว่าตัว 7 ต.ค. ทั้ง 6 ตัวชี้วัด

สารบัญ (10 หัวข้อ)
ถ้าช่วงนี้ ChatGPT แบบฟรีของคุณชมน้อยลงและตอบสั้นลง คุณไม่ได้คิดไปเอง OpenAI เพิ่งปรับ GPT-6 Luna โมเดลที่ผู้ใช้ฟรีและแพ็กเกจ Go ได้ใช้ ให้ตอบกระชับขึ้นและลดคำพูดที่เออออตามผู้ใช้เกินเหตุ แต่ในรายงานความปลอดภัยฉบับเดียวกัน OpenAI ก็ยอมรับเองว่าตัวใหม่ตอบผิดข้อเท็จจริงบ่อยกว่าตัวที่ปล่อยเมื่อต้นเดือนตุลาคม
ลองนึกถึงเพื่อนที่เคยชมทุกไอเดียของคุณว่าดีไปหมด วันหนึ่งเขาเริ่มพูดตรงและสั้นลง นั่นเป็นเรื่องดี เพราะคำชมที่ได้ทุกครั้งไม่ช่วยให้ตัดสินใจได้ดีขึ้น ปัญหาการพูดเอาใจของแชตบอตเป็นสิ่งที่ OpenAI ตั้งใจแก้มาตลอด แต่การเปรียบเทียบนี้ใช้ได้ถึงแค่ตรงนี้ เพื่อนที่พูดตรงขึ้นมักไม่ได้จำข้อมูลผิดมากขึ้น ส่วนโมเดล AI การเลิกเยินยอกับการตอบถูกเป็นคนละเรื่องกัน ปรับอย่างหนึ่งแล้วอีกอย่างอาจขยับไปด้วยโดยไม่ได้ตั้งใจ
ในชุดทดสอบความถูกต้องของ OpenAI ตัวใหม่ผิดมากขึ้นทั้ง 6 ตัวชี้วัด เช่น คำถามเรื่องการแพทย์ กฎหมาย และการเงิน ตัวเลขในกราฟของ OpenAI บอกว่าสัดส่วนคำตอบที่มีข้อผิดพลาดอย่างน้อยหนึ่งจุดขยับจากราว 4.5% เป็น 7.8% หรือเกือบเท่าตัว ข่าวดีคือยังผิดน้อยกว่า GPT-5.6 Luna รุ่นก่อนหน้าทุกตัวชี้วัด และ OpenAI ย้ำว่าชุดทดสอบนี้เลือกคำถามยากโดยเจตนา ไม่ได้สะท้อนว่าการใช้งานทั่วไปจะผิดบ่อยแค่นั้น
เรื่องนี้กระทบคนที่ใช้ ChatGPT แบบฟรี แบบ Go และคนที่ใช้โดยไม่ล็อกอินโดยตรง ส่วนสมาชิก Plus และ Pro จะเจอตัวใหม่เฉพาะตอนที่ใช้ GPT-6 จนหมดโควตาแล้วระบบสลับไปโมเดลสำรอง OpenAI บอกว่าเปิด GPT-6 ใน ChatGPT ทั่วโลก แต่ ReadEval ยังไม่ได้ยืนยันด้วยบัญชีในไทยว่าการปรับรอบนี้ถึงแล้ว
สิ่งที่คุณทำได้คือถ้าคำตอบสั้นเกินไป ให้สั่งขอรายละเอียดเพิ่มได้ตรง ๆ และเมื่อเป็นเรื่องสุขภาพ เงิน กฎหมาย หรือตัวเลขที่จะเอาไปใช้จริง ให้เช็กกับแหล่งต้นทางเสมอ ตัวเลขครบทั้ง 6 ตัวชี้วัด วิธีดูว่าคุณกำลังใช้โมเดลไหน และข้อจำกัดของผลทดสอบอยู่ด้านล่าง
สรุปประเด็นสำคัญ
- เกิดอะไรขึ้น: วันที่ 29 ต.ค. 2026 OpenAI ปล่อย GPT-6 Luna (October 29) แทน GPT-6 Luna ที่เข้า ChatGPT เมื่อ 7 ต.ค. 2026 รายงานความปลอดภัยระบุว่าตัวใหม่ "ตอบกระชับขึ้น และลดภาษาที่เออออตามผู้ใช้เกินเหตุ" ส่วนบันทึกการอัปเดตตามที่ MIXED อ้างระบุเป้าหมายว่า "ลดภาษาที่ชมเกินเหตุ"
- ใครได้: ผู้ใช้ฟรี Go และผู้ใช้ที่ไม่ล็อกอิน ได้ตัวใหม่ในแชตโดยไม่ต้องตั้งค่าอะไร สมาชิก Plus และ Pro ยังใช้ GPT-6 ตัวหลักเหมือนเดิม และจะเจอตัวใหม่เฉพาะตอนที่ระบบสลับไปโมเดลสำรองหลังใช้ GPT-6 ครบโควตา
- สิ่งที่แลกมา: ในการทดสอบความถูกต้องของ OpenAI ตัวใหม่มีอัตราผิดข้อเท็จจริงสูงกว่าตัว 7 ต.ค. ทั้ง 6 ตัวชี้วัด แต่ยังต่ำกว่า GPT-5.6 Luna ทุกตัวชี้วัด
- ที่ยังไม่มี: OpenAI ไม่ได้เผยตัวเลขว่าการเยินยอลดลงเท่าไร และไม่มีตัวอย่างบทสนทนาเทียบก่อนกับหลัง
- ควรทำ: ขอรายละเอียดเพิ่มเมื่อคำตอบสั้นเกินไป และตรวจข้อเท็จจริงสำคัญกับแหล่งต้นทาง
OpenAI เปลี่ยนอะไรใน ChatGPT ฟรี
รายงานความปลอดภัย (system card) ฉบับเพิ่มเติมที่ OpenAI เผยแพร่ใน Deployment Safety Hub วันที่ 29 ต.ค. 2026 เปิดด้วยประโยคว่า บริษัทกำลัง "เปิดตัวการอัปเดต GPT-6 Luna ที่ปล่อยใน ChatGPT เมื่อ 7 ตุลาคม โมเดลที่อัปเดตให้คำตอบที่กระชับขึ้น และลดภาษาที่เออออตามเกินเหตุ" และตั้งชื่อเรียกตัวใหม่ว่า GPT-6 Luna (October 29)
นอกจากเรื่องน้ำเสียง OpenAI ระบุว่าตัวใหม่ใช้ข้อมูลและวิธีฝึกแบบเดียวกับตัว 7 ต.ค. และใช้ชุดมาตรการป้องกันการใช้งานผิดวัตถุประสงค์ชุดเดิม เพราะยังจัดว่ามีความสามารถระดับสูง (High) ทั้งด้านความปลอดภัยไซเบอร์และด้านชีววิทยาและเคมีตามกรอบประเมินความเสี่ยงของบริษัทเหมือนตัวก่อน
MIXED ซึ่งอ่านบันทึกการอัปเดตโมเดลของ OpenAI ฉบับ 29 ต.ค. ตั้งข้อสังเกตว่า OpenAI ไม่ได้ให้ตัวอย่างบทสนทนาหรือผลทดสอบเปรียบเทียบเรื่องการเยินยอ จึงยังบอกไม่ได้ว่าผู้ใช้จะรู้สึกถึงความต่างชัดแค่ไหน ReadEval ตรวจรายงานความปลอดภัยแล้วก็ไม่พบตัวชี้วัดเรื่องการเยินยอเช่นกัน
ตอบผิดมากขึ้นแค่ไหน
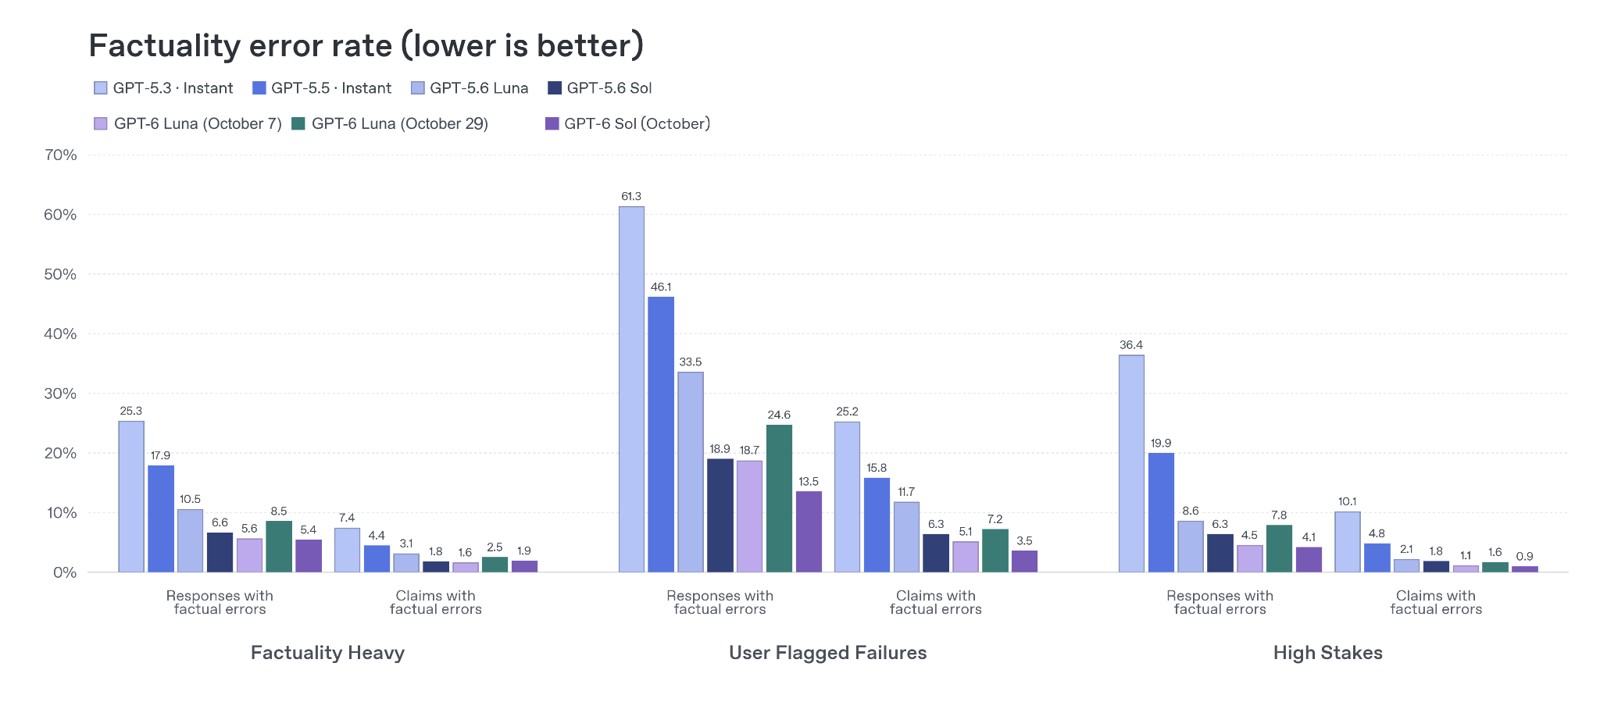
ข้อความในรายงานบอกเพียงทิศทาง คือตัวใหม่ "มีอัตราผิดข้อเท็จจริงสูงกว่าเวอร์ชันเดือนตุลาคมเดิมในทั้ง 6 ตัวชี้วัดที่รายงาน ขณะที่ยังมีอัตราผิดต่ำกว่า GPT-5.6 Luna ในทุกตัวชี้วัด" ตัวเลขอยู่ในกราฟ Figure 3 ด้านบนเท่านั้น ReadEval อ่านค่าจากตัวเลขที่พิมพ์กำกับบนแท่งกราฟ ไม่ใช่ตัวเลขที่ OpenAI เขียนเป็นข้อความ
| ชุดคำถาม | วัดอะไร | GPT-5.6 Luna | GPT-6 Luna (7 ต.ค.) | GPT-6 Luna (29 ต.ค.) |
|---|---|---|---|---|
| คำถามเน้นข้อเท็จจริง | คำตอบที่มีจุดผิด | 10.5% | 5.6% | 8.5% |
| คำถามเน้นข้อเท็จจริง | ข้อความย่อยที่ผิด | 3.1% | 1.6% | 2.5% |
| เคสที่ผู้ใช้เคยแจ้งว่าผิด | คำตอบที่มีจุดผิด | 33.5% | 18.7% | 24.6% |
| เคสที่ผู้ใช้เคยแจ้งว่าผิด | ข้อความย่อยที่ผิด | 11.7% | 5.1% | 7.2% |
| เรื่องสำคัญ (การแพทย์ กฎหมาย การเงิน) | คำตอบที่มีจุดผิด | 8.6% | 4.5% | 7.8% |
| เรื่องสำคัญ (การแพทย์ กฎหมาย การเงิน) | ข้อความย่อยที่ผิด | 2.1% | 1.1% | 1.6% |
วิธีอ่านตาราง: "คำตอบที่มีจุดผิด" คือสัดส่วนคำตอบที่มีข้อผิดพลาดอย่างน้อยหนึ่งจุด ส่วน "ข้อความย่อยที่ผิด" คือสัดส่วนของข้อกล่าวอ้างแต่ละข้อในคำตอบที่ผิด ตัวเลขยิ่งต่ำยิ่งดี จะเห็นว่าตัว 29 ต.ค. อยู่ระหว่างสองรุ่นในทุกแถว คือถอยหลังจากตัว 7 ต.ค. แต่ยังดีกว่ารุ่นก่อนหน้า ช่องว่างที่เห็นชัดที่สุดคือหมวดเรื่องสำคัญ ซึ่งคำตอบที่มีจุดผิดขยับเข้าใกล้ระดับของ GPT-5.6 Luna
ผลทดสอบนี้บอกอะไรได้ และบอกอะไรไม่ได้
รายงานฉบับ 29 ต.ค. ให้ไปอ่านวิธีวัดในรายงานของตัว 7 ต.ค. ซึ่งอธิบายไว้ดังนี้
- คำถามถูกเลือกมาให้ยาก: ชุดคำถามทั้งสามชุด "เลือกมาเพื่อแสดงสถานการณ์ที่โมเดลมีแนวโน้มจะแต่งข้อมูลมากที่สุด" ได้แก่ คำถามที่เน้นข้อเท็จจริง บทสนทนาจริงใน ChatGPT ที่ถูกลบข้อมูลระบุตัวตนแล้วและเคยถูกแจ้งว่ามีข้อผิดพลาด และคำถามยากด้านการแพทย์ กฎหมาย และการเงิน
- ไม่ใช่อัตราผิดในชีวิตจริง: OpenAI เขียนชัดว่าค่าเหล่านี้ "ไม่ได้สะท้อนความถี่ที่เกิดในการใช้งานจริง" แต่ใช้ดูแนวโน้มระหว่างรุ่น ตัวเลข 24.6% จึงไม่ได้แปลว่าคำตอบทั่วไปของคุณผิดเกือบ 1 ใน 4
- ผู้ตรวจเป็น AI: การตัดสินว่าข้อไหนผิด ใช้โมเดลตรวจที่ค้นเว็บได้ ไม่ใช่คนตรวจทีละข้อ
- วัดโดย OpenAI เอง: ยังไม่มีหน่วยงานภายนอกวัดซ้ำ และรายงานไม่ได้บอกจำนวนคำถามหรือช่วงความคลาดเคลื่อนของแต่ละแท่ง
ข้อที่ควรให้เครดิต OpenAI คือบริษัทเปิดผลที่ไม่เป็นผลดีต่อตัวเองไว้ในรายงานเอง และเทียบกับทั้งรุ่นก่อนและรุ่นที่เพิ่งแทนที่
นอกจากเรื่องความถูกต้อง มีอะไรเปลี่ยนอีก
รายงานฉบับเดียวกันมีผลด้านอื่นที่ทั้งดีขึ้นและแย่ลง สรุปเฉพาะส่วนที่ OpenAI เขียนเป็นข้อความ:
- ผู้ใช้อายุต่ำกว่า 18 ปี: ดีขึ้นในการรับมือเนื้อหาทางเพศ ความผิดปกติด้านการกิน การพึ่งพา AI ทางอารมณ์ และเนื้อหารุนแรงน่าสยดสยอง
- การเจาะระบบด้วยบทสนทนาหลายรอบ (jailbreak): ตัวใหม่ป้องกันได้ดีกว่าตัว 7 ต.ค. ในทุกระดับที่ทดสอบ แต่ OpenAI ระบุว่าการทดสอบถูกตัดจบก่อนกำหนดเพราะปัญหาโครงสร้างระบบ
- สุขภาพจิต: ดีขึ้นในการทดสอบเรื่องการทำร้ายตัวเองแบบจำลองผู้ใช้ แต่ถอยลงเล็กน้อยในการทดสอบด้านสุขภาพจิต
- คำถามชีววิทยา: ปฏิเสธคำขออันตรายร้ายแรงได้ดีขึ้น แต่ถอยลงกับคำถามที่ใช้ได้ทั้งทางดีและทางร้าย
ฉันกำลังใช้โมเดลไหนอยู่
- ผู้ใช้ฟรี Go และผู้ใช้ที่ไม่ล็อกอิน: บันทึกการอัปเดตของ ChatGPT เมื่อ 7 ต.ค. 2026 ระบุว่า "แบบฟรีและ Go ใช้ GPT-6 Luna" และตามที่ MIXED กับ TechJournal รายงาน ตัว 29 ต.ค. มาแทนในแชตโดยไม่ต้องเปิดใช้เอง ถ้าคุณใช้แชตปกติหลังวันที่ 29 ต.ค. จึงน่าจะได้ตัวใหม่แล้ว
- สมาชิก Plus และ Pro: คำตอบปกติยังมาจาก GPT-6 ตัวหลัก ถ้าคำตอบสั้นลงกะทันหันหลังจากใช้งานหนักมาทั้งวัน อาจเป็นเพราะคุณใช้ครบโควตาแล้วระบบสลับไปโมเดลสำรอง ซึ่งคือ Luna ตัวใหม่นี้
- สิ่งที่ ReadEval ยืนยันไม่ได้: ไม่ทราบว่าแอปแสดงวันที่ของเวอร์ชันให้เห็นหรือไม่ และไม่ทราบว่าการปรับรอบนี้ทยอยเปิดหรือเปิดพร้อมกันทุกบัญชี แหล่งข่าวที่ ReadEval อ่านไม่ได้พูดถึงตัวบอกเวอร์ชันในแอป และหน้าช่วยเหลือของ OpenAI ปฏิเสธการเข้าถึงจากเครื่องมือของ ReadEval ในวันที่เขียน
ใช้งานอย่างไรให้ได้คำตอบที่ดี
- อยากได้คำตอบยาวขึ้น ให้บอกตรง ๆ: MIXED ชี้ว่าเป้าหมายของ OpenAI ไม่ได้แปลว่าทุกคำตอบจะสั้น และคุณยังขอรายละเอียดเพิ่มได้ ตัวอย่างคำสั่ง:
ช่วยอธิบายแบบละเอียด แยกเป็นข้อ พร้อมบอกว่าข้อไหนที่คุณไม่แน่ใจ
ขอแหล่งอ้างอิงสำหรับตัวเลขและข้อเท็จจริงในคำตอบนี้- ตรวจข้อเท็จจริงที่จะเอาไปใช้จริง: โดยเฉพาะยา อาการป่วย ภาษี สัญญา และตัวเลขเงิน ให้เปิดดูแหล่งต้นทาง เช่น เว็บหน่วยงานรัฐหรือเอกสารของผู้ให้บริการ แทนการเชื่อคำตอบเพียงอย่างเดียว
- ชมน้อยลงไม่ได้แปลว่าถูกมากขึ้น: คำตอบที่ฟังตรงไปตรงมาอาจทำให้ดูน่าเชื่อถือขึ้น แต่ผลทดสอบของ OpenAI ชี้ว่าความถูกต้องของตัวใหม่ถอยลง
ในไทยได้หรือยัง
รายงานของตัว 7 ต.ค. ระบุว่า OpenAI เปิด GPT-6 ใน ChatGPT ให้แพ็กเกจฟรีและจ่ายเงิน "ทั่วโลก" ส่วนรายงานฉบับ 29 ต.ค. และสื่อที่ ReadEval อ่านไม่ได้ระบุประเทศที่ยกเว้น ReadEval ยังไม่ได้ยืนยันด้วยบัญชีในไทยว่าได้ตัว 29 ต.ค. แล้ว และ OpenAI ไม่ได้บอกว่าการลดคำเยินยอได้ผลกับคำตอบภาษาไทยเท่าภาษาอังกฤษหรือไม่
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- วันที่ปล่อยตัวเดิม: OpenAI เรียกตัวเดิมว่า GPT-6 Luna (October 7) แต่ ReadEval เคยรายงานในข่าว GPT-6 Luna เข้าแชตของผู้ใช้ฟรีว่าแบบฟรีและ Go เริ่มได้ GPT-6 Luna ในแท็บแชตวันที่ 8 ต.ค. ตามประกาศเปิดตัว ส่วนวันที่ 7 ต.ค. เป็นวันที่แพ็กเกจจ่ายเงินได้ GPT-6 Sol ReadEval เข้าใจว่า 7 ต.ค. คือวันที่ประกาศเวอร์ชันนี้ และใช้ชื่อตามที่ OpenAI เรียก
- หน้าคู่มือโมเดล: หน้า "GPT-6 and other models in ChatGPT" ในศูนย์ช่วยเหลือของ OpenAI ยังถูกรายงานว่าเขียนว่าแบบฟรีและ Go ใช้ GPT-5.6 Luna ขัดกับบันทึกการอัปเดตและรายงานความปลอดภัย ReadEval ยึดสองเอกสารหลัง เพราะประกาศการเปลี่ยนแปลงโดยตรงและมีวันที่ชัดเจน
- ข้อจำกัดของการตรวจสอบ: หน้าบันทึกการอัปเดตโมเดลใน help.openai.com ปฏิเสธการเข้าถึงจากเครื่องมือของ ReadEval ในวันที่เขียน ข้อความจากบันทึกการอัปเดตจึงมาจากที่ MIXED และ TechJournal ยกมาตรงกัน ส่วนตัวเลขและข้อความจากรายงานความปลอดภัย ReadEval อ่านจากหน้าต้นฉบับเอง
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
ลดการเยินยอเป็นการแก้ที่ถูกทาง แต่ผู้ใช้ฟรีควรรู้ว่าแลกมากับความแม่นยำที่ถอยลง การพูดเอาใจเป็นปัญหาจริงของแชตบอต เพราะคำชมที่ได้ทุกครั้งทำให้คนมั่นใจในความคิดที่อาจผิด และ OpenAI เขียนข้อห้ามพูดเอาใจไว้ในคู่มือพฤติกรรม (Model Spec) ที่ ReadEval เพิ่งรายงาน การปรับรอบนี้จึงตรงกับสิ่งที่บริษัทประกาศไว้ ส่วนที่น่าห่วงคือ OpenAI ให้ตัวเลขฝั่งที่แย่ลงแต่ไม่ให้ตัวเลขฝั่งที่ดีขึ้น ผู้ใช้จึงชั่งไม่ได้ว่าคุ้มหรือไม่ อย่างน้อยตัวใหม่ยังผิดน้อยกว่า GPT-5.6 Luna ที่ผู้ใช้ฟรีใช้ก่อนเดือนตุลาคม สิ่งที่ควรติดตามคืออัปเดตถัดไปจะดึงความแม่นยำกลับมาได้โดยไม่กลับไปพูดเอาใจหรือไม่ ระหว่างนี้ ReadEval แนะนำให้ถือคำตอบของ ChatGPT ฟรีเป็นจุดเริ่มต้น ไม่ใช่คำตอบสุดท้าย โดยเฉพาะเรื่องสุขภาพ เงิน และกฎหมาย
แหล่งที่มา
- OpenAI Deployment Safety Hub: Addendum to GPT-6 Luna System Card, October 29, 2026 Update
- OpenAI Deployment Safety Hub: GPT-6 Sol and GPT-6 Luna, October 2026 update (วิธีวัดความถูกต้องและการเปิดทั่วโลก)
- OpenAI Help: Model Release Notes (29 ต.ค. 2026)
- Releasebot: ChatGPT updates (สำเนาบันทึกการอัปเดต 7 ต.ค. 2026)
- MIXED: "Reduce overly flattering language": OpenAI changes GPT-6 for free ChatGPT users
- TechJournal: ChatGPT GPT-6 update brings shorter, less flattering answers
