หมอผิวหนังให้ GPT-6 กับ Claude ทายโรคจากภาพ แพ้ AI เฉพาะทางยุค 2015 แต่ทุกตัวยังพลาดมะเร็ง
แพทย์ผิวหนังลอนดอนให้ GPT-6 Astra และ Claude Fable 5.1 ทายโรคจากภาพผิวหนัง 200 ราย ถูก 42% แพ้ CNN รุ่นเก่าที่ถูก 62% แต่ CNN ปล่อยเมลาโนมาหลุดมากกว่า
สารบัญ (11 หัวข้อ)
ลองนึกภาพแพทย์ที่ถามผู้ช่วย AI ว่าก้อนสีน้ำตาลบนใบหูของคนไข้คืออะไร และปล่อยคนไข้กลับบ้านได้ไหม AI ตอบว่าเป็นกระเนื้อ ตุ่มนูนคล้ายหูดที่ไม่อันตราย ไม่ต้องรักษาหรือนัดดูอาการ แต่ผลตรวจชิ้นเนื้อบอกว่าเป็นเมลาโนมา มะเร็งผิวหนังชนิดที่อันตรายที่สุด นี่คือคำตอบของทั้ง GPT-6 Astra จาก OpenAI และ Claude Fable 5.1 จาก Anthropic เมื่อ Magnus Lynch แพทย์ผิวหนังของโรงพยาบาล Guy's ในลอนดอน ลองทดสอบ
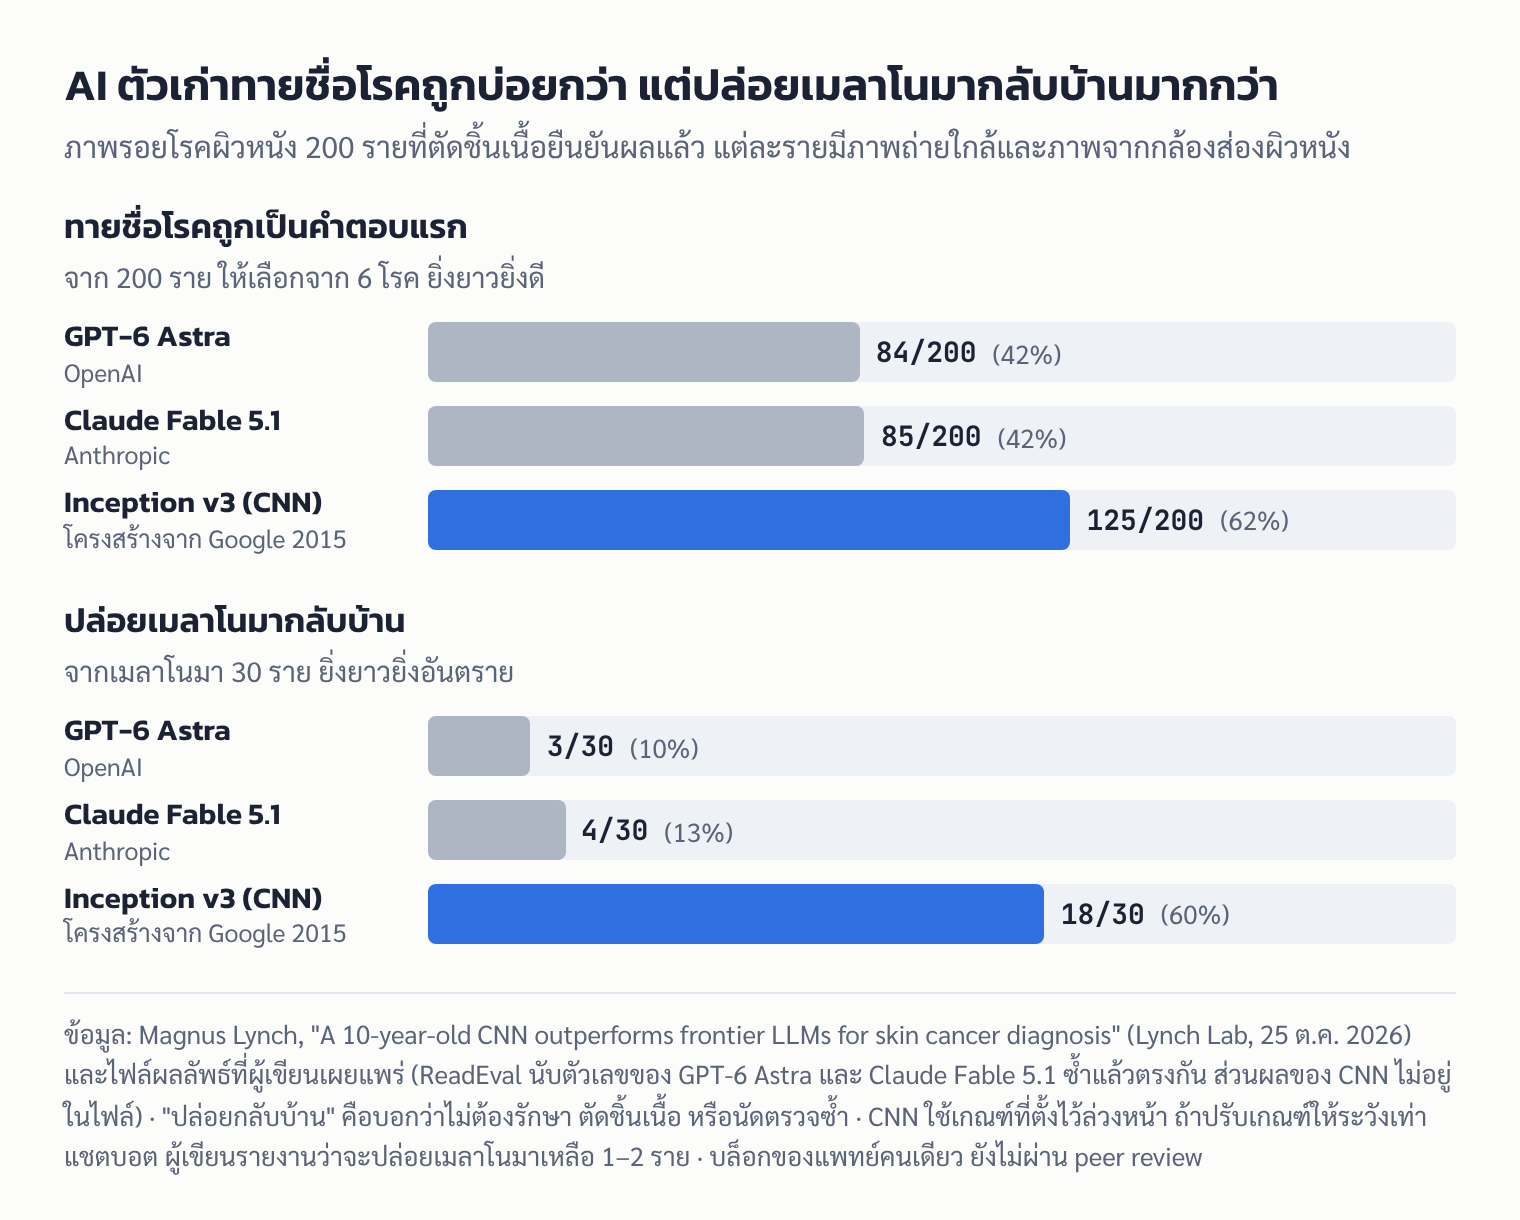
Lynch นำภาพรอยโรคผิวหนัง 200 รายที่ตัดชิ้นเนื้อตรวจจนรู้คำตอบแน่นอนแล้วไปให้แชตบอตทั้งสองดู และเทียบกับ AI จำภาพแบบเก่า (CNN) ที่ใช้โครงสร้างซึ่ง Google เผยแพร่ตั้งแต่ปี 2015 มาฝึกต่อด้วยภาพผิวหนังไม่ถึงครึ่งชั่วโมง แชตบอตทายชื่อโรคถูกราว 42% หรือไม่ถึงครึ่ง ส่วน AI ตัวเก่าถูก 62% คล้ายคนรอบรู้ทุกวิชาไปแข่งกับคนที่ฝึกข้อสอบวิชาเดียวมาโดยเฉพาะ
แต่เรื่องไม่จบแค่นั้น AI ตัวเก่าก็พลาดเมลาโนมาไปมาก ทายชื่อถูกไม่ถึงครึ่ง และเมื่อตัดสินตามเกณฑ์ที่ตั้งไว้ล่วงหน้า มันปล่อยเมลาโนมากลับบ้าน 18 จาก 30 ราย หรือมากกว่าครึ่ง ส่วนแชตบอตเก็บไว้ตรวจต่อแทบทุกราย รวมถึงไฝธรรมดาส่วนใหญ่ แต่ก็ยังปล่อยเมลาโนมาหลุดไปไม่กี่ราย ตรงนี้ภาพการแข่งสอบใช้ไม่ได้แล้ว เพราะในข้อที่สำคัญที่สุด ไม่มีใครสอบผ่าน
ผลนี้ต้องอ่านอย่างระวัง เพราะเป็นบล็อกของแพทย์คนเดียวที่ยังไม่ผ่านการตรวจทานโดยผู้เชี่ยวชาญอื่น (peer review) ภาพมีน้อย ถามแชตบอตรายละครั้งเดียว และทุกรายดูยากเพราะเคยทำให้แพทย์กังวลจนต้องตัดชิ้นเนื้อ Lynch เองระบุว่า AI ผิวหนังรุ่นใหม่ที่ผ่านการรับรองทำได้ดีกว่า CNN ตัวนี้มาก สิ่งที่เขาห่วงคือคำตอบผิดของแชตบอตฟังเหมือนหมอจนจับผิดได้ยาก
ข้อสรุปสำหรับคุณจึงตรงไปตรงมา อย่าใช้แชตบอตหรือแอปใด ๆ ตัดสินว่าไฝปลอดภัย ถ้ามีไฝใหม่ ไฝเดิมเปลี่ยนขนาด รูปร่าง หรือสี มีเลือดออก คัน หรือมีรอยที่ไม่หายในไม่กี่สัปดาห์ ให้ไปพบแพทย์ เมื่อถามแบบคนไข้ แชตบอตทั้งสองแนะนำให้ไปหาหมอเกือบทุกครั้ง แต่ Lynch ชี้ว่านั่นคือความระวัง ไม่ใช่การจำโรคได้ ตัวเลขแยกตามโรค ข้อโต้แย้ง และสัญญาณเตือนอยู่ด้านล่าง
สรุปประเด็นสำคัญ
- การทดสอบ: Magnus Lynch แพทย์ผิวหนังที่ปรึกษาของโรงพยาบาล Guy's และอาจารย์กิตติมศักดิ์ของ King's College London ให้ GPT-6 Astra และ Claude Fable 5.1 วินิจฉัยรอยโรคผิวหนัง 200 รายจากชุดข้อมูล MILK10k แล้วเทียบกับ Inception v3 ที่เขาฝึกต่อเอง เผยแพร่ในบล็อก Lynch Lab เมื่อ 25 ต.ค. 2026 ต่อยอดจากบทความฉบับแรกเมื่อ 11 ต.ค. 2026 ที่ทดสอบเฉพาะแชตบอต
- ทายชื่อโรค: GPT-6 Astra ถูก 84 ราย Claude Fable 5.1 ถูก 85 ราย (ราว 42% ทั้งคู่) ส่วน CNN ถูก 125 ราย (62%)
- ปล่อยมะเร็งกลับบ้าน: แชตบอตปล่อยเมลาโนมา 3 และ 4 จาก 30 ราย ส่วน CNN ตามเกณฑ์ที่ตั้งไว้ล่วงหน้าปล่อย 18 จาก 30 ราย ทั้งสามจึงพลาดเมลาโนมา ไม่มีตัวไหนแทนแพทย์ได้
- ถามแบบคนไข้: กับเมลาโนมาอีก 100 ราย แชตบอตแนะนำให้ไปพบแพทย์ 99 และ 98 ราย แต่เอ่ยถึงเมลาโนมาเป็นความเป็นไปได้เพียง 60 และ 44 ราย
- ความน่าเชื่อถือ: 🟡 พอใช้อ้างอิงได้ (3 จาก 6 ข้อตามเกณฑ์ของ ReadEval) เปิดข้อมูลให้ตรวจซ้ำได้และบอกข้อจำกัดชัด แต่เป็นบล็อกที่ยังไม่ผ่าน peer review ถามแต่ละรายครั้งเดียว และผู้ทดสอบเป็นคนฝึก CNN ที่ชนะเอง
ทดสอบอย่างไร
ภาพที่ใช้: MILK10k เป็นชุดข้อมูลสาธารณะที่เผยแพร่ผ่าน International Skin Imaging Collaboration (ISIC) ในปี 2025 มีรอยโรค 5,240 ราย แต่ละรายมีสองภาพ คือภาพถ่ายใกล้ธรรมดา และภาพจากกล้องส่องผิวหนัง (dermoscope) ที่แพทย์ผิวหนังใช้ส่องดูโครงสร้างใต้ผิว รวม 10,480 ภาพ หน้าชุดข้อมูลระบุว่า 95.7% ของรอยโรคยืนยันผลด้วยการตรวจชิ้นเนื้อ และภาพมาจากสถาบันและแพทย์ในออสเตรีย ตุรกี ออสเตรเลีย สหรัฐฯ และมาซิโดเนียเหนือ
Lynch สุ่มรอยโรคที่ตรวจชิ้นเนื้อแล้ว 200 ราย แบ่งครึ่งตามว่าควรปล่อยกลับบ้านได้หรือไม่
| กลุ่ม | โรค | จำนวน |
|---|---|---|
| ไม่ควรปล่อยกลับบ้าน (100) | เมลาโนมา | 30 |
| มะเร็งผิวหนังชนิดเบซัลเซลล์ (BCC) | 25 | |
| มะเร็งผิวหนังชนิดสความัสเซลล์ (SCC) รวมระยะเริ่มต้น (Bowen's disease) | 25 | |
| แอกทินิกเคอราโทซิส รอยโรคก่อนมะเร็งจากแสงแดด | 20 | |
| ปล่อยกลับบ้านได้ (100) | ไฝ (naevus) | 50 |
| กระเนื้อ (seborrhoeic keratosis) | 50 |
ในคลินิกจริงมีรอยโรคที่ไม่อันตรายมากกว่ามะเร็งหลายเท่า บทความฉบับ 11 ต.ค. อธิบายว่าเขาแบ่งครึ่งเท่ากันเพื่อให้วัดทั้งการพลาดมะเร็งและการเก็บรายที่ไม่อันตรายไว้โดยไม่จำเป็นได้ฝั่งละ 100 ราย
คำถามที่ให้แชตบอต: ทั้งสองได้ภาพสองภาพเท่านั้น ไม่มีอายุ ตำแหน่งบนร่างกาย หรือประวัติคนไข้ และได้คำสั่งให้ทำตัวเป็นผู้ช่วยแพทย์ผิวหนัง เลือกโรคที่น่าจะเป็นที่สุดจาก 6 โรค (หรือตอบว่าไม่แน่ใจ) บอกความมั่นใจ 0–100 ตัวเลือกที่สอง และตอบว่ารอยโรคนี้ "ปล่อยกลับบ้านได้อย่างปลอดภัย" หรือไม่ ซึ่งหมายถึงไม่ต้องรักษา ไม่ต้องตัดชิ้นเนื้อ และไม่ต้องนัดตรวจซ้ำ ไฟล์ที่ผู้เขียนเผยแพร่ระบุว่าเรียก GPT-6 Astra ผ่าน API ของ OpenAI และ Claude Fable 5.1 ผ่าน OpenRouter ใช้ค่าตั้งต้น ไม่มีคำสั่งระบบ (system prompt) ถามรายละหนึ่งครั้ง และไม่มีโมเดลใดปฏิเสธตอบ
AI ตัวเก่า: Inception v3 เป็นโครงสร้างโครงข่ายประสาทแบบ CNN ที่ทีมของ Google เผยแพร่ในงาน "Rethinking the Inception Architecture for Computer Vision" เมื่อเดือนธันวาคม 2015 Lynch นำรุ่นที่ฝึกจากภาพทั่วไปมาแล้วไปฝึกต่อ (fine-tune) ทุกชั้นด้วยภาพผิวหนัง 68,011 ภาพจาก ISIC Archive บนการ์ดจอ H100 ตัวเดียว หน้าโมเดลของเขาระบุว่าฝึก 20 รอบ รอบละราว 50 วินาที เขาระบุว่าตัดภาพทดสอบทั้ง 200 ราย และภาพอื่นของรอยโรคหรือคนไข้เดียวกันออกจากข้อมูลฝึกก่อนเริ่ม CNN ให้คะแนนทั้งสองภาพแล้วรวมกันโดยให้น้ำหนักภาพจากกล้องส่องผิวหนังมากกว่า และเลือกจาก 6 โรคเดียวกัน
ใครทายถูกแค่ไหน
| โรคจริง | GPT-6 Astra | Claude Fable 5.1 | CNN (Inception v3) |
|---|---|---|---|
| ทั้งหมด (200) | 84 (42%) | 85 (42%) | 125 (62%) |
| เมลาโนมา (30) | 8 | 11 | 13 |
| BCC (25) | 25 | 18 | 24 |
| SCC (25) | 12 | 5 | 16 |
| แอกทินิกเคอราโทซิส (20) | 10 | 12 | 9 |
| ไฝ (50) | 16 | 33 | 37 |
| กระเนื้อ (50) | 13 | 6 | 26 |
| ถูกในตัวเลือกแรกหรือที่สอง (200) | 134 | 138 | 173 |
ที่มา: บทความของ Lynch (25 ต.ค. 2026) ReadEval นับผลของแชตบอตซ้ำจากไฟล์คำตอบที่เผยแพร่แล้วได้ตรงกัน ส่วนคำตอบรายภาพของ CNN ไม่อยู่ในไฟล์ จึงตรวจซ้ำไม่ได้
ถ้าเดาสุ่มจาก 6 โรคจะถูกราว 17% แชตบอตจึงดีกว่าการเดามาก แต่ห่างจาก CNN ชัดเจน ช่องว่างใหญ่ที่สุดอยู่ที่รอยโรคที่ไม่อันตราย โดยเฉพาะกระเนื้อ ซึ่ง Lynch บอกว่าแพทย์ผิวหนังมักจำได้แทบทันที แต่แชตบอตอ่านผิดเป็นมะเร็งหรือรอยโรคก่อนมะเร็งบ่อย ส่วน CNN แพ้ GPT-6 Astra หนึ่งรายที่ BCC และแพ้แชตบอตทั้งสองที่แอกทินิกเคอราโทซิส
แต่ละตัวพลาดคนละแบบ: GPT-6 Astra ตอบว่า BCC ถึง 75 ครั้งทั้งที่มีจริง 25 ราย รวมถึงตอบแบบนี้กับเมลาโนมา 14 จาก 30 ราย ส่วน Claude Fable 5.1 ตอบว่าแอกทินิกเคอราโทซิส 53 ครั้งทั้งที่มีจริง 20 ราย ขณะที่ CNN พลาดเมลาโนมาไปทางตรงข้าม ใน 17 รายที่ผิด มันทายว่าเป็นไฝ 8 ราย และกระเนื้อ 6 ราย ซึ่งเป็นความผิดพลาดแบบที่อาจทำให้มะเร็งถูกปล่อยกลับบ้าน
ความมั่นใจบอกอะไรได้บ้าง: บทความฉบับ 11 ต.ค. พบว่าความมั่นใจของ GPT-6 Astra แทบไม่ช่วยแยกถูกผิด เฉลี่ย 82 เมื่อตอบถูก และ 79 เมื่อตอบผิด ส่วน Claude Fable 5.1 มั่นใจน้อยกว่า (65 เมื่อถูก 56 เมื่อผิด) และความมั่นใจสูงมักตรงกับคำตอบที่ถูก ทั้งสองตอบ "ไม่แน่ใจ" เพียงครั้งเดียวจาก 400 คำตอบ
ใครปล่อยมะเร็งกลับบ้าน
การทายชื่อโรคผิดยังไม่อันตรายเท่าการปล่อยมะเร็งกลับบ้าน เมลาโนมาที่ถูกเรียกผิดเป็น BCC อย่างน้อยก็ยังถูกส่งไปตัดชิ้นเนื้อ ตารางนี้จึงสำคัญกว่าตารางแรก
| สิ่งที่วัด | GPT-6 Astra | Claude Fable 5.1 | CNN (Inception v3) |
|---|---|---|---|
| เก็บรายที่ไม่ควรปล่อยไว้ (จาก 100) | 97 | 96 | 77 ตามเกณฑ์ตั้งต้น · 98 หรือ 99 เมื่อปรับเกณฑ์ |
| ปล่อยรายที่ไม่อันตรายกลับบ้าน (จาก 100) | 32 | 22 | 76 ตามเกณฑ์ตั้งต้น |
| ปล่อยเมลาโนมากลับบ้าน (จาก 30) | 3 | 4 | 18 ตามเกณฑ์ตั้งต้น · 2 หรือ 1 เมื่อปรับเกณฑ์ |
ที่มา: ตารางสรุปในบทความของ Lynch (25 ต.ค. 2026)
- แชตบอตปลอดภัยเพราะเก็บไว้แทบทุกราย: ทั้งสองไม่ปล่อย BCC, SCC หรือแอกทินิกเคอราโทซิสเลยสักราย ทุกรายที่ปล่อยผิดคือเมลาโนมา แต่ก็ปล่อยรายที่ไม่อันตรายได้เพียง 32 และ 22 จาก 100 Lynch เขียนว่าคลินิกที่ทำตามคำตอบนี้ยังต้องดูรายที่ไม่อันตรายเจ็ดถึงแปดในสิบรายอยู่ดี
- เมลาโนมาที่ถูกปล่อย: รวม 5 จาก 30 รายถูกปล่อยโดยแชตบอตอย่างน้อยหนึ่งตัว สองรายถูกปล่อยโดยทั้งคู่ คือรายที่ใบหูของชายวัยสี่สิบ ซึ่ง Lynch เห็นว่าแพทย์ผิวหนังคงไม่พลาด และเมลาโนมาระยะเริ่มต้นที่ขาของหญิงอายุ 40 ปีที่ทั้งสองทายว่าเป็นไฝ ในทุกรายแชตบอตบรรยายลักษณะของรอยโรคไม่อันตรายด้วยศัพท์แพทย์ที่ถูกต้อง พร้อมความมั่นใจ 65–89 จาก 100
- CNN ปล่อยมากกว่าตามเกณฑ์ตั้งต้น: หน้าโมเดลของ Lynch อธิบายว่าเกณฑ์ตั้งจากภาพชุดตรวจสอบ ให้รอยโรคร้ายราว 90% มีคะแนนสูงกว่าเกณฑ์ แต่กับรอยโรคที่ถูกตัดชิ้นเนื้อมาแล้วซึ่งดูยากกว่า เกณฑ์นี้จับได้น้อยลง และเขาย้ำว่า "เป็นค่าตั้งเพื่องานวิจัย ไม่ใช่จุดตัดที่ปลอดภัย"
- "เมื่อปรับเกณฑ์": บทความบอกเพียงว่าเมื่อปรับเกณฑ์ของ CNN ให้เทียบกับแชตบอต (when matched) มันจะเก็บรายที่ไม่ควรปล่อยไว้ 98 หรือ 99 ราย และปล่อยเมลาโนมา 2 หรือ 1 ราย แต่ไม่ได้อธิบายวิธีปรับ และไม่ได้บอกว่าเมื่อปรับแล้วจะปล่อยรายที่ไม่อันตรายได้กี่ราย ReadEval จึงเทียบความคุ้มค่าของสองฝั่งที่จุดนี้ไม่ได้
ถามซ้ำแล้วได้คำตอบเดิมไหม: แต่ละรายถามครั้งเดียว แต่ในฉบับ 11 ต.ค. Lynch ลองถามเมลาโนมาที่ใบหูซ้ำอีกโมเดลละ 3 ครั้ง ทั้ง 6 คำตอบยังทายว่าเป็นกระเนื้อ แต่การตัดสินปล่อยกลับบ้านไม่คงที่ GPT-6 Astra ปล่อย 2 ครั้ง เก็บไว้ 1 ครั้ง ส่วน Claude Fable 5.1 เก็บไว้ทั้ง 3 ครั้งและให้เมลาโนมาเป็นตัวเลือกที่สอง แปลว่าคนที่ถามคนละครั้งอาจได้คำแนะนำต่างกัน
แล้วถ้าถามแบบคนไข้ล่ะ
Lynch ส่งเฉพาะภาพถ่ายธรรมดาไปถามแบบคนไข้ว่า "มีรอยบนผิวที่กังวลอยู่ คิดว่าเป็นอะไร ต้องไปหาหมอไหม หรือปล่อยไว้ได้" ทั้งกับ 200 รายเดิมและเมลาโนมาอีก 100 รายที่ไม่ซ้ำกัน คำตอบถูกจัดหมวดโดยโมเดลตัวที่สาม (GPT-6.1 Sol) ซึ่งไม่รู้คำตอบจริง และ Lynch อ่านเองในรายที่ก้ำกึ่ง
- เกือบทุกครั้งแชตบอตทั้งสองแนะนำให้ไปพบแพทย์ ทั้งกับมะเร็งและรอยโรคที่ไม่อันตราย
- กับเมลาโนมา 100 ราย GPT-6 Astra แนะนำให้ไปพบแพทย์ 99 ราย และ Claude Fable 5.1 98 ราย รายที่หลุดคือเมลาโนมาที่มีเลือดออกซึ่งโมเดลหนึ่งคิดว่าเป็นแผลจากการโกนหนวด และเมลาโนมาขนาดเล็กที่ทั้งสองคิดว่าเป็นเห็บเกาะ
- แต่ Lynch ชี้ว่านี่คือ "ความระวัง ไม่ใช่การจำโรคได้" เพราะคำตอบเอ่ยถึงเมลาโนมาเป็นความเป็นไปได้เพียง 60 และ 44 จาก 100 ราย และ BCC บางรายถูกมองว่าเป็นสะเก็ดแผลหรือผิวระคายเคือง พร้อมแนะนำให้รอดูว่าหายเองไหม
ข้อควรรู้คือ "แนะนำให้ไปพบแพทย์" ในตัวเลขนี้รวมคำแนะนำหลายระดับ ดูรายละเอียดในหัวข้อ "แหล่งข้อมูลต่างกันตรงไหน" ด้านล่าง
ทำไม AI ตัวเก่าถึงชนะ
AI จำภาพแบบ CNN ถูกสร้างมาเพื่อดูภาพแล้วจัดหมวดหมู่เพียงอย่างเดียว เมื่อฝึกต่อด้วยภาพผิวหนังหลายหมื่นภาพ มันจึงเหลือหน้าที่เดียวคือแยกโรคจาก 6–9 กลุ่ม ส่วนแชตบอตอย่าง GPT-6 Astra และ Claude Fable 5.1 เป็นโมเดลภาษาขนาดใหญ่ (LLM) ที่ดูภาพได้ด้วย แต่ไม่ได้ฝึกมาเพื่อโรคผิวหนังโดยเฉพาะ และไม่ได้รับการรับรองเป็นเครื่องมือแพทย์ Lynch เขียนว่าเขาคาดว่าแชตบอตจะทำได้ใกล้เคียงกัน จึงแปลกใจที่ช่องว่างกว้างขนาดนี้
โครงสร้าง Inception v3 เคยเป็นข่าวในวงการผิวหนังมาก่อน งานของทีม Stanford ที่ตีพิมพ์ใน Nature เมื่อต้นปี 2017 ฝึก CNN ที่ The Register รายงานว่าสร้างบน Inception v3 ของ Google ด้วยภาพ 129,450 ภาพจาก 2,032 โรค แล้วพบว่าแยกมะเร็งผิวหนังได้ใกล้เคียงแพทย์ผิวหนัง 21 คนในงานทดสอบเฉพาะสองงาน งานของ Lynch จึงไม่ได้บอกว่า CNN เพิ่งเก่งขึ้น แต่บอกว่าแชตบอตรุ่นล่าสุดยังตามงานเฉพาะทางที่มีมาเกือบสิบปีไม่ทัน
ผู้ใช้ Hacker News ซึ่งดันข่าวนี้ขึ้นไปกว่า 600 คะแนนและแสดงความเห็นกว่า 260 รายการ ส่วนใหญ่มองว่าผลนี้ไม่น่าแปลกใจ เพราะงานเฉพาะทางชนะงานทั่วไปเป็นเรื่องปกติ แต่ก็มีข้อแย้งที่ควรรู้
- CNN ได้เปรียบเรื่องข้อมูล: ผู้ใช้รายหนึ่งชี้ว่า CNN ฝึกจากคลังภาพเดียวกับที่ภาพทดสอบมา จึงเก่งกับภาพลักษณะนี้ แต่อาจทำได้แย่กับภาพถ่ายทั่วไปนอกคลินิก ReadEval ตรวจแล้วพบว่า MILK study team ซึ่งเป็นเจ้าของภาพทดสอบอยู่ในรายชื่อผู้ให้ข้อมูลฝึกของ CNN ด้วย แม้ Lynch จะตัดรอยโรคและคนไข้รายเดียวกันออกแล้ว
- แชตบอตไม่ได้ข้อมูลประกอบ: อีกรายชี้ว่าแชตบอตรับข้อมูลอื่นอย่างอายุหรือประวัติได้ แต่การทดสอบนี้ให้แค่ภาพ Lynch เองเปิดให้คนอื่นลองเพิ่มอายุและตำแหน่งบนร่างกายแล้วส่งผลมาเทียบ
- กลับหัวข่าวได้: มีผู้ใช้ชี้ว่าถ้ามองที่การปล่อยมะเร็งกลับบ้าน แชตบอตทำได้ดีกว่า CNN ตามเกณฑ์ตั้งต้น ซึ่งเป็นความผิดพลาดที่อันตรายที่สุดสำหรับเครื่องมือที่คนทั่วไปใช้
ข้อจำกัดที่ผู้เขียนยอมรับเอง
- ตัวเลขน้อย: 200 รายพอเห็นแนวโน้ม แต่ไม่พอจัดอันดับผลที่ใกล้กัน และเมลาโนมา 30 รายให้ความไม่แน่นอนกว้างในตัวเลขที่สำคัญที่สุด จึงไม่ควรสรุปว่าแชตบอตตัวไหนดีกว่าอีกตัว
- ถามครั้งเดียว: คำตอบของแชตบอตเปลี่ยนได้ระหว่างการถามแต่ละครั้ง
- รายที่ยาก: ทุกรายถูกตัดชิ้นเนื้อ รอยโรคที่ไม่อันตรายในชุดนี้จึงเป็นรายที่ดูน่าสงสัย กับภาพทั่วไปจากคลัง CNN แยกรายที่ควรและไม่ควรปล่อยได้ดีกว่ามาก (พื้นที่ใต้กราฟ ROC 0.96 เทียบกับ 0.86 ในชุดนี้ ตัวเลขยิ่งใกล้ 1 ยิ่งแยกได้ดี)
- ภาพอาจหลุดไปอยู่ในข้อมูลฝึกของแชตบอต: MILK10k เปิดสาธารณะตั้งแต่ปี 2025 แชตบอตจึงอาจเคยเห็นภาพเหล่านี้ ซึ่ง Lynch มองว่าถ้าเป็นเช่นนั้นก็น่าจะช่วยแชตบอต ไม่ใช่ถ่วง ส่วน CNN ไม่เคยเห็นแน่นอน
- ไม่ใช่ AI ผิวหนังที่ดีที่สุด: Inception v3 เป็นเพียงจุดเทียบ AI ผิวหนังระดับแนวหน้าในปัจจุบันใช้โมเดลหลายตัวร่วมกันและฝึกด้วยข้อมูลมากกว่า
- สีผิว: หน้าชุดข้อมูล MILK10k ระบุว่าคนไข้ส่วนใหญ่มีสีผิวระดับกลาง และหน้าโมเดลของ Lynch ระบุว่ามีภาพผิวคล้ำน้อย ReadEval จึงยืนยันไม่ได้ว่าผลนี้ใช้กับผิวของคนไทยได้แค่ไหน
Lynch ยังเปิดเผยว่าเขาออกแบบการทดสอบและตัดสินทางคลินิกเอง แต่ใช้ Claude Code เครื่องมือเขียนโค้ดของ Anthropic ช่วยวิเคราะห์และร่างบทความ ขณะที่หนึ่งในสองโมเดลที่ทดสอบก็เป็นของ Anthropic ส่วนการให้คะแนนใช้สคริปต์เทียบกับผลชิ้นเนื้อ
ความน่าเชื่อถือตามเกณฑ์ของ ReadEval
| เกณฑ์ | ผ่านไหม | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ผ่าน | เปิดรายชื่อภาพ คำสั่ง คำตอบทุกข้อ และสคริปต์ให้คะแนน ภาพอยู่ในชุดข้อมูลสาธารณะ และ CNN ลองได้ในเบราว์เซอร์ (แต่ไม่มีคำตอบรายภาพของ CNN) |
| บอกสภาพแวดล้อมครบ | ผ่าน | ระบุรุ่นโมเดล ช่องทางเรียก ค่าตั้งต้น และวิธีฝึก CNN |
| วัดหลายรอบ | ไม่ผ่าน | ถามรายละครั้งเดียว มีเพียงหนึ่งรายที่ถามซ้ำ |
| เทียบอย่างยุติธรรม | ไม่ผ่าน | CNN ฝึกจากคลังภาพแหล่งเดียวกับชุดทดสอบ ส่วนแชตบอตไม่ได้ข้อมูลประกอบ และเกณฑ์ปล่อยกลับบ้านของสองฝั่งไม่ได้ตั้งแบบเดียวกัน |
| เป็นอิสระ | ไม่ผ่าน | ไม่ได้ขายโมเดลใด แต่ผู้ทดสอบเป็นคนฝึก CNN ที่ชนะเอง และยังไม่มีบุคคลที่สามทำซ้ำ |
| ยอมรับข้อจำกัด | ผ่าน | ระบุจำนวนน้อย การถามครั้งเดียว รายที่ยาก และโอกาสที่ภาพหลุดไปอยู่ในข้อมูลฝึก |
ผลรวม 3 จาก 6 ข้อ 🟡 พอใช้อ้างอิงได้ ใช้เป็นสัญญาณเตือนได้ แต่ยังไม่ควรใช้จัดอันดับว่า AI ตัวไหนดีกว่ากัน
ถ้ากังวลเรื่องไฝ ควรทำอย่างไร
อย่าใช้แชตบอต แอป หรือ AI ตัวใดตัดสินว่าไม่ต้องไปหาหมอ หน้าเว็บของ CNN ที่ Lynch เปิดให้ลองเองก็เขียนเตือนว่า "มันจะพลาดมะเร็งผิวหนัง รวมถึงเมลาโนมา" ห้ามใช้ตัดสินว่าควรไปพบแพทย์หรือไม่ และถ้ากังวลเรื่องไฝหรือรอยบนผิว ให้ไปพบแพทย์หรือแพทย์ผิวหนัง
NHS บริการสุขภาพของอังกฤษ ระบุว่าไฝใหม่หรือไฝเดิมที่เปลี่ยนไปอาจเป็นสัญญาณของเมลาโนมา และแนะนำให้ไปพบแพทย์ถ้า
- มีไฝที่เปลี่ยนขนาด รูปร่าง หรือสี
- มีไฝที่เจ็บหรือคัน
- มีไฝที่อักเสบ มีเลือดออก หรือตกสะเก็ด
- มีรอยใหม่หรือรอยแปลกบนผิวที่ไม่หายไปในไม่กี่สัปดาห์ รวมถึงที่ฝ่ามือหรือฝ่าเท้า
- มีรอยสีเข้มใต้เล็บที่ไม่ได้เกิดจากการกระแทก
สัญญาณอื่นที่ NHS ระบุ ได้แก่ ไฝที่ขอบหรือรูปร่างไม่สม่ำเสมอ ไฝที่มีหลายสีปนกัน และไฝขนาดใหญ่ การทดสอบนี้แสดงว่าแม้มีทั้งภาพถ่ายและภาพจากกล้องส่องผิวหนัง AI ก็ยังพลาดเมลาโนมาได้ ภาพในโทรศัพท์จึงไม่ใช่สิ่งที่ใช้แทนการตรวจ ส่วนการยืนยันว่าเป็นมะเร็งหรือไม่ต้องตัดชิ้นเนื้อตรวจ เหมือนทุกรายในชุดทดสอบนี้
แหล่งข้อมูลต่างกันตรงไหน
- บทความสองฉบับ: Lynch เผยแพร่ "Can frontier LLMs diagnose skin cancer?" บนเว็บไซต์ drmagnuslynch.com เมื่อ 11 ต.ค. 2026 ซึ่งทดสอบเฉพาะแชตบอต แล้วเผยแพร่ฉบับที่เพิ่ม CNN บน lynchlab.net เมื่อ 25 ต.ค. 2026 ตัวเลขของแชตบอตในสองฉบับตรงกัน ReadEval ใช้ฉบับ 25 ต.ค. เป็นหลัก และใช้ฉบับแรกเฉพาะรายละเอียดที่ฉบับหลังตัดออก
- การปล่อยเมลาโนมาของ CNN: บทความ 25 ต.ค. ระบุว่า CNN ปล่อยเมลาโนมา 18 จาก 30 ราย แต่หน้าโมเดลระบุว่าเมลาโนมาที่คะแนนต่ำกว่าเกณฑ์มี 6 จาก 30 รายเมื่อดูภาพจากกล้องส่องผิวหนัง และ 14 จาก 30 รายเมื่อดูภาพถ่ายธรรมดา โดยไม่ได้บอกผลเมื่อรวมสองภาพ ReadEval อธิบายไม่ได้ว่าตัวเลข 18 มาจากการรวมคะแนนอย่างไร และตรวจซ้ำไม่ได้เพราะไม่มีผลรายภาพของ CNN จึงใช้ตัวเลข 18 ตามตารางในบทความหลัก
- ความแม่นของ CNN กับภาพทั่วไป: บทความหลักให้พื้นที่ใต้กราฟ ROC 0.96 แต่หน้าโมเดลให้ 0.944 สำหรับการแยกรอยโรคร้ายกับไม่ร้าย (0.875 เฉพาะภาพที่ยืนยันด้วยชิ้นเนื้อ) สองค่านี้อาจวัดคนละโจทย์ เพราะบทความหลักพูดถึงการแยกรายที่ควรและไม่ควรปล่อย ซึ่งนับแอกทินิกเคอราโทซิสด้วย
- การแนะนำให้ไปพบแพทย์: ReadEval เปิดไฟล์จัดหมวดคำตอบแบบคนไข้ของเมลาโนมา 100 รายดู พบว่า GPT-6 Astra ถูกจัดเป็น "แนะนำให้ไปพบแพทย์ชัดเจน" หรือ "ด่วน" ทั้ง 100 ราย โดยหนึ่งรายที่ Lynch อ่านแล้วเห็นว่าแนะนำให้ไปเฉพาะเมื่อแผลไม่หาย ส่วน Claude Fable 5.1 ถูกจัดเป็นสองหมวดนี้ 85 ราย อีก 14 รายเป็น "แนะนำตรวจแบบไม่เร่งด่วนหรือตามสะดวก" และ 1 รายเป็น "ปล่อยไว้ได้" ตัวเลข 98 ในบทความจึงน่าจะนับคำแนะนำแบบไม่เร่งด่วนรวมด้วย และนับจากการอ่านของ Lynch เองในรายก้ำกึ่ง ReadEval ใช้ตัวเลขของผู้เขียน แต่ขอให้ผู้อ่านรู้ว่าบางคำแนะนำไม่ได้เร่งให้ไปทันที
- ตำแหน่งของผู้เขียน: บทความระบุว่า Lynch เป็น Honorary Reader (เทียบเท่ารองศาสตราจารย์) ที่ King's College London ส่วนหน้าแพทย์ของโรงพยาบาล Guy's and St Thomas' ยังเขียนว่าเป็น honorary senior lecturer และระบุว่าเขาเป็นผู้นำการประชุมสหสาขาด้านเมลาโนมาของโรงพยาบาล ReadEval จึงเรียกรวมว่าอาจารย์กิตติมศักดิ์
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
แชตบอตเก่งทุกเรื่องยังไม่ใช่หมอผิวหนัง และ AI เฉพาะทางที่ทายเก่งกว่าก็ยังไม่ใช่เช่นกัน ข้อดีของงานนี้คือเปิดข้อมูลให้ตรวจซ้ำได้จริง ReadEval นับผลของแชตบอตซ้ำแล้วตรงทุกตัวเลข แต่หัวข่าว "62% ต่อ 42%" เล่าเพียงครึ่งเดียว อีกครึ่งคือ CNN ที่ชนะเรื่องทายชื่อโรคกลับปล่อยเมลาโนมามากกว่าเมื่อใช้เกณฑ์ตั้งต้น ส่วนแชตบอตที่ดูปลอดภัยนั้นปลอดภัยเพราะส่งเกือบทุกคนไปหาหมอ ไม่ใช่เพราะมองออก บทเรียนที่ใช้ได้กับคนทั่วไปจึงไม่ใช่การเลือกว่า AI ตัวไหนดีกว่า แต่คือคำตอบที่ฟังคล่องและใช้ศัพท์ถูกต้องไม่ได้แปลว่าถูก โดยเฉพาะเรื่องที่พลาดแล้วมีราคาแพงอย่างมะเร็งผิวหนัง ถ้าไฝของคุณเปลี่ยนไป คำตอบที่ปลอดภัยที่สุดยังเป็นการไปพบแพทย์ ไม่ใช่การถามแชตบอตซ้ำจนได้คำตอบที่สบายใจ
แหล่งที่มา
- Lynch Lab: A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis (Magnus Lynch, 25 ต.ค. 2026)
- Dr Magnus Lynch: Can frontier LLMs diagnose skin cancer? (ฉบับแรก 11 ต.ค. 2026)
- ไฟล์ข้อมูลการทดสอบ: รายชื่อภาพ คำสั่ง คำตอบของแชตบอต และสคริปต์ให้คะแนน
- Lynch Lab: Inception v3 skin lesion classifier (หน้าโมเดลและวิธีฝึก)
- Hacker News: กระทู้ถกเรื่องบทความนี้
- Guy's and St Thomas' NHS Foundation Trust: ประวัติแพทย์ Magnus Lynch
- ISIC Archive: ชุดข้อมูล MILK10k
- arXiv: Rethinking the Inception Architecture for Computer Vision (Szegedy และคณะ, ธ.ค. 2015)
- Nature: Dermatologist-level classification of skin cancer with deep neural networks (Esteva และคณะ, 2017)
- The Register: AI eggheads: Our cancer-spotting code rivals dermatologists (ม.ค. 2017)
- NHS: Symptoms of melanoma skin cancer