Gemini 4 Argon มาถึงสมาชิก AI Pro แล้ว ผลวัดอิสระชี้อยู่แนวหน้า แต่ไม่ได้ชนะทุกด้าน
สมาชิก AI Pro และ Ultra ใช้ Gemini 4 Argon ในแอปและโหมด AI ได้แล้ว ผลวัดอิสระให้คะแนนเท่า GPT-6 Astra แต่ยังตาม Claude Opus 5.5 คะแนนของ Google เป็นคำกล่าวอ้าง
สารบัญ (9 หัวข้อ)
ตารางคะแนนที่ Google เผยแพร่บอกว่า Gemini 4 Argon โมเดลเรือธงตัวใหม่ นำคู่แข่งอย่าง GPT-6 Astra ของ OpenAI และ Claude Opus 5.5 ของ Anthropic ใน 12 จาก 18 การทดสอบ แต่ในวันเดียวกับที่เปิดตัว Bloomberg รายงานว่าพนักงาน Google บางคนที่ได้ลองใช้บอกว่า พอเอาไปทำงานจริง โมเดลนี้ไม่ได้เก่งเท่าคะแนน โดยเฉพาะงานเขียนโค้ดบางประเภทและการออกแบบหน้าตาเว็บไซต์
ตั้งแต่กลางเดือนตุลาคม คนทั่วไปลองเองได้แล้ว Google ทยอยเปิด Argon ในแอป Gemini และโหมด AI ของ Google Search ให้สมาชิกแพ็กเกจ Google AI Pro และ AI Ultra ทั่วโลก หลังช่วงแรกให้ใช้เฉพาะทีมความปลอดภัยไซเบอร์ที่คัดเลือกไว้ ในไทย AI Pro ราคาเดือนละ 750 บาท และไทยอยู่ในรายชื่อประเทศที่ใช้ Argon ในโหมด AI ได้ Google บอกว่า Argon ตอบตรงประเด็นขึ้น พูดอ้อมน้อยลง และกำลังเข้ามาแทนโหมด Deep Think เดิม ส่วนผู้ใช้ฟรีและสมาชิก AI Plus ยังเลือกใช้ไม่ได้
ที่คนในสงสัยเพราะวงการ AI มีปัญหาที่เรียกว่า benchmaxxing คือปรับโมเดลให้ทำคะแนนในชุดทดสอบได้สูง เหมือนนักเรียนที่ติวข้อสอบเก่าจนคะแนนดี แต่เจองานจริงกลับไม่คล่องเท่า Google ตอบว่าไม่ถูกต้องที่จะบอกว่าโมเดลนี้ด้อยเรื่องเขียนโค้ด ต่างจากนักเรียนตรงที่โมเดล AI ถูกคนนอกจับสอบด้วยข้อสอบชุดอื่นได้ตลอด และผลจากคนนอกก็ออกมาแล้ว
Artificial Analysis ผู้วัดอิสระ ให้ Argon คะแนนเท่ากับ GPT-6 Astra แต่ต่ำกว่า Claude Opus 5.5 จุดเด่นคือใช้ต้นทุนต่อโจทย์ต่ำกว่าทั้งคู่ ส่วนกระดาน Arena ที่ให้ผู้ใช้โหวตคำตอบโดยไม่รู้ชื่อโมเดล Argon ขึ้นที่หนึ่งในหมวดข้อความ (ผลเบื้องต้น) แต่อยู่อันดับ 8 ในหมวดสร้างเว็บ ซึ่งตรงกับจุดที่พนักงานกังวล พูดง่าย ๆ คือ Argon อยู่แนวหน้าจริง แต่ไม่ได้ชนะทุกด้านอย่างที่ตารางของ Google ชวนให้เข้าใจ
ถ้าคุณเป็นสมาชิก AI Pro อยู่แล้ว ลองแตะเมนูโมเดลแล้วเลือก 4 Argon กับงานที่ทำประจำ เทียบกับโมเดล Pro เดิมดูว่าต่างกันไหม ถ้ายังใช้แบบฟรีหรือ AI Plus ยังไม่ต้องรีบอัปเกรดเพื่อ Argon อย่างเดียว ดูก่อนว่างานของคุณต้องการโมเดลที่คิดลึกขนาดนั้นไหม ตารางสิทธิ์และราคา วิธีเลือกโมเดล และคะแนนของ Google เทียบผลวัดอิสระอยู่ด้านล่าง
สรุปประเด็นสำคัญ
- ใครใช้ได้: สมาชิก Google AI Pro (750 บาทต่อเดือนในไทย) และ AI Ultra ในแอป Gemini และโหมด AI ของ Search ตั้งแต่ 13 ต.ค. 2026 Google ระบุว่าเปิด "ทั่วโลก" และไทยอยู่ในรายชื่อประเทศของโหมด AI ส่วนแบบฟรีและ AI Plus ใช้ไม่ได้
- คะแนนของ Google เป็นคำกล่าวอ้าง: Google วัดบางชุดเองด้วยเครื่องมือของตัวเอง และในตารางของ Google เอง Argon ก็ยังแพ้คู่แข่งบางรายการ รวมถึงการทดสอบเขียนโค้ด 2 จาก 4 ชุด
- ผลวัดอิสระ: Artificial Analysis ให้ 53 คะแนน เท่ากับ GPT-6 Astra แต่ต่ำกว่า Claude Opus 5.5 ที่ได้ 58 ส่วน Arena ให้ที่หนึ่งหมวดข้อความแบบผลเบื้องต้น แต่อันดับ 8 หมวดสร้างเว็บ
- ข้อกังวลจากคนใน: Bloomberg อ้างพนักงานบางคนว่า Argon ทำงานเขียนโค้ดบางอย่างและงานออกแบบหน้าเว็บได้ไม่ดีเท่าคะแนน Google ปฏิเสธ และพนักงานอีกส่วนเห็นว่าโมเดลอยู่แนวหน้าแล้ว
ใครใช้ได้ ราคาเท่าไร และใช้ในไทยได้ไหม
| แพ็กเกจ | ราคาไทย (ต่อเดือน) | ราคาสหรัฐฯ (ต่อเดือน) | Argon ในแอป Gemini | Argon ในโหมด AI ของ Search |
|---|---|---|---|---|
| ฟรี | 0 บาท | 0 ดอลลาร์ | ไม่ได้ | ไม่ได้ |
| Google AI Plus | 189 บาท | 4.99 ดอลลาร์ | ไม่ได้ | ไม่ได้ |
| Google AI Pro | 750 บาท | 19.99 ดอลลาร์ | ได้ | ได้ (หน้าแพ็กเกจสหรัฐฯ เขียนว่า "Higher access") |
| Google AI Ultra | 3,500 หรือ 7,500 บาท | 99.99 หรือ 199.99 ดอลลาร์ | ได้ ในระดับสูงสุด | ได้ ในระดับสูงสุด |
ราคาและสิทธิ์มาจากหน้าแพ็กเกจของ Google ทั้งฉบับภาษาไทยและฉบับสหรัฐฯ (ตรวจเมื่อ 26 ต.ค. 2026) หน้าภาษาไทยระบุ "สิทธิ์เข้าถึง Gemini 4 Argon" ไว้ในแพ็กเกจ AI Pro และ "Highest access to Gemini 4 Argon" ในแพ็กเกจ AI Ultra ส่วน AI Plus ไม่มี Argon อยู่ในรายการ ราคาบาทเป็นราคาที่ Google ตั้งสำหรับไทย ไม่ใช่การแปลงค่าเงิน
ใช้ได้มากแค่ไหน: Google ไม่ได้บอกจำนวนครั้งที่ใช้ Argon ได้เป็นตัวเลข หน้าช่วยเหลือของ Gemini ระบุว่าโควตาในแอปคำนวณตามปริมาณการประมวลผล รีเฟรชทุก 5 ชั่วโมงจนกว่าจะถึงเพดานรายสัปดาห์ โดย AI Pro ได้โควตา 4 เท่าของแบบฟรี และ AI Ultra ได้ 5 หรือ 20 เท่าของ AI Pro ส่วนในโหมด AI หน้าช่วยเหลือของ Google Search ระบุว่า Argon "มีขีดจำกัดการใช้งานรายวัน" ซึ่งอาจเปลี่ยนตามความจุของระบบและแพ็กเกจของคุณ
เงื่อนไขของโหมด AI: ต้องล็อกอินด้วยบัญชี Google ส่วนตัวที่คุณจัดการเอง และต้องอายุ 18 ปีขึ้นไป หน้าช่วยเหลือของ Google Search มีรายชื่อประเทศที่ใช้ Argon ในโหมด AI ได้ และไทยอยู่ในรายชื่อนั้น
สิ่งที่ยังไม่ยืนยัน: Google ไม่ได้เผยแพร่ผลทดสอบภาษาไทยของ Argon ReadEval จึงยังบอกไม่ได้ว่า Argon ตอบภาษาไทยดีกว่าโมเดล Pro เดิมแค่ไหน และหน้าแพ็กเกจของไทยไม่ได้ระบุเงื่อนไขทดลองใช้ฟรีไว้ชัดเจน
ส่วนการเปลี่ยนแปลงสิทธิ์ของแบบฟรีและ AI Plus ในเดือนเดียวกัน (แบบฟรีเหลือโหมด Auto และ AI Plus เสียโมเดล Pro) อ่านรายละเอียดได้ในข่าว "Gemini ฟรีเลือกโมเดลเองไม่ได้ ใช้ Flash-Lite เป็นหลัก ส่วนสมาชิก AI Plus ทยอยเสียโมเดล Pro" ของ ReadEval
เลือกใช้ Argon อย่างไร
ในแอป Gemini (เว็บ gemini.google.com หรือแอปมือถือ)
- ล็อกอินด้วยบัญชีที่สมัคร AI Pro หรือ AI Ultra
- แตะหรือคลิกชื่อโมเดล (บนเว็บอยู่ที่ช่องพิมพ์ด้านล่าง บนมือถืออยู่มุมซ้ายบน)
- เลือก 4 Argon จากรายการ ซึ่ง 9to5Google รายงานว่าสมาชิก AI Pro และ Ultra จะเห็น 4 ตัวเลือก คือ 3.5 Flash-Lite, 3.8 Flash, 3.1 Pro และ 4 Argon
- เลือกระดับการคิด (Low, Medium หรือ High) ถ้าต้องการ ระดับสูงให้คำตอบละเอียดขึ้นแต่ใช้โควตามากขึ้น
ถ้าไม่เห็น 4 Argon ในรายการ อาจเป็นเพราะ Google ยังทยอยเปิดอยู่ หรือบัญชีของคุณไม่ได้อยู่ในแพ็กเกจที่มีสิทธิ์ ตรวจแพ็กเกจได้ที่ Settings & help แล้วเลือก View Subscriptions หรือตัวเลือกอัปเกรด
ในโหมด AI ของ Google Search
- ล็อกอินบัญชี Google ส่วนตัว แล้วเปิดโหมด AI
- เปิดเมนูในช่อง "Ask anything" แล้วเลือก Gemini 4 Argon
- Google แนะนำว่าโมเดล "Auto" หรือ "Fast" ยังเหมาะกับคำถามทั่วไปส่วนใหญ่ ส่วน Argon เหมาะกับคำถามที่ซับซ้อนหลายขั้น
ใช้แล้วจะเห็นอะไรต่างไป
สิ่งที่ Google และสื่อที่ได้รับข้อมูลจาก Google ระบุ (ยังเป็นคำบอกเล่าของบริษัท ไม่ใช่ผลทดสอบของ ReadEval)
- คำตอบตรงขึ้น: Google บอกว่า Argon ตอบตรงประเด็นขึ้น พูดอ้อมหรือออกตัวน้อยลง พูดซ้ำน้อยลง เลี่ยงสำนวนซ้ำซาก และทำตามคำสั่งเรื่องสไตล์การเขียนได้สม่ำเสมอกว่ารุ่นก่อน
- งานยาวบอกความคืบหน้า: เมื่อทำงานที่ใช้เวลานาน Argon จะรายงานความคืบหน้าบ่อยขึ้น และ Engadget อ้าง Josh Woodward รองประธานฝ่ายผลิตภัณฑ์ของ Gemini และ Google Labs ว่าโมเดลส่งคำตอบบางส่วนให้ดูได้ระหว่างที่ยังคิดอยู่
- ปุ่มสลับแชตกับงาน (Tasks): มีปุ่มในหน้าแชตสำหรับสลับไปสั่งงานให้ Gemini ทำต่อแม้คุณไม่ได้อยู่หน้าคอมพิวเตอร์ และบน macOS สลับไปหน้าเขียนโค้ดแบบ agent ของ Google Antigravity ได้ในแอปเดียว
- มาแทน Deep Think: หน้าช่วยเหลือของ Google ระบุว่า "Deep Think กำลังถูกแทนที่ด้วย Gemini 4 Argon" และอ้างว่า Argon ทำได้เกินกว่าที่ Deep Think เคยทำได้ เดิม Deep Think มีเฉพาะสมาชิก AI Ultra
- ในโหมด AI: Google บอกว่า Argon เข้าใจเจตนาและทำตามคำสั่งในบทสนทนาหลายรอบได้ดีขึ้น
เรื่องความเร็ว: Artificial Analysis วัดผ่าน API ได้ว่า Argon สร้างข้อความราว 80.8 token ต่อวินาที ขณะที่ Gemini 3.1 Pro Preview ได้ราว 130.2 token ต่อวินาที และ Argon ใช้ token ในการทำชุดทดสอบมากกว่าค่ากลาง ReadEval ประเมินว่าคำตอบยาว ๆ จาก Argon อาจขึ้นช้ากว่าโมเดล Pro เดิมให้เห็นได้ แต่ตัวเลขนี้วัดผ่าน API ไม่ใช่ในแอป ความเร็วที่คุณเจอจริงจึงอาจต่างไป
คะแนนของ Google บอกอะไร และไม่ได้บอกอะไร
Google เปิดตัว Argon เมื่อ 30 ก.ย. 2026 พร้อมตาราง 18 การทดสอบที่ Argon นำ 12 รายการ เสมอ 1 และตามหลัง 5 ตามที่ Decrypt สรุป ตัวอย่างตัวเลขที่สื่อรายงานจากตารางของ Google มีดังนี้
| การทดสอบ | วัดอะไร | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | หมายเหตุ |
|---|---|---|---|---|---|
| DeepSWE v1.1 | งานพัฒนาซอฟต์แวร์จริงที่ใช้เวลานาน | 77.9% | 74.1% | 74.2% | Google วัด Argon เอง ส่วนตัวเลขคู่แข่งมาจาก leaderboard และรายงานของแต่ละบริษัท |
| FrontierSWE v2 | งานพัฒนาซอฟต์แวร์ (ชุดทดสอบภายนอก) | 55% | 65.5% | 62.3% | Argon ตามหลังทั้งคู่ |
| CWE-bench v1 | หาช่องโหว่ในโค้ด | 68% | 68% | ไม่มีข้อมูล | เสมอกับ GPT-6 Astra |
| Gray Swan (prompt injection ทางอ้อม) | สัดส่วนการโจมตีที่สำเร็จใน 15 ครั้ง (ยิ่งต่ำยิ่งดี) | 0.7% | 8.5% | 1.0% | ไม่ระบุว่าใครเป็นผู้วัด |
ข้อมูล: Decrypt และ ForkLog ซึ่งอ้างตารางของ Google · ช่อง "ไม่มีข้อมูล" คือสื่อไม่ได้รายงานตัวเลขนั้น
ระดับความน่าเชื่อถือของตาราง Google: 🔴 คำกล่าวอ้าง ตามเกณฑ์ของ ReadEval ตารางนี้ผ่านเพียงข้อ "ยอมรับข้อจำกัด" บางส่วน (Google แสดงรายการที่แพ้ด้วย) แต่ผู้วัดคือผู้ขายเอง บางชุดใช้เครื่องมือวัดของ Google ขณะที่ตัวเลขคู่แข่งมาจากแหล่งอื่น จึงเทียบกันตรง ๆ ไม่ได้ และ Reuters รายงานว่าในการทดสอบด้านเขียนโค้ด 4 ชุดที่ Google ใส่ไว้ในประกาศ Argon ตามหลังคู่แข่ง 2 ชุด ข้อนี้สำคัญเพราะงานเขียนโค้ดคือจุดเดียวกับที่พนักงานบางคนกังวล
ผู้วัดอิสระบอกอะไร
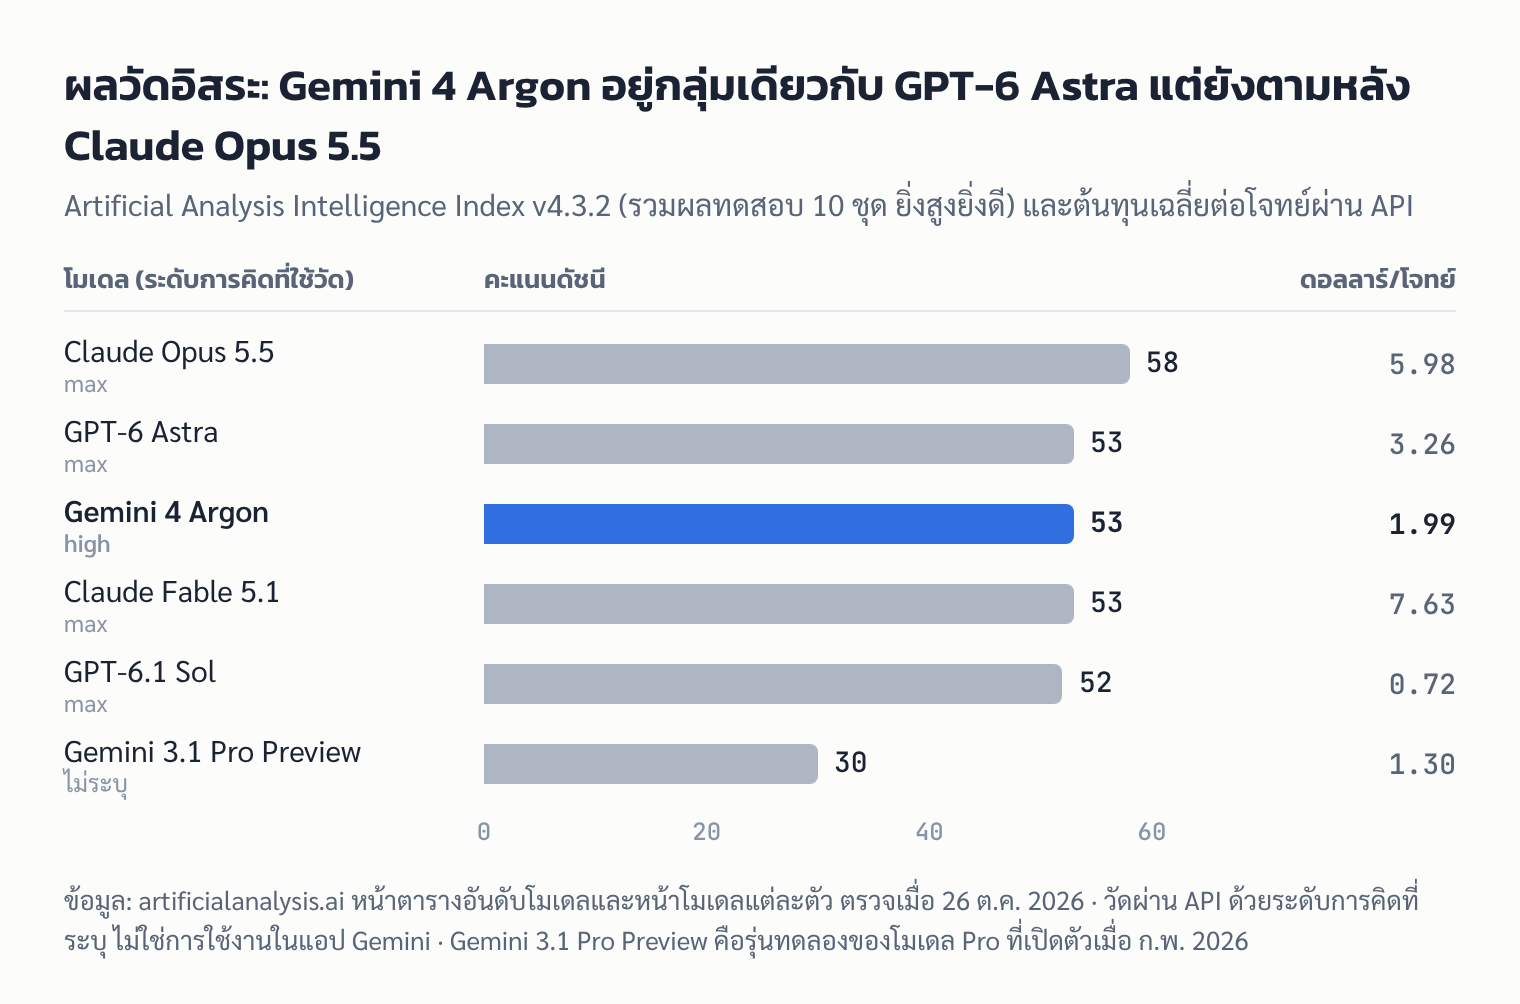
Artificial Analysis รวมผลทดสอบ 10 ชุดเป็นดัชนีเดียว และวัดทุกโมเดลด้วยวิธีเดียวกัน ณ 26 ต.ค. 2026 Argon (ระดับการคิด high) ได้ 53 คะแนน เท่ากับ GPT-6 Astra (max) และ Claude Fable 5.1 (max) แต่ต่ำกว่า Claude Opus 5.5 (max) ที่ได้ 58 จุดที่ Argon เด่นคือต้นทุน ใช้เงินเฉลี่ย 1.99 ดอลลาร์ต่อโจทย์ หรือราว 61% ของ GPT-6 Astra ที่ใช้ 3.26 ดอลลาร์ ใกล้กับที่ Engadget รายงานว่าคะแนนเท่ากันที่ราว 60% ของต้นทุน ในดัชนีเดียวกัน Gemini 3.1 Pro Preview ได้ 30 คะแนน ReadEval ประเมินว่าถ้าโมเดล 3.1 Pro ในแอปใกล้เคียงรุ่น Preview ที่ถูกวัดไว้ Argon ก็เป็นการขยับขึ้นที่ชัดเจนสำหรับสมาชิก AI Pro
เมื่อแยกตามสายงาน Artificial Analysis จัดให้ Argon อยู่อันดับ 3 ด้านกฎหมาย และอันดับ 4 ด้านวิศวกรรมกับเศรษฐศาสตร์ แต่อยู่อันดับ 6 ด้านการเงินและกลยุทธ์ และอันดับ 8 ด้านสุขภาพ ทุกสายงาน Claude Opus 5.5 ได้อันดับหนึ่ง
Arena (เดิมชื่อ LMArena) ให้ผู้ใช้ส่งคำถามแล้วโหวตเลือกคำตอบที่ชอบกว่าโดยไม่รู้ชื่อโมเดล Arena โพสต์บน X ว่า Argon (High) ขึ้นอันดับ 1 ใน Text Arena ด้วย 1,525 คะแนน และอยู่อันดับ 8 ใน Code Arena หมวด WebDev ด้วย 1,679 คะแนน บทความใน DEV Community ที่บันทึกกระดานไว้ช่วงต้นเดือนตุลาคมระบุว่าคะแนนของ Argon ทุกหมวดยังติดป้าย "Preliminary" (ผลเบื้องต้น) และมาจากราว 4,900 โหวต เทียบกับโมเดลอันดับรองที่มีกว่า 77,000 โหวต ข้อควรรู้คือ Arena วัด "ความชอบ" ของผู้ใช้ ไม่ได้วัดว่าคำตอบถูกต้องหรือไม่
ระดับความน่าเชื่อถือของผลวัดอิสระ: 🟡 พอใช้อ้างอิงได้ ผู้วัดไม่ได้ขายโมเดล ใช้วิธีเดียวกันกับทุกโมเดล และวัดซ้ำต่อเนื่อง แต่ Artificial Analysis วัดผ่าน API ที่ระดับการคิดหนึ่ง ๆ ไม่ใช่ประสบการณ์ในแอป ส่วนคะแนน Arena ยังเป็นผลเบื้องต้นที่อาจขยับได้ และ ReadEval เห็นตัวเลข WebDev จากโพสต์ของ Arena เท่านั้น เพราะเปิดหน้ากระดานโดยตรงไม่ได้
พนักงาน Google พูดว่าอะไร และ Google ตอบอย่างไร
รายงานของ Julia Love และ Davey Alba จาก Bloomberg (เผยแพร่ซ้ำโดย The Star) อ้างคนในที่ไม่เปิดเผยชื่อหลายกลุ่ม
- ฝั่งที่กังวล: คนในบางส่วนบอกว่าคะแนนทดสอบที่ดีไม่ได้สะท้อนการทำงานจริง ความสามารถด้านเขียนโค้ดไม่สม่ำเสมอ โดยเฉพาะงานออกแบบหน้าตาแอปและเว็บไซต์ (front-end) คน 2 คนที่รู้เรื่องโมเดลบอกว่า Argon ดูเหมือนได้รับผลจาก benchmaxxing บางคนมองว่าโมเดลของ Anthropic และ OpenAI พัฒนาเร็วกว่า และรายงานยังระบุว่าโมเดลนี้ใหญ่มากจึงอาจมีต้นทุนการให้บริการสูง
- ฝั่งที่มั่นใจ: พนักงานอีกคนบอกว่าภายในบริษัทมี "ความเห็นตรงกันอย่างกว้างขวาง" ว่า Argon อยู่แนวหน้า ผู้สนับสนุนชี้ว่า Argon เด่นเรื่องการตีความข้อมูลที่ไม่ใช่ข้อความ เช่น ดึงข้อมูลจากวิดีโอ ความปลอดภัย การป้องกันภัยไซเบอร์ และการสื่อสารที่เป็นธรรมชาติ
- Google ตอบ: บริษัทบอกว่าไม่ถูกต้องที่จะกล่าวว่า Gemini 4 ทำได้ต่ำกว่าคาดในด้านอย่างการเขียนโค้ด และอ้างคำพูดของ Koray Kavukcuoglu หัวหน้า Google DeepMind ว่า "ผมไว้ใจทีมอย่างที่สุด" และ "ในความคิดผม เป็นเรื่องแน่นอนว่าเราจะอยู่แนวหน้าเสมอ"
- มุมมองคนนอก: Edwin Chen ผู้ก่อตั้ง Surge AI เรียก benchmaxxing ว่าเป็น "ปัญหาที่ร้ายกาจอย่างยิ่ง" และเปรียบคะแนนทดสอบกับคะแนนสอบ SAT ที่ไม่ได้บอกว่าคนคนนั้นจะทำงานจริงได้ดี
ข้อควรรู้คือพนักงานเหล่านี้ให้ความเห็นช่วงก่อนเปิดตัว ซึ่ง 9to5Google ระบุว่า Bloomberg ลงข่าว "ไม่นานก่อนหมดเวลาห้ามเผยแพร่" (embargo) ไม่มีชุดข้อมูลหรือวิธีทดสอบที่คนนอกตรวจซ้ำได้ ความเห็นนี้จึงเป็นข้อกล่าวอ้างที่ยังไม่ได้พิสูจน์ ทั้งในทางบวกและทางลบ
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- ก่อน 13 ต.ค. ใครได้ใช้: 9to5Google เขียนในข่าววันที่ 13 ต.ค. ว่าช่วงแรกเปิดเฉพาะสมาชิก AI Ultra แต่ Reuters, Decrypt, Engadget และจดหมายข่าวของ 9to5Google เองเมื่อ 1 ต.ค. รายงานตรงกันว่าช่วงแรกเปิดให้เฉพาะทีมป้องกันภัยไซเบอร์ในโครงการ Fairwind ของ Google ส่วนผู้ใช้ API แบบเสียเงินและ AI Ultra เป็นกลุ่มถัดไปโดยไม่มีวันที่ และ release notes ของแอป Gemini มีประกาศเกี่ยวกับ Argon เพียงฉบับเดียวคือ 13 ต.ค. ReadEval จึงยึดว่าผู้ใช้แอปทั่วไปเริ่มใช้ได้ตั้งแต่ 13 ต.ค. พร้อมกันทั้ง AI Pro และ Ultra
- อันดับใน Artificial Analysis: แต่ละหน้าแสดงอันดับต่างกัน (ที่ 8, 9 หรือ 10) เพราะมีหลายโมเดลได้คะแนนเท่ากันที่ 53 ReadEval จึงรายงานเป็นคะแนนแทนอันดับ
- "ชนะทุกหมวด" ใน Arena: บทความบางแห่งพาดหัวว่า Argon ชนะทุกหมวดของ Arena ซึ่งหมายถึงหมวดย่อยของ Text Arena เท่านั้น ไม่รวมหมวด WebDev ที่ Arena เองโพสต์ว่า Argon อยู่อันดับ 8
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
Argon เป็นโมเดลแนวหน้าจริง แต่ไม่ใช่ที่หนึ่งทุกด้าน และสำหรับคนส่วนใหญ่ยังไม่ใช่เหตุผลพอที่จะอัปเกรดแพ็กเกจเพื่อโมเดลนี้อย่างเดียว ผลวัดอิสระชี้ว่า Argon ขยับขึ้นจากโมเดล Pro รุ่นก่อนมาก และอยู่กลุ่มเดียวกับ GPT-6 Astra ด้วยต้นทุนที่ต่ำกว่า แต่ยังตามหลัง Claude Opus 5.5 ในดัชนีรวม และอันดับในหมวดสร้างเว็บก็สอดคล้องกับข้อกังวลของพนักงานเรื่องงาน front-end ReadEval ประเมินว่าตารางของ Google ไม่ได้ผิด แต่ชูด้านที่ชนะ ขณะที่ผลวัดอิสระวาง Argon ไว้กลุ่มเดียวกับคู่แข่ง ไม่ได้เหนือกว่าชัดเจน สำหรับสมาชิก AI Pro ที่จ่ายอยู่แล้ว Argon คือของแถมที่ควรลอง โดยเฉพาะงานคิดหลายขั้นหรืองานยาว ส่วนคนที่ใช้แบบฟรีหรือ AI Plus ควรถามตัวเองก่อนว่างานประจำของคุณติดตรงไหน ถ้าโมเดลที่มีอยู่ตอบได้ดีพอแล้ว ส่วนต่างหลายร้อยบาทต่อเดือนอาจไม่จำเป็น และถ้างานหลักของคุณคือเขียนโค้ดหรือออกแบบเว็บ ควรลองเทียบกับงานจริงของคุณเองก่อนเชื่อตารางคะแนนของบริษัทใดก็ตาม
แหล่งที่มา
- Google: Gemini Apps release notes (2026.10.13 Introducing Gemini 4 Argon)
- Google: Gemini 4 Argon is now available in the Gemini app
- Google: แพ็กเกจ Google AI (ราคาไทย)
- Google: Google AI plans (ราคาสหรัฐฯ)
- Google Search Help: AI Mode (Gemini 4 Argon in AI Mode, รายชื่อประเทศ)
- Google: Gemini Apps limits & feature availability
- Google: Changes to Gemini model access and limits
- Google: Use Deep Think in Gemini Apps
- Google: Manage your Google AI plan from Gemini Apps
- 9to5Google: Gemini 4 Argon rolling out to the Gemini app
- 9to5Google (Inbox newsletter): Gemini 4 Argon must reverse Google's AI inertia
- Engadget: Gemini 4 Argon now available in the Gemini app and AI Mode
- Search Engine Roundtable: Gemini 4 Argon in Google Search via AI Mode
- Bloomberg (via The Star): Google grapples with employee scepticism about new Gemini 4
- Reuters (via Khaleej Times): Google announces Gemini 4 flagship AI model after months of delays
- Decrypt: Gemini 4 Argon benchmarks and Fairwind rollout
- ForkLog: Google unveils flagship AI model Gemini 4 Argon
- Artificial Analysis: Intelligence Index leaderboard
- Artificial Analysis: Gemini 4 Argon
- Artificial Analysis: Gemini 3.1 Pro Preview
- Artificial Analysis: Capability Index by domain
- Arena on X: Gemini 4 Argon #1 Text Arena, #8 WebDev
- DEV Community: Gemini 4 Argon won every Arena category (preliminary votes)