Meta เลื่อนข้อกำหนดให้บอตเข้าเว็บไซต์ธุรกิจไปเริ่ม 20 พ.ย. ใช้กับทั้งคนยิงแอดและเจ้าของเพจ
ข้อกำหนดธุรกิจฉบับใหม่ของ Meta ให้บอตเข้าอ่านเว็บไซต์ที่ผูกกับสินค้าของคุณได้ ลบคำว่า "ฝึก" แล้วแต่ยังถูกวิจารณ์ เลื่อนไปมีผล 20 พ.ย. 2026
สารบัญ (9 หัวข้อ)
ถ้าคุณเคยกดยิงโฆษณาบน Facebook หรือ Instagram คุณอาจยอมรับไปแล้วโดยไม่รู้ตัวว่า Meta มีสิทธิ์เข้าไปอ่านเนื้อหาในเว็บไซต์ของคุณ เพื่อใช้ในงาน "วิจัยและฝึก (training)" ด้วย ข้อความนี้อยู่ในข้อกำหนดโฆษณาที่ใช้อยู่ตอนนี้ ส่วนข้อกำหนดฉบับใหม่ที่สำนักข่าวในสหรัฐฯ และยุโรปกำลังคัดค้านกลับลบคำว่า "ฝึก" ออก แต่ขยายสิทธิ์ไปทางอื่นแทน
Reuters รายงานเมื่อ 23 ต.ค. ว่า Meta เลื่อนข้อกำหนดชุดนี้จาก 30 ต.ค. ไปเริ่ม 20 พ.ย. หลังผู้ร้องเรียนยื่นเรื่องต่อหน่วยงานกำกับการแข่งขันในสหภาพยุโรปและอังกฤษ หัวใจของเรื่องคือย่อหน้าเดียวที่ให้ Meta หรือใครก็ตามที่ทำงานแทน ส่งโปรแกรมอัตโนมัติ (บอตเก็บข้อมูลเว็บ หรือ crawler) เข้าไปอ่าน เก็บสำเนา และดึงข้อมูลใหม่จากเว็บไซต์ที่ผูกกับสินค้าหรือบริการของคุณเป็นระยะ และสร้างบัญชีทดสอบเพื่อเข้าไปดูได้ด้วย
นึกภาพว่าคุณเช่าแผงในห้าง แล้วสัญญาเช่าฉบับใหม่เขียนว่าห้างส่งพนักงานไปเดินดูร้านจริงของคุณ จดรายการสินค้า และถ่ายรูปกลับมาได้ทุกเมื่อ ต่างกันตรงที่เว็บไซต์ของคุณเปิดให้คนทั่วไปเข้าดูอยู่แล้ว สิ่งที่เปลี่ยนคือคุณยินยอมไว้ในสัญญา Meta บอกว่าใช้เนื้อหาเพื่อ "พัฒนา ปรับปรุง วิจัย" ผลิตภัณฑ์โฆษณาและธุรกิจเท่านั้น และไม่ได้เปลี่ยนวิธีใช้บอต แต่ทนายความด้านสื่อในสหรัฐฯ มองว่าคำว่า "พัฒนา" กว้างพอจะรวมการฝึก AI อยู่แล้ว
จุดที่ร้านค้าไทยควรรู้คือ ข้อกำหนดทางการค้าฉบับใหม่ไม่ได้ผูกแค่คนจ่ายเงินยิงแอด แต่ครอบคลุมทุกคนที่ใช้ Meta ทำธุรกิจ ตั้งแต่ดูแลเพจ ลงขายสินค้า ไปจนถึงใช้ Meta Business Suite หน้าข้อกำหนดภาษาไทยก็ขึ้นประกาศวันเริ่มใหม่แล้ว และไม่มีปุ่มขอไม่รับ ถ้าใช้ต่อหลังวันนั้นถือว่ายอมรับ ทางเลือกอื่นคือเลิกใช้ Meta ทำธุรกิจ
สิ่งที่คุณทำได้ตอนนี้คืออ่านข้อกำหนดฉบับใหม่ แล้วเปิดดูไฟล์ robots.txt ของเว็บไซต์ร้าน ไฟล์นี้เหมือนป้าย "ขอไม่ให้เข้า" ที่บอตส่วนใหญ่ยอมทำตาม Meta บอกว่าจะเคารพป้ายนี้ แต่ป้ายไม่มีผลทางกฎหมาย และตัวข้อกำหนดก็ไม่ได้พูดถึงมันเลย ข้อความก่อนและหลังแก้ ชื่อบอตของ Meta แต่ละตัว และตัวอย่าง robots.txt อยู่ด้านล่าง
สรุปประเด็นสำคัญ
- เลื่อนวัน ไม่ได้เปลี่ยนเนื้อหา: Meta เลื่อนวันมีผลของ Commercial Terms และ Self-Serve Ad Terms ฉบับใหม่จาก 30 ต.ค. เป็น 20 พ.ย. 2026 ข้อความในหน้าตัวอย่าง (preview) ที่ ReadEval เปิดอ่านเมื่อ 26 ต.ค. ยังเป็นฉบับที่แก้ไปเมื่อกลางเดือน
- ให้สิทธิ์บอตเข้าเว็บของธุรกิจ: Meta หรือผู้ที่ทำงานแทนใช้บอต สเครปเปอร์ และ crawler เข้าถึง ทำดัชนี เก็บสำเนา วิเคราะห์ และดึงอัปเดตจากเว็บที่ผูกกับสินค้าหรือบริการของคุณ และสร้างบัญชีทดสอบได้
- คำว่า "ฝึก" หายไป แต่ข้อกังวลยังอยู่: ร่างแรกเขียนว่าใช้เนื้อหาไป "ฝึก" ผลิตภัณฑ์ของ Meta ฉบับปัจจุบันเหลือ "พัฒนา ปรับปรุง วิจัย" ผลิตภัณฑ์โฆษณาและธุรกิจ ทนายความบางคนมองว่า "พัฒนา" ครอบคลุมการฝึก AI ได้ ส่วน Meta ปฏิเสธ
- ร้านค้าไทยอยู่ในขอบเขต: ข้อกำหนดใช้กับทุกคนที่ใช้ Meta เพื่อธุรกิจ มีฉบับภาษาไทย และไม่มีข้อยกเว้นรายประเทศในส่วนนี้ ใช้ต่อหลัง 20 พ.ย. ถือว่ายอมรับ
ข้อกำหนดเขียนว่าอะไร
เรื่องนี้เกี่ยวกับข้อกำหนด 2 ชุดที่ Meta ปรับพร้อมกัน ได้แก่ ข้อกำหนดทางการค้า (Commercial Terms) ซึ่งใช้กับการใช้ผลิตภัณฑ์ของ Meta เพื่อธุรกิจทุกแบบ และข้อกำหนดโฆษณาแบบบริการตนเอง (Self-Serve Ad Terms) ซึ่งใช้กับคนที่ซื้อโฆษณาผ่านเครื่องมืออย่าง Ads Manager
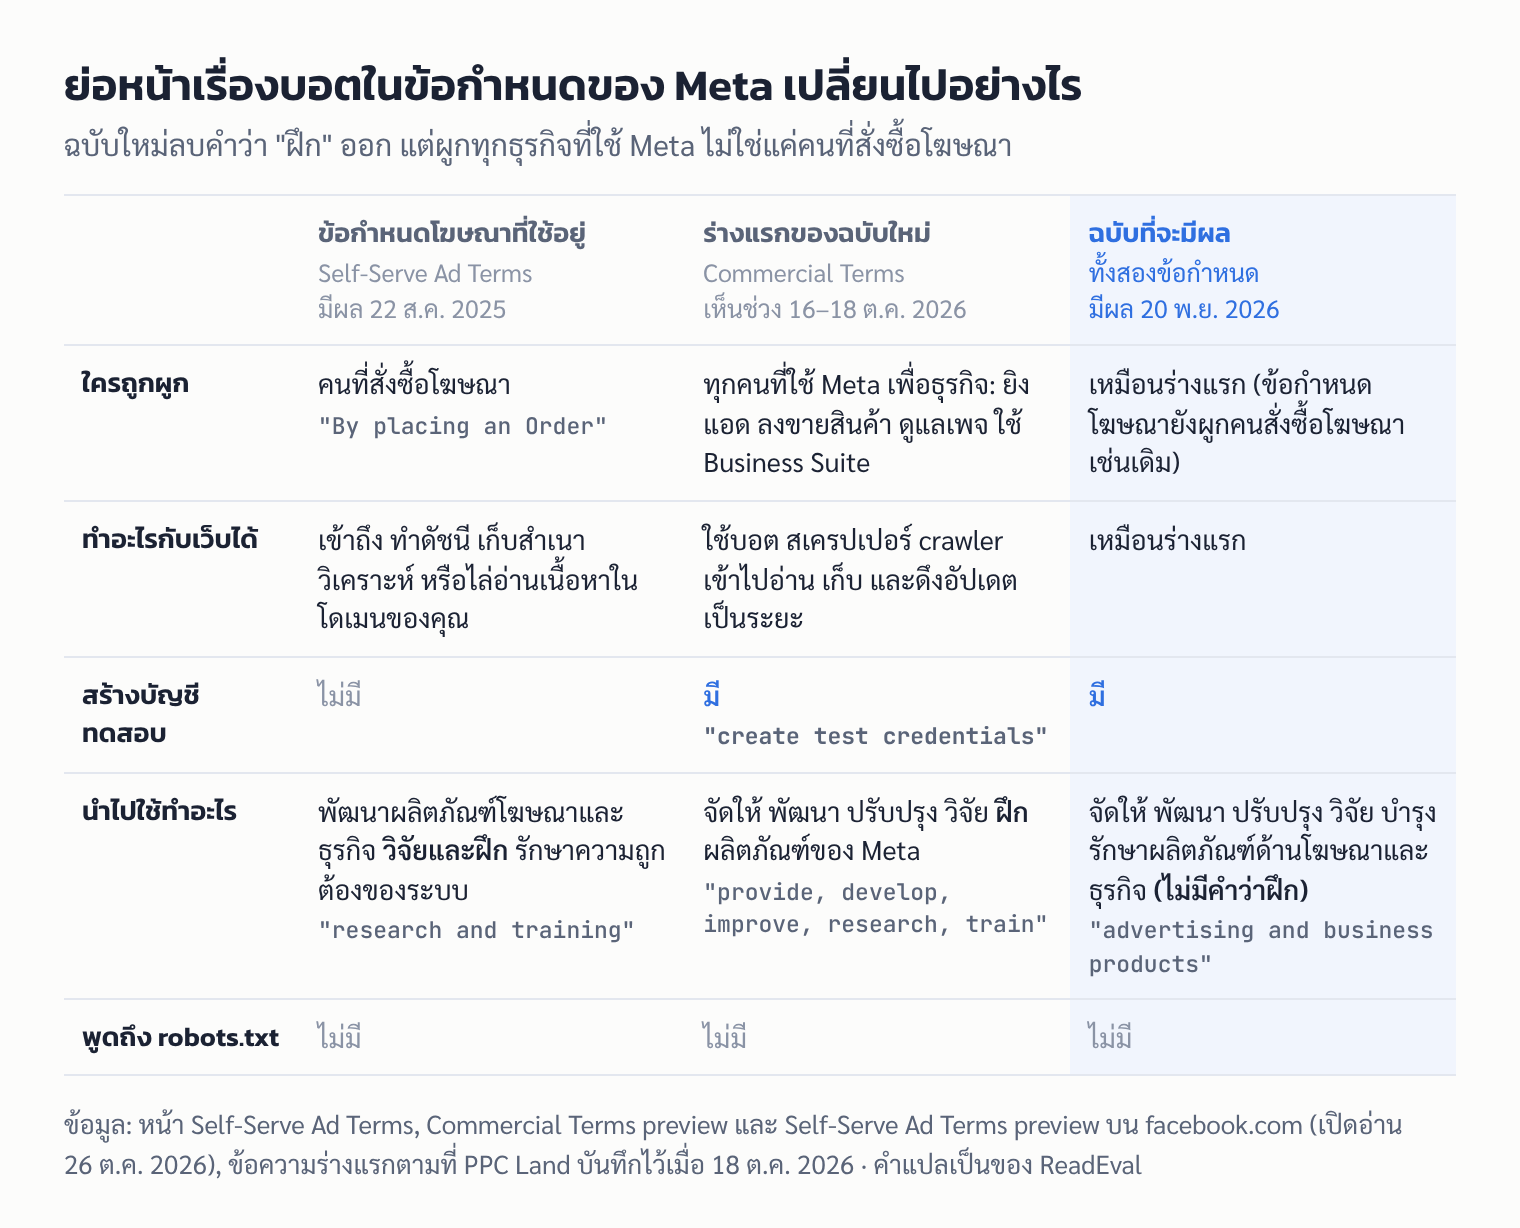
ข้อกำหนดทางการค้าฉบับที่ใช้อยู่ (มีผล 6 มี.ค. 2024) ไม่มีย่อหน้าเรื่องบอตเลย ส่วนข้อกำหนดโฆษณาฉบับที่ใช้อยู่ (มีผล 22 ส.ค. 2025) มีอยู่แล้ว โดยเขียนว่า "เมื่อสั่งซื้อโฆษณา คุณให้สิทธิ์เราเข้าถึง ทำดัชนี เก็บสำเนา วิเคราะห์ หรือไล่อ่านเนื้อหาที่ให้บริการผ่านโดเมน หน้าเว็บ หรือ URL ของคุณ" เพื่อพัฒนาและปรับปรุงผลิตภัณฑ์โฆษณาและธุรกิจ "การวิจัยและการฝึก (research and training)" และรักษาความถูกต้องของผลิตภัณฑ์ของ Meta Search Engine Journal เป็นสื่อที่ชี้จุดนี้ไว้ก่อน
ในฉบับใหม่ที่จะมีผล 20 พ.ย. 2026 ย่อหน้าเรื่องบอตย้ายไปอยู่ในหมวดที่ 1 ของข้อกำหนดทางการค้า (สิทธิ์ที่คุณให้ Meta) และข้อกำหนดโฆษณาฉบับใหม่ก็ใช้ถ้อยคำแบบเดียวกัน ใจความตามหน้าตัวอย่างภาษาอังกฤษ (แปลโดย ReadEval) คือ
คุณอนุญาตให้เรา (หรือหน่วยงานใดก็ตามที่ทำงานในนามของเรา) ใช้ซอฟต์แวร์อัตโนมัติ (เช่น เว็บสเครปเปอร์ บอต โรบอต สไปเดอร์ crawler และ user agent) และสร้างบัญชีทดสอบ เพื่อเข้าถึง ทำดัชนี เก็บสำเนา วิเคราะห์ รวบรวม ดึงข้อมูล หรือไล่อ่านโดเมน หน้าเว็บ หรือ URL (และเนื้อหาที่เข้าถึงได้ผ่านสิ่งเหล่านั้น) ที่เกี่ยวข้องกับสินค้าหรือบริการของคุณ หรือที่มีการเผยแพร่ผ่านการใช้ผลิตภัณฑ์ของเราโดยคุณหรือผู้ใช้ และดึงอัปเดตจากแหล่งเหล่านั้นเป็นระยะ เพื่อจัดให้มี พัฒนา ปรับปรุง วิจัย และบำรุงรักษาผลิตภัณฑ์ด้านโฆษณาและธุรกิจ และรักษาความถูกต้องและความปลอดภัยของผลิตภัณฑ์ของ Meta
ถ้อยคำต้นฉบับที่เป็นจุดสำคัญ ได้แก่ "web scrapers, bots, robots, spiders, crawlers, and user agents", "create test credentials", "made available through your or users' use of" และ "provide, develop, improve, research, and maintain advertising and business products" ReadEval ไม่พบคำว่า robots.txt ในหน้าตัวอย่างของทั้งสองข้อกำหนด
พูดง่าย ๆ คือ สำหรับคนยิงแอด การให้ Meta อ่านเว็บไม่ใช่เรื่องใหม่ แต่ฉบับใหม่ระบุเครื่องมือชัดขึ้น เพิ่มสิทธิ์สร้างบัญชีทดสอบ และใช้กับทุกธุรกิจที่ใช้ Meta แม้ไม่เคยซื้อโฆษณาเลย
คำว่า "ฝึก" หายไปแล้ว ทำไมยังมีคนกังวล
ร่างแรกที่ PPC Land บันทึกไว้มีประโยคที่สองต่อท้ายว่า Meta "อาจใช้เนื้อหาใด ๆ จากโดเมน หน้าเว็บ หรือ URL เหล่านั้นเพื่อจัดให้มี พัฒนา ปรับปรุง วิจัย ฝึก และรักษาความถูกต้องของ" ผลิตภัณฑ์ของ Meta หลังถูกวิจารณ์ Meta ตัดประโยคนี้ออก แล้วจำกัดจุดประสงค์ไว้ที่ "ผลิตภัณฑ์ด้านโฆษณาและธุรกิจ" แต่ข้อกังวลที่ยังเหลือมีอยู่ 3 ข้อ
- "พัฒนา" กว้างแค่ไหน: Matt Topic ทนายความด้านสื่อในสหรัฐฯ บอก Nieman Lab ว่า "ผมคิดว่าคำว่า 'develop' กว้างพอจะรวม 'train' อยู่แล้ว" ส่วน Meta ยืนยันว่าการแก้ครั้งนี้ทำให้ชัดว่าข้อกำหนดใช้กับผลิตภัณฑ์โฆษณาและธุรกิจเท่านั้น
- robots.txt ไม่อยู่ในสัญญา: Engadget รายงานว่า Meta จะอธิบายให้ชัดว่าเจ้าของเนื้อหาใช้ robots.txt บอกความต้องการกับบอตได้ แต่ข้อความในข้อกำหนดไม่ได้พูดถึงเรื่องนี้ และ robots.txt เป็นเพียงคำขอที่บอตเลือกทำตามเอง Engadget อ้างรายงานก่อนหน้าของ Reuters ว่าบอตของบริษัท AI หลายรายมักไม่ทำตาม
- บัญชีทดสอบ: ข้อกำหนดให้ Meta สร้างบัญชีทดสอบเพื่อเข้าเว็บได้ ซึ่งแปลว่าส่วนที่ต้องล็อกอินก่อนก็อาจอยู่ในขอบเขต ReadEval ไม่พบคำชี้แจงจาก Meta ว่าจะใช้บัญชีทดสอบกับหน้าแบบไหน
ฝั่ง Meta นั้น Andy Stone ผู้บริหารฝ่ายสื่อสารของ Meta เขียนบน X เมื่อ 16 ต.ค. ว่ารายงานข่าวช่วงแรกไม่เป็นความจริง และไม่มีการเปลี่ยนวิธีที่ Meta ใช้ web crawler ต่อมาเขายืนยันว่าการแก้ไขนี้ "ไม่เกี่ยวกับการดูดเนื้อหาจากเว็บข่าว" และไม่ได้ให้สิทธิ์ใหม่ที่จะข้ามการตั้งค่า robots.txt ของเจ้าของเว็บ
ใครต้องยอมรับข้อกำหนดนี้ ร้านค้าในไทยด้วยไหม
ข้อกำหนดทางการค้าฉบับใหม่นิยามการใช้เพื่อธุรกิจไว้กว้าง ได้แก่ การใช้โฆษณาหรือข้อความการตลาด การขายหรือลงรายการสินค้า การพัฒนาแอป การสร้างหรือใช้แคตตาล็อกสินค้า การดูแลเพจ การดูแลกลุ่มเพื่อธุรกิจ การใช้ผลิตภัณฑ์ธุรกิจอย่าง Ads Manager หรือ Meta Business Suite และการใช้บริการวัดผล ไม่ว่าคุณจะเป็นนิติบุคคลแบบใด ถ้าคุณดูแลบัญชีแทนลูกค้า เช่น เป็นเอเจนซี ข้อกำหนดยังระบุว่าคุณต้องดูแลให้ลูกค้าปฏิบัติตามด้วย
สำหรับไทย ReadEval ตรวจพบดังนี้
- หน้าข้อกำหนดทางการค้าและข้อกำหนดโฆษณาแบบบริการตนเองมีฉบับภาษาไทย และหน้าฉบับปัจจุบันขึ้นประกาศว่า "การปรับปรุงแก้ไขเหล่านี้จะมีผลในวันที่ 20 พฤศจิกายน" แล้ว
- หน้าตัวอย่างฉบับใหม่ภาษาไทยของทั้งสองข้อกำหนดใช้ถ้อยคำที่แก้แล้ว (ไม่มีคำว่า "ฝึก") แต่ยังระบุ "วันที่มีผลบังคับใช้" เป็น 30 ต.ค. ตามกำหนดเดิม เช่นเดียวกับหน้าตัวอย่างภาษาอังกฤษแบบอังกฤษ (UK) ขณะที่หน้าตัวอย่างภาษาอังกฤษแบบสหรัฐฯ เปลี่ยนเป็น 20 พ.ย. แล้ว ReadEval ถือตามประกาศบนหน้าข้อกำหนดปัจจุบันและคำแถลงของ Meta ว่าวันที่มีผลคือ 20 พ.ย. 2026
- ส่วนที่แยกตามภูมิภาคในข้อกำหนดทางการค้ามีเฉพาะเรื่องการระงับข้อพิพาท (สหรัฐฯ นอกสหรัฐฯ และยุโรป) ReadEval ไม่พบข้อยกเว้นรายประเทศในย่อหน้าเรื่องบอต
- ข้อร้องเรียนที่มีรายงานอยู่ในยุโรปและอังกฤษ ReadEval ไม่พบรายงานว่าหน่วยงานในไทยหรือสมาคมธุรกิจไทยแสดงท่าทีเรื่องนี้
- Meta ไม่ได้บอกว่าจะแจ้งผู้ใช้ทางช่องทางใด ข้อกำหนดเขียนเพียงว่าการใช้งานต่อหลังได้รับแจ้งถือว่ายอมรับ
ถ้าคุณขายของผ่านร้านค้าบน Facebook หรือ Instagram ด้วย Search Engine Journal ชี้ว่าข้อตกลงผู้ขาย (Seller Agreement) ฉบับ 26 พ.ค. 2026 ก็อนุญาตให้ Meta เข้าถึง URL ที่ผู้ขายให้ไว้แบบอัตโนมัติอยู่แล้ว
บอตของ Meta มีตัวไหนบ้าง และ robots.txt ช่วยได้แค่ไหน
หน้าคู่มือสำหรับเว็บมาสเตอร์ของ Meta ระบุบอตไว้ 5 ตัว แต่ละตัวบอกชื่อตัวเอง (user agent) เวลาเข้าเว็บ
| ชื่อบอต | ใช้ทำอะไร (ตามคู่มือของ Meta) | robots.txt |
|---|---|---|
FacebookExternalHit | อ่านเว็บหรือแอปที่มีคนแชร์บน Facebook, Instagram หรือ Messenger เพื่อแสดงตัวอย่างลิงก์ (ชื่อ คำอธิบาย รูปย่อ) | อาจไม่ทำตามเมื่อตรวจความปลอดภัยหรือความถูกต้อง |
Meta-ExternalAds | ปรับปรุงโฆษณาและผลิตภัณฑ์หรือบริการด้านธุรกิจอื่น ๆ | บล็อกได้ด้วย robots.txt |
Meta-ExternalAgent | ฝึกโมเดล AI พื้นฐาน หรือปรับปรุงผลิตภัณฑ์ด้วยการทำดัชนีเนื้อหาโดยตรง | บล็อกได้ด้วย robots.txt |
Meta-WebIndexer | ปรับคุณภาพผลการค้นหาของ Meta AI | บล็อกได้ด้วย robots.txt |
Meta-ExternalFetcher | ดึงลิงก์ทีละหน้าตามคำขอของผู้ใช้ | อาจไม่ทำตาม |
ถ้าคุณไม่อยากให้เนื้อหาบนเว็บถูกใช้ฝึก AI ของ Meta บอตที่ตรงที่สุดคือ Meta-ExternalAgent ตัวอย่างด้านล่างเขียนตามรูปแบบในคู่มือของ Meta โดยใส่ไว้ในไฟล์ robots.txt ที่รากของเว็บไซต์ (เช่น ร้านของคุณ.com/robots.txt)
User-agent: meta-externalagent
Disallow: /
ข้อควรรู้ก่อนแก้ไฟล์
- Meta ระบุว่าบอตอาจเก็บไฟล์ robots.txt ไว้ได้ถึง 24 ชั่วโมง การเปลี่ยนแปลงจึงอาจใช้เวลาถึง 1 วันกว่าจะมีผล
- อย่าบล็อก
facebookexternalhitถ้ายังอยากให้ลิงก์เว็บของคุณขึ้นรูปตัวอย่างสวย ๆ เวลาแชร์บน Facebook - คู่มือของ Meta ไม่ได้บอกว่าการบล็อก
meta-externaladsจะกระทบการแสดงหรือการตรวจโฆษณาหรือไม่ ถ้าคุณยิงแอดที่ลิงก์ไปเว็บของตัวเอง ReadEval แนะนำให้ระวังก่อนบล็อกตัวนี้ - ถ้าเว็บของคุณสร้างด้วยระบบสำเร็จรูป วิธีแก้ robots.txt ขึ้นกับแต่ละระบบ ให้ดูหน้าช่วยเหลือของผู้ให้บริการนั้น
- robots.txt เป็นแค่คำขอ ไม่ได้ล็อกหน้าเว็บ และไม่ได้ลบล้างสิ่งที่คุณยอมรับไว้ในข้อกำหนด
ทำอะไรได้บ้างก่อน 20 พ.ย.
- อ่านหน้าตัวอย่างข้อกำหนดฉบับใหม่ที่ facebook.com/legal/commercial_terms_preview และ facebook.com/legal/self_service_ads_terms_preview (เปลี่ยนเป็นภาษาไทยได้จากเมนูภาษาท้ายหน้า) โดยเฉพาะหมวดที่ 1 เรื่องสิทธิ์ที่คุณให้ Meta
- เปิด
ชื่อเว็บของคุณ/robots.txtในเบราว์เซอร์ ดูว่ามีบรรทัดUser-agentของบอต Meta อยู่หรือไม่ - ตัดสินใจว่าจะกันบอตตัวไหน โดยดูตารางด้านบน
- ถ้าคุณดูแลเพจหรือบัญชีโฆษณาให้ลูกค้า แจ้งลูกค้าเรื่องนี้ด้วย เพราะข้อกำหนดให้คุณรับผิดชอบดูแลให้ลูกค้าปฏิบัติตาม
- ถ้าไม่ยอมรับข้อกำหนด ทางเดียวที่ Meta ระบุคือหยุดใช้ผลิตภัณฑ์ของ Meta เพื่อธุรกิจ
ลำดับเหตุการณ์
| วันที่ (2026) | เกิดอะไรขึ้น |
|---|---|
| 15 ต.ค. | Nieman Lab รายงานว่าข้อกำหนดใหม่เปิดทางให้ Meta ดูดเนื้อหาจากเว็บข่าว ตามลำดับเหตุการณ์ของ Search Engine Journal |
| 16 ต.ค. | Andy Stone ปฏิเสธบน X · Danielle Coffey ซีอีโอของ News/Media Alliance เรียกข้อกำหนดนี้ว่า "อุกอาจและน่าจะผิดกฎหมาย" · MLex รายงานความกังวลของสภาผู้พิมพ์ยุโรป (European Publishers Council) |
| 17 ต.ค. | The Verge รายงานว่า Meta ลบประโยคเรื่อง "ฝึก" ออกจากหน้าข้อกำหนด |
| 18 ต.ค. | PPC Land พบว่าหน้าตัวอย่างฉบับภาษาอังกฤษแบบ UK ยังมีประโยคเดิม |
| ภายใน 20 ต.ค. | สมาคมผู้พิมพ์ของเยอรมนี (BDZV และ MVFP) ร้องเรียนต่อคณะกรรมาธิการยุโรป · News Media Association ของอังกฤษเรียกว่า "การฮุบพื้นที่อย่างหน้าด้าน" · กลุ่ม Movement for an Open Web เตรียมร้องต่อ CMA ของอังกฤษและคณะกรรมาธิการยุโรป |
| 23 ต.ค. | Reuters รายงานว่า Meta เลื่อนวันมีผลเป็น 20 พ.ย. |
| 26 ต.ค. | ReadEval เปิดอ่านหน้าตัวอย่างภาษาอังกฤษ (สหรัฐฯ และ UK) และภาษาไทย ไม่พบคำว่า "train" หรือ "ฝึก" ในย่อหน้าเรื่องบอตแล้ว |
| 20 พ.ย. | วันมีผลใหม่ของทั้งสองข้อกำหนด |
แหล่งข่าวเห็นไม่ตรงกันตรงไหน
- วันมีผล: หน้าตัวอย่างภาษาไทยและภาษาอังกฤษแบบ UK ยังเขียน 30 ต.ค. ขณะที่ประกาศบนหน้าข้อกำหนดปัจจุบันทั้งสองภาษา หน้าตัวอย่างแบบสหรัฐฯ และคำแถลงของ Meta ต่อ Reuters ระบุ 20 พ.ย. ReadEval ถือ 20 พ.ย. ตามแหล่งที่เป็นทางการส่วนใหญ่ และมองว่าหน้าที่ยังเขียน 30 ต.ค. น่าจะยังไม่ได้อัปเดต
- "ลบเรื่องฝึก AI": Engadget เขียนว่า Meta ลบ "การอ้างถึงการฝึก AI" แต่ร่างแรกใช้คำว่า "train" เฉย ๆ ไม่ได้เขียนคำว่า AI และการแก้ไม่ได้มีพร้อมกันทุกภาษา PPC Land และ ContentGrip รายงานว่ายังเห็นคำนี้ในบางฉบับช่วง 18–19 ต.ค. ณ วันที่ 26 ต.ค. ReadEval ไม่พบคำนี้ในฉบับที่ตรวจแล้ว
- ใครร้องเรียน: Reuters บอกว่าทั้งสำนักข่าวและผู้ลงโฆษณาดิจิทัลยื่นเรื่องต่อหน่วยงานในสหภาพยุโรปและอังกฤษ ผู้ร้องเรียนที่ ReadEval ระบุชื่อได้คือสมาคมผู้พิมพ์ของเยอรมนี (ต่อคณะกรรมาธิการยุโรป) และกลุ่มรณรงค์ Movement for an Open Web ซึ่ง Resultsense รายงานเมื่อ 20 ต.ค. ว่ากำลังเตรียมยื่นต่อ CMA และคณะกรรมาธิการยุโรป ก่อนจะระบุในบทความถัดมาว่ายื่นแล้วพร้อมขอมาตรการชั่วคราว ReadEval ไม่พบชื่อผู้ลงโฆษณารายใดที่ร้องเรียน
- อะไรเปลี่ยนจริง: Meta บอกว่าไม่ได้เปลี่ยนวิธีใช้บอต ขณะที่ฝ่ายวิจารณ์ชี้ว่าสิทธิ์ในสัญญากว้างขึ้น ทั้งสองอย่างจริงได้พร้อมกัน เพราะฝ่ายหนึ่งพูดถึงการทำงานของบอตวันนี้ อีกฝ่ายพูดถึงสิ่งที่สัญญาเปิดทางให้ทำในอนาคต
- ใช้เนื้อหาฝึก AI หรือไม่: เป็นการตีความของทนายความและฝ่ายวิจารณ์ ซึ่ง Meta ปฏิเสธ ยังไม่มีหน่วยงานหรือศาลใดชี้ขาด
บทวิเคราะห์จาก ReadEval
Ade · โต๊ะแอปและแพลตฟอร์ม
Meta ลบคำว่า "ฝึก" ออกแล้ว แต่สิ่งที่ธุรกิจจะยอมรับในวันที่ 20 พ.ย. คือสิทธิ์ให้บอตเข้าเว็บที่ระบุชัดกว่าเดิม ใช้กับคนมากกว่าเดิม และไม่มีปุ่มปฏิเสธ
เรื่องนี้ดังเพราะสำนักข่าวกลัวว่าแค่มีเพจบน Facebook ก็อาจเท่ากับยกเนื้อหาข่าวให้ Meta ใช้ฟรี แต่สำหรับร้านค้าทั่วไป ผลกระทบอาจน้อยกว่าที่ฟัง เพราะหน้าสินค้าและราคาในเว็บก็เปิดให้ทุกคนเห็นอยู่แล้ว และคนยิงแอดก็ยอมให้ Meta อ่านเว็บอยู่แล้วอย่างน้อยตั้งแต่ข้อกำหนดโฆษณาฉบับ ส.ค. 2025 สิ่งที่ควรระวังจริงคือส่วนที่ต้องล็อกอินก่อน เนื้อหาที่คุณขายหรือเขียนเอง และการที่ข้อจำกัดเดียวที่ Meta พูดถึงอย่าง robots.txt ไม่ได้อยู่ในตัวสัญญา
การเลื่อน 3 สัปดาห์ไม่ได้แก้คำใดในข้อกำหนด แต่อย่างน้อยก็ให้เวลาธุรกิจได้อ่านก่อนกดยอมรับ ReadEval มองว่าคุณไม่จำเป็นต้องเลิกใช้ Meta แต่ควรใช้เวลาเปิดดู robots.txt ของเว็บไซต์ร้านสักครั้ง เพราะไฟล์นี้เป็นสิ่งเดียวในเรื่องนี้ที่คุณควบคุมได้เอง
แหล่งที่มา
- Meta: Commercial Terms ฉบับใหม่ (preview, มีผล 20 พ.ย. 2026)
- Meta: Commercial Terms ฉบับปัจจุบัน (มีผล 6 มี.ค. 2024) พร้อมประกาศวันมีผลฉบับใหม่
- Meta: Self-Serve Ad Terms ฉบับปัจจุบัน (มีผล 22 ส.ค. 2025)
- Meta: Self-Serve Ad Terms ฉบับใหม่ (preview)
- Meta: ข้อกำหนดทางการค้าฉบับใหม่ ภาษาไทย (preview)
- Meta: ข้อกำหนดของโฆษณาแบบบริการตนเอง ภาษาไทย
- Meta: ข้อกำหนดของโฆษณาแบบบริการตนเองฉบับใหม่ ภาษาไทย (preview)
- Meta: Commercial Terms preview ฉบับภาษาอังกฤษ (UK)
- Meta for Developers: Meta Web Crawlers
- Reuters (ผ่าน The Business Standard): Meta to delay new commercial terms criticised by publishers, advertisers
- Engadget: Meta is delaying its controversial business terms over scraping concerns
- PPC Land: Meta's AI training clause still in Oct 30 terms after report of removal
- Search Engine Journal: Meta's new terms expand crawling rights beyond advertisers
- The Media Copilot: Meta's AI scraping terms and publishers (อ้างคำให้สัมภาษณ์ Matt Topic ต่อ Nieman Lab)
- ProPakistani: Meta's new business terms still allow website scraping
- ContentGrip: Meta's AI-training clause remains in some terms despite rollback
- Competition Policy International (PYMNTS): Meta faces EU complaint from German publishers over content access
- Resultsense: Meta terms spark publisher AI scraping row
- Wikimedia Commons: Meta Platforms logo