New York Times และหนังสือพิมพ์อีก 3 ฉบับฟ้อง Brave กล่าวหาว่าเอาข่าวไปขายให้บริษัท AI
NYT และหนังสือพิมพ์อีก 3 ฉบับฟ้อง Brave กล่าวหาว่าเก็บข่าวเข้าดัชนีกว่า 3 หมื่นล้านหน้า แล้วขายต่อให้บริษัท AI อย่าง Anthropic และ Perplexity

สารบัญ (12 หัวข้อ)
- สรุปประเด็นสำคัญ
- ใครฟ้องใคร และเรียกร้องอะไร
- แชตบอตเอาคำตอบ "ค้นเว็บ" มาจากไหน
- คำฟ้องยกตัวอย่างอะไรบ้าง
- "บอตไม่บอกชื่อ" กับคำอธิบายของ Brave
- Paywall blocker คืออะไร เปิดอยู่ในเครื่องคุณไหม
- เรื่องโฆษณา: บล็อกของเขา ขายของตัวเอง
- Brave ว่าอย่างไร
- ตัวเลขที่แหล่งข้อมูลเขียนไม่ตรงกัน
- คนไทยเกี่ยวไหม และควรทำอะไร
- คดีนี้ต่อจากคดีไหน
- บทวิเคราะห์จาก ReadEval
เวลาคุณถามแชตบอตว่า "ข่าวล่าสุดเรื่องนี้ว่าอย่างไร" แล้วได้คำตอบพร้อมลิงก์ข่าว หลายครั้งแชตบอตไม่ได้เปิดเว็บเอง แต่ไปถามดัชนีค้นหาของบริษัทอื่นที่เก็บสำเนาหน้าเว็บไว้ก่อนแล้ว ผู้ขายดัชนีแบบนี้รายหนึ่งคือ Brave ผู้ทำเบราว์เซอร์รูปสิงโตสีส้ม ซึ่งตอนนี้กำลังถูกหนังสือพิมพ์ใหญ่ของสหรัฐฯ ฟ้อง
The New York Times ยื่นฟ้อง Brave ต่อศาลรัฐบาลกลางในนิวยอร์ก ส่วนเจ้าของ Daily News, Chicago Tribune และ Orlando Sentinel ยื่นอีกคดีในวันเดียวกัน คำฟ้องกล่าวหาว่า Brave ใช้บอตที่ไม่บอกชื่อตัวเองเก็บหน้าเว็บกว่า 3 หมื่นล้านหน้าเข้าดัชนี แล้วให้ AI ของตัวเองใช้ตอบผู้ใช้ และขายต่อให้บริษัท AI ผ่านช่องทางให้โปรแกรมเรียกใช้ (API) คำฟ้องเปรียบ Brave เป็นทั้ง "โจรย่องเบา" ที่เอาเนื้อหาไป และ "คนรับซื้อของโจร" ที่ขายต่อ
ลองนึกถึงร้านถ่ายเอกสารที่ถ่ายหนังสือพิมพ์ทุกฉบับเก็บไว้ แล้วให้ร้านอื่นเช่าสำเนาไปตอบคำถามลูกค้า นี่คือภาพที่ฝั่งหนังสือพิมพ์วาด แต่ภาพนี้ไม่ตรงทั้งหมด เพราะเครื่องมือค้นหาทุกเจ้ารวมถึง Google ก็ต้องเก็บสำเนาหน้าเว็บก่อนจึงค้นได้ คำถามที่ศาลต้องตอบคือ การเอาสำเนาไปตอบแทนการพาคนไปอ่านต้นฉบับ ยังเป็นการใช้โดยชอบธรรม (fair use) หรือไม่
คำฟ้องระบุว่าลูกค้าของ Brave มีทั้ง Anthropic ผู้ทำ Claude, Perplexity, Mistral, xAI และ Cohere (ซึ่งไม่ได้เป็นจำเลย) หน้าเว็บของ Brave เองระบุชื่อ Cohere, Mistral, Perplexity และ You.com และบล็อกของ Brave เคยเขียนว่า Anthropic ใช้บริการนี้ฝึก Claude รุ่นก่อน ตัวอย่างที่หนักที่สุดในคำฟ้องของ NYT คือ API ของ Brave คืนข้อความออกมา 1,291 จาก 1,295 คำ หรือแทบทั้งบทความ คำฟ้องยังโจมตีตัวเลือก Paywall blocker ในเบราว์เซอร์ที่ช่วยข้ามระบบบังคับสมัครสมาชิกของเว็บข่าว
ทั้งหมดยังเป็นข้อกล่าวหา Brave ยังไม่ตอบสื่อ แต่ในคดีกับ News Corp บริษัทยืนยันว่าการเก็บหน้าเว็บทำดัชนีเป็นการใช้โดยชอบธรรม ผู้ใช้ทั่วไปยังไม่ต้องเปลี่ยนอะไรเพราะศาลยังไม่ได้สั่งอะไร แต่ครั้งหน้าที่แชตบอตสรุปข่าวให้ ลองกดลิงก์ที่มาดู ด้านล่างมีแผนภาพเส้นทางของข้อมูล ตัวอย่างจากคำฟ้อง และคำอธิบายของ Brave เอง
สรุปประเด็นสำคัญ
- 2 คดี ยื่นวันเดียวกัน (2 พ.ย. 2026): The New York Times (คดี 1:26-cv-09549) และ Daily News, Chicago Tribune, Orlando Sentinel (คดี 1:26-cv-09554) ฟ้อง Brave Software ต่อศาลรัฐบาลกลางเขตใต้ของนิวยอร์ก (SDNY) ข้อหาละเมิดลิขสิทธิ์ทางตรง ทางอ้อม และแบบต้องรับผิดแทน หลบเลี่ยงมาตรการป้องกันตามกฎหมาย DMCA และได้ประโยชน์โดยมิชอบตามกฎหมายนิวยอร์ก
- เป้าหลักคือดัชนีของ Brave: คำฟ้องกล่าวหาว่าดัชนีกว่า 3 หมื่นล้านหน้าถูกนำไปใช้ใน 3 ทาง คือ AI ค้นหาของ Brave เอง (Ask Brave), API ที่ขายให้บริษัท AI และเบราว์เซอร์ที่ข้ามเพย์วอลล์และบล็อกโฆษณาของสำนักข่าว
- บริษัท AI ถูกเอ่ยชื่อแต่ไม่ได้ถูกฟ้อง: Anthropic, Perplexity, Mistral, xAI และ Cohere ถูกระบุว่าเป็นลูกค้า
- Brave ยังไม่ให้ความเห็น: ณ วันที่ 3 พ.ย. 2026 ReadEval ไม่พบแถลงการณ์ในบล็อกของ Brave และสื่อทุกเจ้ารายงานว่า Brave ไม่ได้ตอบคำขอความเห็น
ใครฟ้องใคร และเรียกร้องอะไร
| คดีของ The New York Times | คดีของหนังสือพิมพ์ 3 ฉบับ | |
|---|---|---|
| เลขคดี | 1:26-cv-09549 | 1:26-cv-09554 |
| โจทก์ | The New York Times Company | Daily News, LP / Chicago Tribune Company, LLC / Orlando Sentinel Communications Company, LLC |
| ความยาวคำฟ้อง | 72 หน้า | 69 หน้า |
| งานที่อ้างว่าจดลิขสิทธิ์ไว้ | กว่า 10 ล้านชิ้น | Daily News กว่า 5 แสนบทความ, Chicago Tribune กว่า 1.2 ล้านบทความ, Orlando Sentinel กว่า 4 แสนบทความ |
| ข้อหา | 5 ข้อเหมือนกัน: ละเมิดลิขสิทธิ์ทางตรง ทางอ้อม (contributory) และแบบต้องรับผิดแทน (vicarious), หลบเลี่ยงมาตรการป้องกันทางเทคโนโลยีตาม DMCA, ได้ประโยชน์โดยมิชอบ (unjust enrichment) | เหมือนกัน |
| สิ่งที่ขอ | ค่าเสียหายตามกฎหมายและตามจริง คืนกำไร คำสั่งห้ามถาวร และขอพิจารณาโดยคณะลูกขุน | เหมือนกัน |
ทั้งสองคดีลงนามโดย Steven Lieberman ทนายจากสำนักงาน Rothwell, Figg, Ernst & Manbeck และใช้ถ้อยคำเปิดคดีแทบเหมือนกันทุกคำ รวมถึงประโยคที่ว่า Brave "ทำตัวเป็นทั้งโจรย่องเบาที่ยักยอกเนื้อหาของสำนักพิมพ์ และเป็น 'คนรับซื้อของโจร' ด้าน AI ที่ขายของที่ขโมยมาให้บุคคลที่สาม" (แปลโดย ReadEval) Lieberman บอกสื่อว่า "Brave ต้องรับผิดชอบที่ฟอกข่าวที่ถูกละเมิดลิขสิทธิ์ให้อุตสาหกรรม AI"
แชตบอตเอาคำตอบ "ค้นเว็บ" มาจากไหน
แชตบอตที่ค้นเว็บได้มักทำงานแบบที่เรียกว่า RAG คือเมื่อคุณถาม ระบบจะไปดึงหน้าเว็บที่เกี่ยวข้องมาก่อน แล้วส่งข้อความเหล่านั้นให้โมเดล AI อ่านประกอบคำถามเพื่อเขียนคำตอบ คำฟ้องอธิบายขั้นตอนนี้ไว้ 4 ข้อ ได้แก่ รับคำถาม ไปดึงเนื้อหาที่เกี่ยวข้อง รวมเนื้อหากับคำถาม แล้วส่งให้โมเดลเขียนคำตอบ
ส่วนที่ "ไปดึงเนื้อหา" นั้น บริษัท AI ไม่จำเป็นต้องสร้างเครื่องมือค้นหาเอง แต่ซื้อบริการค้นหาผ่าน API จากบริษัทที่มีดัชนีอยู่แล้ว คำฟ้องชี้ว่า Brave ต่างจากเครื่องมือค้นหาทางเลือกหลายเจ้าที่พึ่งผลค้นหาของ Google หรือ Bing เพราะ Brave สร้างดัชนีของตัวเอง และขายให้คนอื่นเรียกใช้ได้
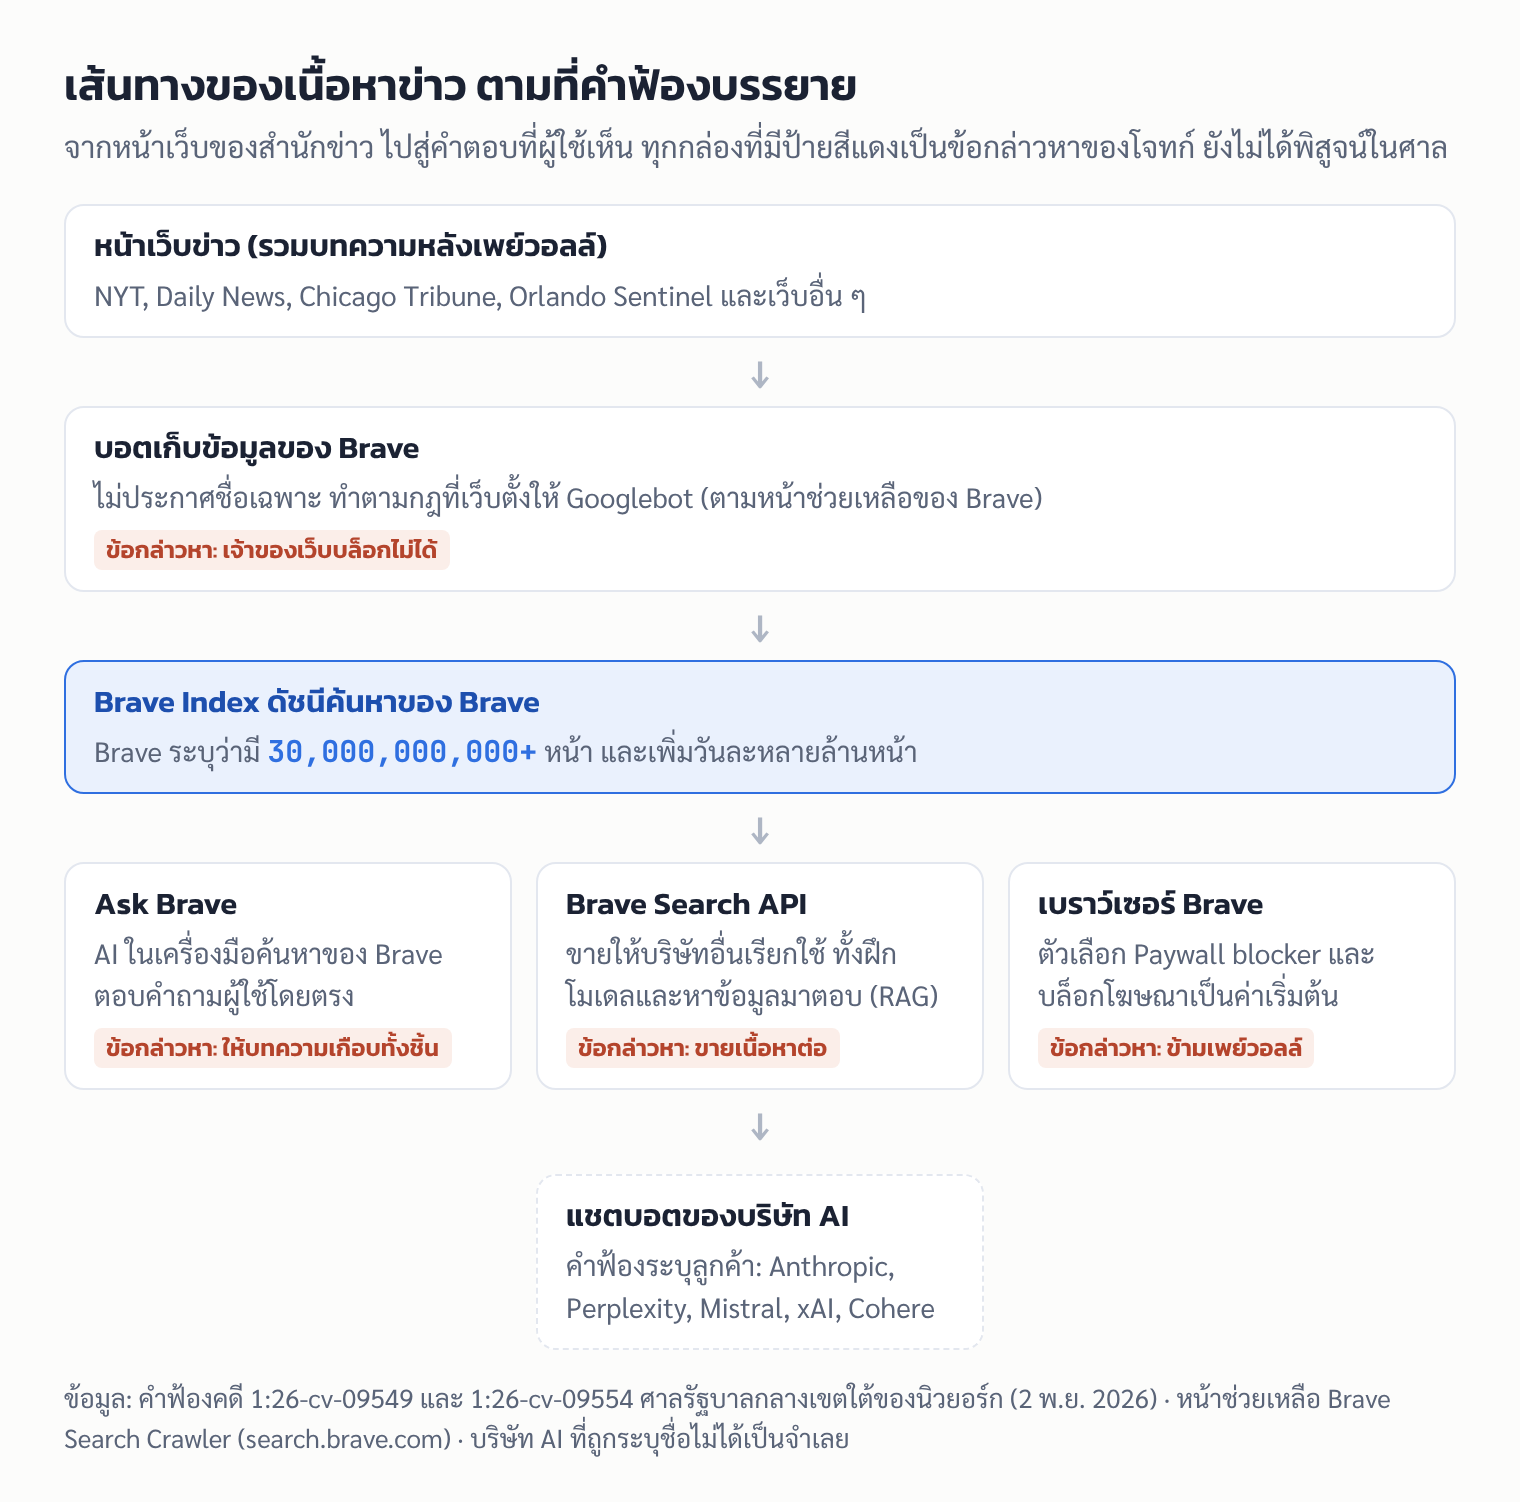
คำฟ้องยกคำโฆษณาของ Brave เองมาเป็นหลักฐาน เช่น หน้าคู่มือ API ปี 2023 ที่เขียนว่า "การใช้งานที่พบบ่อยที่สุดในวันนี้คือการฝึกและ grounding โมเดลภาษาขนาดใหญ่ (LLM) ที่ใหญ่ที่สุดหลายตัวของเว็บ" และบริการย่อยของ API ที่คำฟ้องหยิบมาเป็นพิเศษ ได้แก่
- LLM Context: Brave อธิบายว่าคืน "ชิ้นส่วนเนื้อหาที่ดึงจากหน้าเว็บ ... ในรูปแบบและความยาวที่ตอบโจทย์ LLM โดยไม่ต้องไปดูดข้อมูลเพิ่ม"
- News Search: ดัชนีเฉพาะบทความข่าว ซึ่งคำฟ้องบอกว่ารวม The Times ด้วย และให้ข้อความตัดตอนเพิ่มได้ถึง 5 ช่วงต่อผลลัพธ์
- Answers: คำตอบที่ AI เขียนจากดัชนีของ Brave ซึ่งคำฟ้องบอกว่าเป็นบริการเดียวกับที่ใช้ใน Ask Brave
หน้า Search API ของ Brave ตอนนี้คิดค่าค้นหา 5 ดอลลาร์ต่อ 1,000 ครั้ง และให้เครดิตฟรี 5 ดอลลาร์ทุกเดือน
แชตบอตตัวไหนใช้ Brave บ้าง
ข้อนี้ ReadEval อ้างเฉพาะสิ่งที่ Brave เขียนเองและสิ่งที่คำฟ้องระบุ
| แหล่ง | บอกว่าใครใช้ |
|---|---|
| หน้า About ของ Brave | "ใช้โดยชื่อใหญ่ที่สุดหลายรายในวงการ AI รวมถึง Cohere, Mistral, Perplexity และ You.com" |
| หน้า Search API ของ Brave | "ได้รับความไว้วางใจจากห้องแล็บ AI ชั้นนำของโลก (รวมถึงบางรายที่เราเอ่ยชื่อไม่ได้)" โลโก้ลูกค้าที่แสดงรวม Cohere, Mistral AI, You.com, AWS และ Snowflake |
| บล็อกของ Brave (2 พ.ย. 2023) | "Anthropic ใช้ Search API ของ Brave ฝึกโมเดลล่าสุดของตน Claude 2 ด้วยข้อมูลคุณภาพสูง เพื่อช่วยปรับคำตอบของ Claude สำหรับคำถามแบบ RAG" |
| คำฟ้องทั้งสองฉบับ | ลูกค้าคือ Anthropic, Perplexity, Mistral, xAI และ Cohere และอ้างงานวิจัยของ Meta ว่าโมเดล Llama 3 ถูกฝึกให้เรียก Brave API เพื่อตอบเรื่องที่เกิดหลังข้อมูลฝึก |
ข้อสังเกต: ชื่อ xAI ปรากฏในคำฟ้อง แต่ ReadEval ไม่พบในหน้าลูกค้าของ Brave ที่คำฟ้องอ้างถึง และคำฟ้องไม่ได้แยกว่าแชตบอตตัวไหนใช้ Brave กับฟีเจอร์ค้นเว็บในปัจจุบัน ใช้ฝึกโมเดล หรือทั้งสองอย่าง ReadEval จึงยืนยันเป็นรายผลิตภัณฑ์ไม่ได้
คำฟ้องยกตัวอย่างอะไรบ้าง
ฝั่งโจทก์ทดลองถาม Ask Brave และเรียก Brave API ด้วยตัวเอง แล้ววางคำตอบเทียบกับบทความต้นฉบับแบบไฮไลต์ข้อความที่ตรงกัน ตัวอย่างหลัก ๆ มีดังนี้
| ช่องทาง | สิ่งที่ถาม | ผลตามคำฟ้อง |
|---|---|---|
| Ask Brave | วางลิงก์บทความ NYT ที่อยู่หลังเพย์วอลล์ แล้วตอบ "yes please" เมื่อถูกถามว่าจะให้ดึงบทความเต็มไหม | ข้อความตรงตัวกว่า 400 คำ |
| Ask Brave | ขอบทความเด่นที่สุดของหนังสือพิมพ์ที่น่าเชื่อถือที่สุดวันนี้ แล้วขอฉบับเต็ม | ข้อความจาก NYT เกือบ 700 คำ |
| Ask Brave | ขอข่าวที่ประธานาธิบดี Trump ทำเมื่อวาน แล้วเลือกบทความของ NYT | ราว 87% ของบทความ ทั้งที่ AI เองเขียนว่าบทความนี้ติดเพย์วอลล์ |
| Brave API (LLM Context) | ค้นด้วยชื่อบทความ NYT "Mixed Human Feelings After a Day at a Park Full of Robots" | 1,291 จาก 1,295 คำ ตรงตัว |
| Ask Brave | ขอรายการข่าววันนี้ของ Daily News | รายชื่อบทความ 35 ชิ้น แล้วเสนอว่าจะ "ดึงฉบับสมบูรณ์มาให้" ดึงข่าวรถม้าใน Central Park ออกมาเกือบ 600 คำ |
| Ask Brave | ขอบทความ Chicago Tribune เรื่องศูนย์ข้อมูลใกล้สนามบิน O'Hare | กว่า 1,200 คำ |
คำฟ้องของ NYT ยังยกตัวอย่างที่ Ask Brave แนะนำเมนอราห์ (เชิงเทียนของชาวยิว) ตามรีวิวของ Wirecutter โดยลิงก์ไปร้านขายของแทนที่จะลิงก์ไปบทความ ซึ่ง NYT บอกว่าทำให้เสียรายได้ค่าแนะนำสินค้า
ตัวอย่างเหล่านี้เป็นผลที่โจทก์เลือกมาแสดงเอง ยังไม่ได้ผ่านการพิสูจน์ในศาล และฝ่าย Brave ยังไม่ได้โต้แย้ง
"บอตไม่บอกชื่อ" กับคำอธิบายของ Brave
ปกติบอตเก็บข้อมูลเว็บ (crawler) จะบอกชื่อตัวเองทุกครั้งที่ขอหน้าเว็บ เจ้าของเว็บจึงเขียนในไฟล์ robots.txt ได้ว่าอนุญาตหรือห้ามบอตตัวไหน คำฟ้องกล่าวหาว่า Brave "ไม่เคยเปิดเผยชื่อบอต" จึงเก็บหน้าเว็บ "โดยไม่ระบุตัวตน หรือให้กลไกใด ๆ แก่เจ้าของเว็บในการบล็อก"
หน้าช่วยเหลือของ Brave เรื่อง crawler ยอมรับส่วนแรกแต่ให้เหตุผลต่างออกไป Brave เขียนว่าบอตของตน "ไม่ได้ประกาศชื่อเฉพาะ" (user agent) เพื่อไม่ให้ถูกกีดกันจากเว็บที่อนุญาตเฉพาะ Google และบอกว่า "ถ้าโดเมนหรือหน้าเว็บไหน Googlebot เก็บไม่ได้ บอตของ Brave Search ก็จะไม่เก็บเช่นกัน" หน้าเดียวกันยังเขียนว่า robots.txt "ไม่ได้ใช้ป้องกันไม่ให้หน้าเว็บถูกจัดเข้าดัชนี" ถ้าจะเอาหน้าออกจากดัชนีให้ใช้คำสั่ง noindex แทน
สรุปคือเจ้าของเว็บบล็อก Brave ได้ แต่ต้องบล็อก Google ไปด้วย ซึ่งสำหรับสำนักข่าวแทบเท่ากับหายไปจากผลค้นหาที่ใหญ่ที่สุด ฝั่งโจทก์มองว่านี่คือการไม่มีทางเลือกจริง ส่วน Brave มองว่าเป็นการทำตามกติกาเดียวกับ Google ข้อนี้ศาลจะต้องชั่งน้ำหนัก
Paywall blocker คืออะไร เปิดอยู่ในเครื่องคุณไหม
คำฟ้องกล่าวหาว่าเบราว์เซอร์ Brave มีตัวเลือกชื่อ "Paywall blocker" ที่ Brave อธิบายว่าช่วย "Bypass Paywalls" (ข้ามเพย์วอลล์) และเป็นฐานของข้อหาตาม DMCA ซึ่งห้ามหลบเลี่ยงมาตรการทางเทคโนโลยีที่ควบคุมการเข้าถึงงานมีลิขสิทธิ์ คำฟ้องยกโพสต์ใน Reddit ของผู้ใช้ที่เขียนว่าเปิดตัวเลือกนี้แล้ว "อ่าน NYT ได้โดยไม่สะดุด และไม่ต้องสมัครบัญชี" และอ้างว่าพนักงานของ Brave เคยโพสต์แนะนำวิธีใช้ตัวกรองเพื่อเอา "paywall nag" ของ NYT ออก
ReadEval เปิดดูรายการตัวกรองทางการของ Brave (ไฟล์ list_catalog.json ใน repo brave/adblock-resources บน GitHub) แล้วพบรายการชื่อ "Paywall blocker" คำอธิบาย "Bypass Paywalls Clean Filters" จริง โดยดึงกฎมาจากโครงการ Bypass Paywalls Clean ของบุคคลภายนอก และรายการนี้ไม่ได้ถูกตั้งให้เปิดเป็นค่าเริ่มต้น (ต่างจากรายการบล็อกโฆษณาหลักที่เปิดไว้) คำฟ้องใช้คำว่าเป็น "default setting" ซึ่งอ่านแล้วอาจเข้าใจว่าเปิดไว้ตั้งแต่แรก แต่ประโยคเดียวกันก็เขียนว่าตัวเลือกนี้ทำงาน "เมื่อเปิดใช้งาน" ซึ่งตรงกับรายการของ Brave ว่าเป็นตัวเลือกในตัวเบราว์เซอร์ที่ผู้ใช้ต้องเลือกเปิดเองในรายการตัวกรอง (filter lists) ถ้าคุณไม่เคยเปิด ตัวเลือกนี้ก็ไม่ได้ทำงานในเครื่องคุณ ReadEval ไม่ได้ทดลองกดในเบราว์เซอร์จริง
เรื่องโฆษณา: บล็อกของเขา ขายของตัวเอง
คำฟ้องชี้ว่าเบราว์เซอร์ Brave บล็อกโฆษณาเป็นค่าเริ่มต้น รวมถึงแบนเนอร์ชวนสมัครสมาชิก NYT "1 ดอลลาร์ต่อสัปดาห์ใน 6 เดือนแรก" ขณะที่ Brave ขายโฆษณาของตัวเองผ่าน Brave Ads และแบ่งโทเคนให้ผู้ใช้ผ่าน Brave Rewards ข้อนี้ไม่ใช่ข้อหาแยก แต่โจทก์ใช้อธิบายว่า Brave ได้ประโยชน์จากเนื้อหาข่าวโดยสำนักข่าวไม่ได้อะไร คำฟ้องอ้างรายงานของบุคคลภายนอกว่า Brave มีรายได้ปี 2025 เกิน 100 ล้านดอลลาร์ เพิ่มจากราว 52 ล้านดอลลาร์ในปี 2024
Brave ว่าอย่างไร
- ต่อคดีนี้: TechCrunch และ TheWrap รายงานว่า Brave ไม่ได้ตอบคำขอความเห็นทันที ReadEval ตรวจบล็อกของ Brave เมื่อ 3 พ.ย. 2026 ยังไม่พบโพสต์เรื่องคดี
- ต่อจดหมายเตือน: NYT อ้างว่าส่งจดหมายให้หยุดการกระทำ (cease and desist) ถึง Brendan Eich ซีอีโอ Brave เมื่อ 11 ส.ค. 2025 และ 13 เม.ย. 2026 แต่ Brave ไม่ตอบทั้งสองฉบับ ซึ่ง NYT ใช้เป็นหลักฐานว่าละเมิดโดยเจตนา
- จุดยืนเดิม: เมื่อเดือนมีนาคม 2025 Brave เป็นฝ่ายฟ้อง News Corp (เจ้าของ The Wall Street Journal และ New York Post) ที่ศาลแคลิฟอร์เนียเหนือก่อน เพื่อขอให้ศาลประกาศว่าตนไม่ได้ละเมิดลิขสิทธิ์ คำฟ้องของ Brave ฉบับนั้นเขียนว่า "แนวคำพิพากษาและแนวปฏิบัติหลายทศวรรษยืนยันว่าการทำดัชนีเนื้อหาเว็บเพื่อดูแลเครื่องมือค้นหาไม่ใช่การละเมิดลิขสิทธิ์ แต่เป็นการใช้โดยชอบธรรม" และกล่าวหาว่า News Corp ที่เป็นพันธมิตรกับ Google ต้องการกีดกัน Brave ออกจากตลาด News Corp ฟ้องกลับในเดือนกรกฎาคม 2026 ตามที่ The Next Web รายงาน
ข้อต่อสู้ของ Brave ในคดีนั้นพูดถึงการทำดัชนีเพื่อพาคนไปยังเว็บ ซึ่งต่างจากข้อกล่าวหาใหม่ที่เน้นการคืนเนื้อหาเกือบทั้งบทความผ่าน AI และ API จึงยังไม่รู้ว่า Brave จะตอบคดีนี้ด้วยเหตุผลเดิมหรือไม่
ตัวเลขที่แหล่งข้อมูลเขียนไม่ตรงกัน
| เรื่อง | ฝั่งหนึ่ง | อีกฝั่ง |
|---|---|---|
| ผู้ใช้เบราว์เซอร์ต่อเดือน | คำฟ้อง: เกือบ 130 ล้านคน (ณ 30 ก.ย. 2026 อ้างหน้า Transparency ของ Brave) | หน้า About ของ Brave: "120+ ล้าน" |
| คำค้นต่อวันของ Brave Search | คำฟ้อง: กว่า 50 ล้านครั้ง (อ้างหน้า Brave AI) | หน้า About ของ Brave: "80+ ล้าน" |
| ทนายของใคร | The Next Web เขียนว่า Lieberman เป็นทนายของกลุ่ม Daily News และ Tribune | คำฟ้องทั้งสองฉบับ รวมถึงของ NYT ลงนามโดย Lieberman |
ตัวเลขผู้ใช้น่าจะต่างกันเพราะวัดคนละช่วงเวลา ReadEval ใช้ตัวเลขตามคำฟ้องเมื่ออ้างคำฟ้อง และไม่ได้นำตัวเลขเหล่านี้มาใช้สรุปผลใด ๆ
คนไทยเกี่ยวไหม และควรทำอะไร
คดีนี้ยื่นต่อศาลสหรัฐฯ และสิ่งที่โจทก์ขอคือค่าเสียหายกับคำสั่งห้ามให้ Brave หยุดการกระทำที่ถูกกล่าวหา ศาลยังไม่ได้มีคำสั่งใด ReadEval ยืนยันไม่ได้ว่าผลของคดีจะกระทบการใช้งาน Brave หรือแชตบอตที่ใช้ดัชนีของ Brave นอกสหรัฐฯ หรือไม่
- ถ้าคุณใช้แชตบอตค้นเว็บ: เมื่อได้คำตอบเรื่องข่าว ให้ดูลิงก์ที่มาและเปิดอ่านต้นฉบับ คำตอบที่สรุปมาอาจตัดบริบทออก และข้อพิพาทนี้ก็คือเรื่องที่ว่าผู้อ่านไม่ได้กลับไปที่เว็บต้นทาง
- ถ้าคุณใช้เบราว์เซอร์ Brave: ตอนนี้ไม่มีอะไรต้องเปลี่ยน ตัวเลือก Paywall blocker ไม่ได้เปิดเป็นค่าเริ่มต้นตามรายการตัวกรองทางการของ Brave
- ถ้าคุณดูแลเว็บไซต์: หน้าช่วยเหลือของ Brave บอกว่าบอตของ Brave ทำตามกฎที่คุณตั้งให้ Googlebot และใช้คำสั่ง noindex เพื่อเอาหน้าออกจากดัชนีได้ แต่ไม่มีชื่อบอตแยกให้บล็อกเฉพาะ Brave
คดีนี้ต่อจากคดีไหน
TechCrunch รายงานว่า The New York Times ฟ้อง OpenAI และ Perplexity ด้วยข้อกล่าวหาคล้ายกันมาก่อน และกลุ่ม Daily News กับ Tribune ก็ฟ้อง OpenAI และ Microsoft แยกต่างหาก คดีกับ Brave ต่างออกไปตรงที่เป้าหมายไม่ใช่ผู้ทำแชตบอตโดยตรง แต่เป็น "ผู้ค้าส่ง" ข้อมูลที่อยู่ตรงกลาง ReadEval เคยเขียนเรื่องที่มูลนิธิวิกิมีเดียขอยื่นความเห็นในคดี NYT กับ OpenAI ซึ่งแยกการฝึกโมเดลออกจากการดึงข้อมูลไปตอบ (RAG) ประเด็นเดียวกันนี้อยู่ใจกลางคดี Brave ด้วย เพราะคำฟ้องกล่าวหาทั้งสองอย่าง
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
คดีนี้ย้ายสนามจากผู้ทำแชตบอตไปที่ร้านค้าส่งข้อมูลที่อยู่ข้างหลัง และถ้าโจทก์ชนะ ต้นทุนของ "คำตอบค้นเว็บ" อาจเปลี่ยนทั้งวงการ
จุดแข็งของฝั่งหนังสือพิมพ์คือหลักฐานที่จับต้องได้ ข้อความ 1,291 จาก 1,295 คำ และ AI ที่เขียนเองว่าบทความติดเพย์วอลล์แต่ยังให้เนื้อหาเกือบทั้งหมด ทำให้ข้ออ้างแบบเครื่องมือค้นหาดั้งเดิมที่แสดงแค่ข้อความสั้น ๆ แล้วพาคนไปที่เว็บใช้ได้ยากขึ้น ส่วนจุดที่ Brave น่าจะสู้คือหลักการใช้โดยชอบธรรมของการทำดัชนี ซึ่ง Brave อ้างว่ามีแนวคำพิพากษารองรับมาหลายทศวรรษ และข้อเท็จจริงว่าบอตของตนทำตามกฎเดียวกับ Googlebot ข้อหาเรื่อง Paywall blocker ก็มีรายละเอียดที่ต้องพิสูจน์ ว่าตัวกรองที่ผู้ใช้ต้องเปิดเองและมาจากโครงการภายนอกนับเป็น "เครื่องมือหลบเลี่ยง" ตาม DMCA หรือไม่
สำหรับผู้อ่าน ประเด็นที่ควรจำไม่ใช่ว่าใครถูก เพราะยังอีกนาน แต่คือคำตอบที่แชตบอตบอกว่า "ค้นจากเว็บ" มีผู้เล่นซ่อนอยู่ตรงกลางเสมอ ทั้งดัชนีของใครสักคน และเนื้อหาของสำนักข่าวที่อาจไม่ได้ยินยอม การกดลิงก์ที่มาจึงช่วยทั้งให้คุณได้บริบทครบ และให้คนเขียนต้นฉบับยังอยู่ได้
แหล่งที่มา
- คำฟ้อง The New York Times Company v. Brave Software, Inc. (SDNY 1:26-cv-09549, 2 พ.ย. 2026)
- คำฟ้อง Daily News, Chicago Tribune, Orlando Sentinel v. Brave Software, Inc. (SDNY 1:26-cv-09554, 2 พ.ย. 2026)
- TheWrap: New York Times, Chicago Tribune Sue Tech Company Brave Over AI Copyright Claims
- TechCrunch: New York Times and other outlets sue web browser Brave over alleged content scraping
- The Next Web: New York Times and three other US papers sue Brave over AI scraping
- New York Daily News (ผ่าน The Spokesman-Review): Tech company Brave plundered Daily News content
- Search Engine Journal: NY Times Accuses Brave Of Scraping And Exploiting Content
- Brave Search Help: Brave Search Crawler
- Brave: Brave Search API (ราคาและลูกค้า)
- Brave: About Brave
- Brave Blog (2 พ.ย. 2023): Leo is now available to desktop users
- Brave Blog (ตรวจเมื่อ 3 พ.ย. 2026 ไม่พบโพสต์เรื่องคดี)
- Brave adblock-resources: รายการตัวกรองทางการ (Paywall blocker)
- คำฟ้อง Brave Software, Inc. v. News Corp (N.D. Cal. 3:25-cv-02503, 12 มี.ค. 2025)
- Wikimedia Commons: Brave lion icon


