ผู้ดูแล Wikipedia ขอยื่นความเห็นในคดี NYT ฟ้อง OpenAI ฝึก AI ได้ แต่ดึงไปตอบต้องให้เครดิต
Wikimedia ขอส่งความเห็นต่อศาลโดยไม่เข้าข้างฝ่ายใด เสนอว่าการฝึกโมเดลน่าจะเป็น fair use แต่แชตบอตที่ค้นเว็บแล้วดึงเนื้อหาไปตอบต้องให้เครดิตตามสัญญาอนุญาต

สารบัญ (9 หัวข้อ)
Wikipedia เป็นข้อมูลคุณภาพสูงชุดหนึ่งที่บริษัท AI ใช้ฝึกแชตบอต และยังเป็นหน้าที่แชตบอตบางตัวเปิดอ่านก่อนตอบคุณ ตอนนี้มูลนิธิ Wikimedia ผู้ดูแล Wikipedia เดินเข้าไปในคดีลิขสิทธิ์ AI คดีสำคัญของสหรัฐฯ พร้อมข้อเสนอว่า AI จะเรียนจากบทความก็ได้ แต่ถ้าดึงบทความไปตอบคำถาม ต้องบอกว่าเอามาจากใคร
คดีนี้รวมคดีที่ฟ้อง OpenAI ไว้ 12 คดีในศาลรัฐบาลกลางที่นิวยอร์ก ที่ดังที่สุดคือคดีที่ New York Times ฟ้อง OpenAI และ Microsoft ฝั่งผู้ฟ้องบอกว่าการเอาบทความไปใช้ทุกขั้นตอนละเมิดลิขสิทธิ์ ฝั่ง OpenAI บอกว่าทุกขั้นตอนเป็น "การใช้โดยชอบธรรม" (fair use) หลักกฎหมายสหรัฐฯ ที่ยอมให้ใช้งานของคนอื่นได้ในบางกรณีโดยไม่ต้องขออนุญาต Wikimedia ไม่เข้าข้างฝ่ายไหน และมองว่าทั้งสองฝ่ายพูดกว้างเกินไป
ข้อเสนอของ Wikimedia คือให้ศาลแยกการใช้งานออกเป็นสองแบบ ลองนึกถึงคนที่อ่านหนังสือทั้งห้องสมุดจนเขียนหนังสือเองเป็น กับคนที่พอมีใครถามก็หยิบหนังสือเล่มหนึ่งมาเปิดอ่านคำตอบให้ฟัง แบบแรกคือการฝึกโมเดล Wikimedia มองว่าน่าจะเป็น fair use แบบหลังคือการที่แชตบอตค้นเว็บแล้วดึงเนื้อหามาประกอบคำตอบ (RAG) Wikimedia มองว่าน่าจะไม่ใช่ และต้องทำตามสัญญาอนุญาตของต้นทาง สำหรับ Wikipedia คือต้องให้เครดิตผู้เขียน ต่างกันตรงที่ AI ไม่ได้จำความรู้แบบคน ตามคำอธิบายของ Wikimedia มันเรียนรูปแบบของภาษาจากข้อความเหล่านั้น
ทำไม Wikimedia ถึงสนใจ เพราะ Wikipedia อยู่ได้ด้วยอาสาสมัครเกือบ 250,000 คนต่อเดือน และสัญญาอนุญาตของ Wikipedia ออกแบบมาให้ผู้เขียนได้เครดิต ถ้าแชตบอตตอบแทนโดยไม่บอกที่มา คนก็ไม่กลับไปอ่าน ไม่มาช่วยแก้ ไม่มาบริจาค แต่ถ้าศาลห้ามฝึกโมเดลไปเลย Wikimedia กลัวว่าจะมีแต่บริษัทใหญ่ที่จ่ายค่าข้อมูลไหว และอาสาสมัครจะเสียเครื่องมือ AI ที่ช่วยจับการก่อกวนบทความ
ต้องย้ำว่านี่เป็นความเห็นของคนนอกคดี ไม่ใช่คำตัดสิน และที่จริง Wikimedia ยื่นคำร้องขออนุญาตส่งความเห็นพร้อมแนบร่าง ศาลยังต้องตัดสินว่าจะรับหรือไม่ ระหว่างนี้ถ้าคุณใช้แชตบอตหาข้อมูล ลองดูว่าคำตอบมีลิงก์ที่มาไหม แล้วกดเข้าไปอ่านต้นฉบับ สถานะคดี จุดยืนของแต่ละฝ่าย และเรื่อง Wikipedia ภาษาไทยอยู่ด้านล่าง
สรุปประเด็นสำคัญ
- ยื่นอะไร: วันที่ 29 ต.ค. 2026 มูลนิธิ Wikimedia ยื่นคำร้องขออนุญาตส่งคำแถลงในฐานะมิตรศาล (amicus brief) ต่อศาลแขวงสหรัฐฯ เขตนิวยอร์กใต้ พร้อมแนบร่างคำแถลงที่ระบุในชื่อเอกสารว่า "ไม่สนับสนุนฝ่ายใด" (In Support of Neither Party) ศาลยังไม่ได้ตอบรับ ตามข้อมูลที่ ReadEval ตรวจได้
- ฝึกโมเดล: Wikimedia ขอให้ศาลวินิจฉัยว่าการฝึกโมเดลพื้นฐานของ ChatGPT เป็น fair use
- ค้นแล้วเอามาตอบ (RAG): Wikimedia ขอให้ศาลวินิจฉัยว่าการที่ระบบ RAG ของ ChatGPT คัดลอกและนำเนื้อหามาใช้ในคำตอบไม่เป็น fair use และต้องทำตามสัญญาอนุญาต เช่น CC BY-SA ของ Wikipedia
- ดูดข้อมูลเว็บ: ตัวการดูดข้อมูล (scraping) ไม่ควรถูกนับเป็น "การใช้" ในทางลิขสิทธิ์ แต่ต้องทำโดยไม่ทำให้เซิร์ฟเวอร์ของ Wikipedia รับภาระเกินไป
- คดียังไม่ตัดสิน: คู่ความยื่นคำร้องให้ศาลตัดสินโดยไม่ต้องสืบพยาน (summary judgment) ไปแล้วเมื่อ 4 ก.ย. 2026 และยังไม่มีวันนัดฟังคำตัดสิน
Wikimedia "ยื่นแล้ว" หรือ "ขออนุญาตยื่น"
คำตอบที่ตรงที่สุดคือ ยื่นคำร้องขออนุญาตแล้ว และแนบร่างคำแถลงไปด้วย
ประกาศของ Wikimedia Foundation เมื่อ 30 ต.ค. 2026 เขียนว่ามูลนิธิ "ยื่น amicus brief ในวันนี้" ส่วนบล็อก Diff ของมูลนิธิเขียนว่า "ได้ยื่น amicus brief แล้ว" แต่เอกสารที่ Wikimedia เผยแพร่เองบน Wikimedia Commons ให้รายละเอียดมากกว่านั้น เอกสารชุดนี้มีตราของระบบศาลว่ายื่นเมื่อ 29 ต.ค. 2026 เป็นเอกสารหมายเลข 2361 ในคดี In re: OpenAI, Inc. Copyright Infringement Litigation (หมายเลข 25-md-3143) และประกอบด้วยสองส่วน
| ส่วน | คืออะไร |
|---|---|
| จดหมายถึงผู้พิพากษา Sidney H. Stein | คำร้องขออนุญาตส่งคำแถลงในฐานะมิตรศาล เขียนโดย Rhett O. Millsaps II จากสำนักงานกฎหมาย Lex Lumina ซึ่งเป็นทนายของ Wikimedia |
| เอกสารแนบ A | ร่างคำแถลงที่หัวเอกสารเขียนว่า "[PROPOSED] AMICUS CURIAE BRIEF OF WIKIMEDIA FOUNDATION IN SUPPORT OF NEITHER PARTY" ยาว 5,831 คำ ไม่เกินเพดาน 6,000 คำที่ศาลกำหนด |
จดหมายอธิบายว่าคำสั่งศาลเมื่อ 7 ส.ค. 2026 กำหนดให้ผู้ที่อยากส่งความเห็นในฐานะมิตรศาลต้องยื่นคำร้องขออนุญาตก่อน Wikimedia จึงไม่ได้ขอความยินยอมจากคู่ความ และระบุว่าศาลมีดุลพินิจกว้างว่าจะรับหรือไม่รับ คำว่า "[PROPOSED]" จึงแปลว่าเอกสารยังเป็นร่างจนกว่าศาลจะอนุญาต ณ วันที่ 30 ต.ค. 2026 ReadEval ยังไม่พบคำสั่งศาลเรื่องนี้
คำแถลงในฐานะมิตรศาลเป็นความเห็นของคนนอกคดีที่มีข้อมูลหรือมุมมองที่อาจช่วยศาล ไม่ได้ทำให้ Wikimedia กลายเป็นคู่ความ และศาลไม่มีหน้าที่ต้องเห็นด้วย ก่อนหน้านี้เมื่อ 1 ก.ย. 2026 รัฐบาลสหรัฐฯ ก็ยื่นความเห็นในคดีนี้ โดยเข้าข้าง OpenAI ว่าการฝึก AI โดยทั่วไปเป็น fair use ตามที่ Reuters รายงาน
Wikimedia ไม่ได้เข้าข้าง OpenAI ใช่ไหม
ใช่ บล็อก Diff เขียนตรง ๆ ว่ามูลนิธิ "ไม่ได้เข้าข้าง OpenAI หรือ The New York Times" และท้ายร่างคำแถลงขอให้ศาล "ไม่รับจุดยืนของคู่ความฝ่ายใด" แทนที่จะตัดสินแบบเหมารวมว่า "OpenAI ใช้อย่างไรก็ชอบธรรม" หรือ "OpenAI ใช้อย่างไรก็ไม่ชอบธรรม" The Verge ก็รายงานตรงกันว่า Wikimedia เลือกยืนตรงกลางและไม่เข้าข้างฝ่ายใด
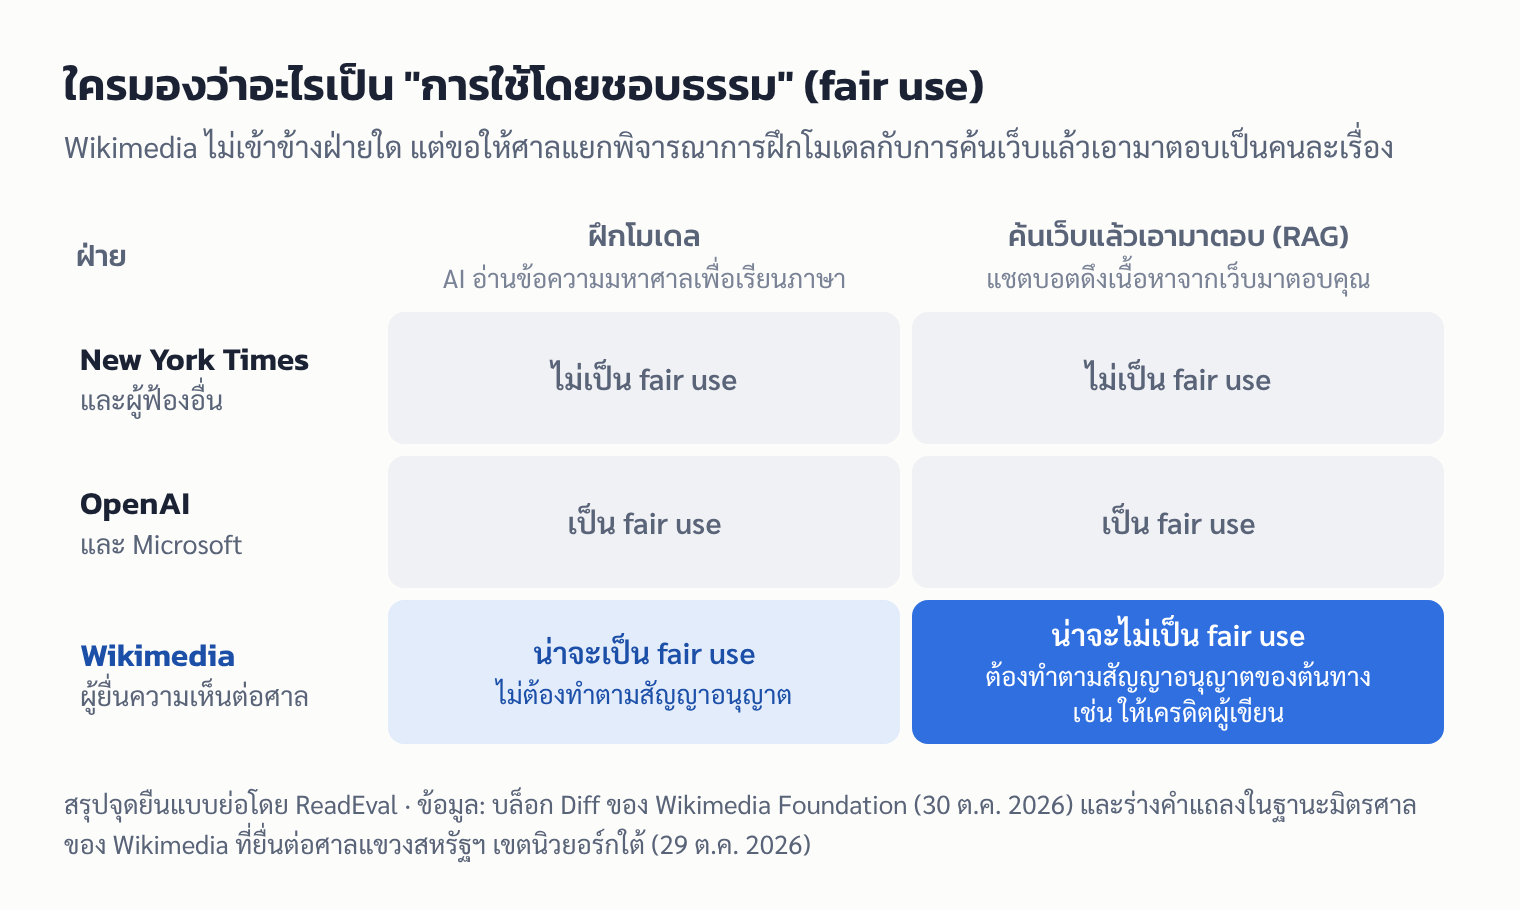
จุดที่ทำให้ดูเหมือนเอียงไปทาง OpenAI คือเรื่องการฝึกโมเดล ส่วนจุดที่ตรงกับ New York Times คือเรื่องการดึงเนื้อหาไปตอบ ร่างคำแถลงยังเห็นด้วยกับ New York Times ว่าการสร้างแชตบอตแบ่งได้ 4 ขั้น คือ เก็บข้อมูล ฝึกโมเดลพื้นฐาน ปรับแต่งหลังฝึก และสร้างคำตอบ แล้วขอให้ศาลพิจารณาแต่ละขั้นแยกกัน โดยอ้างคำพิพากษาศาลสูงสุดสหรัฐฯ ปี 2023 คดี Warhol ที่ว่า "การคัดลอกแบบเดียวกันอาจชอบธรรมเมื่อใช้เพื่อจุดประสงค์หนึ่ง แต่ไม่ชอบธรรมเมื่อใช้เพื่ออีกจุดประสงค์หนึ่ง"
จดหมายถึงศาลสรุปเหตุผลที่ Wikimedia เข้ามาไว้ว่า "จุดยืนที่คู่ความเสนอในคดีนี้ใช้หลัก fair use กว้างเกินไป"
"ฝึกโมเดล" กับ "ค้นแล้วเอามาตอบ" ต่างกันอย่างไร
ฝึกโมเดล คือการให้ AI อ่านข้อความจำนวนมหาศาลก่อนเปิดให้คนใช้ ร่างคำแถลงอธิบายว่าจุดประสงค์ของสำเนาบทความในขั้นนี้คือ "ให้รูปแบบทางภาษา" แก่โมเดล ไม่ใช่ส่งต่อเนื้อหาให้คนอ่าน จึงต่างจากจุดประสงค์ของบทความ Wikipedia ที่มีไว้ให้ข้อมูลผู้อ่าน Wikimedia มองว่าการใช้แบบนี้เปลี่ยนรูปไปจากต้นฉบับ (transformative) และไม่ได้มาแย่งคนอ่านจากต้นฉบับโดยตรง จึง "น่าจะเป็น fair use"
ค้นแล้วเอามาตอบ (RAG ย่อจาก retrieval-augmented generation) เกิดตอนคุณถามคำถาม ระบบจะค้นเว็บ คัดลอกข้อความ ตัดเป็นท่อน ๆ เลือกท่อนที่เกี่ยวข้องที่สุดไปวางรวมกับคำถามของคุณ แล้วให้โมเดลเขียนคำตอบ ร่างคำแถลงบอกว่าคำตอบแบบนี้มักนำเนื้อหาต้นฉบับมาใช้ซ้ำอย่างมาก ทั้งแบบคำต่อคำและแบบคล้ายกันมาก การใช้แบบนี้ทำหน้าที่เดียวกับต้นฉบับ คือให้ข้อมูลคนที่กำลังค้นหา และทำให้คนไม่ต้องคลิกไปที่เว็บต้นทาง Wikimedia จึงมองว่า "น่าจะไม่เป็น fair use"
Wikimedia ไม่ได้ขอให้ห้ามแชตบอตใช้ Wikipedia หรือให้จ่ายเงิน สิ่งที่ขอคือให้ทำตามสัญญาอนุญาต Creative Commons CC BY-SA 4.0 ซึ่งมีสองเงื่อนไข
- BY (แสดงที่มา): ต้องให้เครดิตผู้สร้างงาน
- SA (อนุญาตแบบเดียวกัน): ถ้าดัดแปลงต่อ งานที่ได้ต้องเปิดให้ใช้ภายใต้สัญญาอนุญาตเดียวกัน
ร่างคำแถลงเสนอว่าถ้าศาลกำหนดให้ต้องทำตามสัญญาอนุญาต ผู้พัฒนาจะออกแบบให้คำตอบที่มาจาก RAG แนบที่มาของเนื้อหาไปด้วย แชตบอตที่ดึงข้อมูลจาก Wikipedia ก็จะให้เครดิตหรือใส่ลิงก์กลับไปที่ต้นฉบับสม่ำเสมอกว่าเดิม
แล้ว ChatGPT ที่ใส่ลิงก์อยู่แล้วล่ะ
ร่างคำแถลงยอมรับเรื่องนี้ไว้ในเชิงอรรถ ว่ามีบริการที่ใช้ RAG "รวมถึง ChatGPT" ที่พยายามอ้างอิงและใส่ลิงก์ไปยังต้นทางอย่างสม่ำเสมอ และเมื่อทำเช่นนั้นจนเป็นไปตามเงื่อนไข CC BY-SA ของ Wikipedia ก็มีโอกาสละเมิดน้อยลง แชตบอตบางตัวยังดึงข้อมูลจากฐานข้อมูลของตัวเองที่มีสิทธิ์ใช้อยู่แล้ว Wikimedia จึงย้ำว่าต้องดูข้อเท็จจริงเป็นกรณีไป
ร่างคำแถลงยังแยก "การสรุป" ออกจากการคัดลอก โดยบอกว่าบทสรุปที่ใช้ถ้อยคำของตัวเองอาจไม่ละเมิดลิขสิทธิ์เลย และไม่ควรถูกมองว่าไม่ชอบธรรมไปโดยอัตโนมัติ ประเด็นคือบทสรุปนั้นทำหน้าที่ต่างจากต้นฉบับ หรือมาแทนต้นฉบับ
ส่วนการดูดข้อมูลเว็บ Wikimedia เสนอว่าตัวการเก็บสำเนาไม่ใช่ "การใช้" ที่ต้องเอามาชั่งเรื่อง fair use สิ่งที่ต้องชั่งคือเอาสำเนานั้นไปทำอะไร แต่มูลนิธิก็ย้ำว่าไม่ว่าจะเก็บไปฝึกหรือไปตอบ ต้องทำตามเพดานการเรียกข้อมูลของ API สาธารณะ หรือใช้บริการ Wikimedia Enterprise API ร่างคำแถลงเปรียบไว้ว่า สวนสาธารณะเปิดให้ทุกคนเข้าได้ฟรี แต่ก็ห้ามขับรถบรรทุกตู้คอนเทนเนอร์ผ่ากลางสวนได้
Wikipedia ภาษาไทยเกี่ยวด้วยไหม
Wikipedia ภาษาไทยใช้สัญญาอนุญาตครีเอทีฟคอมมอนส์แบบแสดงที่มา-อนุญาตแบบเดียวกัน (CC BY-SA 4.0) เหมือนภาษาอื่น ตามที่ระบุไว้ท้ายทุกหน้า เงื่อนไขให้เครดิตที่ Wikimedia พูดถึงจึงครอบคลุมเนื้อหาภาษาไทยด้วย ในแง่ของสัญญาอนุญาต
แต่มีข้อจำกัดที่ต้องพูดให้ชัด
- คดีนี้อยู่ในศาลสหรัฐฯ และว่าด้วยกฎหมายลิขสิทธิ์สหรัฐฯ คำตัดสินไม่ได้เปลี่ยนกฎหมายไทย
- ศาลอาจไม่รับคำแถลงของ Wikimedia หรือรับแต่ไม่เห็นด้วยก็ได้
- ถ้าศาลตัดสินไปทางที่ Wikimedia เสนอ บริษัท AI จะเปลี่ยนวิธีแสดงที่มาในคำตอบสำหรับผู้ใช้ในไทยด้วยหรือไม่ ยังไม่มีใครยืนยัน
สิ่งที่ทำได้ทันทีไม่ต้องรอศาล คือถ้าคุณนำข้อความจาก Wikipedia ไปใช้ต่อในรายงาน โพสต์ หรือคลิป เงื่อนไข CC BY-SA ใช้กับคุณเหมือนกัน ต้องให้เครดิตและบอกสัญญาอนุญาต ไม่ว่าคุณจะได้ข้อความนั้นมาเองหรือผ่านแชตบอต
คดีนี้ไปถึงไหนแล้ว
| วันที่ | เหตุการณ์ |
|---|---|
| 2023 | New York Times ฟ้อง OpenAI และ Microsoft |
| 1 ก.ย. 2026 | รัฐบาลสหรัฐฯ ยื่นความเห็นในคดี สนับสนุนว่าการฝึก AI โดยทั่วไปเป็น fair use (Reuters) |
| 4 ก.ย. 2026 | ทั้งฝั่งผู้ฟ้อง (กลุ่มสื่อที่นำโดย New York Times และกลุ่มนักเขียนหนังสือ) และฝั่ง OpenAI กับ Microsoft ยื่นคำร้องให้ศาลตัดสินโดยไม่ต้องสืบพยาน |
| 29 ต.ค. 2026 | Wikimedia ยื่นคำร้องขออนุญาตส่งคำแถลงในฐานะมิตรศาล พร้อมแนบร่าง |
| 30 ต.ค. 2026 | Wikimedia ประกาศเรื่องนี้บนเว็บมูลนิธิและบล็อก Diff |
| 6 พ.ย. 2026 | กำหนดส่งคำแถลงตอบรอบสุดท้ายของคำร้อง summary judgment ตามที่เว็บติดตามคดี ChatGPT Is Eating the World รายงาน ยังไม่มีวันนัดฟังคำตัดสิน |
ประกาศของ Wikimedia ระบุว่าคำตัดสินเรื่อง fair use ในคดีนี้น่าจะมีอิทธิพลสูง เพราะศาลนี้มีน้ำหนัก คู่ความเป็นบริษัทใหญ่ และยังมีศาลไม่กี่แห่งที่เคยตัดสินประเด็นนี้ ร่างคำแถลงอ้างคำตัดสินปี 2025 ของศาลในแคลิฟอร์เนียสองคดี ได้แก่ Bartz v. Anthropic และ Kadrey v. Meta ซึ่งมองว่าการฝึกโมเดลเปลี่ยนรูปไปจากต้นฉบับ และคดีแรกแยกพิจารณาการเก็บสำเนาหนังสือละเมิดลิขสิทธิ์ไว้ในคลังออกจากการนำไปฝึก
Wikimedia พูดถึงตัวเองอย่างไร
ประกาศของมูลนิธิระบุว่า Wikipedia มีบทความกว่า 67 ล้านบทความใน 300 ภาษา มีอาสาสมัครเกือบ 250,000 คนต่อเดือน และเป็นชุดข้อมูลคุณภาพสูงที่สุดชุดหนึ่งที่ใช้ฝึกโมเดลภาษา ร่างคำแถลงเล่าว่าเครื่องมือจากสาย machine learning ช่วยอาสาสมัครจับการก่อกวนบทความ ตรวจหาการละเมิดลิขสิทธิ์และข้อมูลส่วนตัวที่ไม่ควรเผยแพร่ และเลือกบทความที่ต้องการการปรับปรุง นี่คือเหตุผลที่ Wikimedia ไม่อยากให้การฝึกโมเดลถูกห้ามทั้งหมด
Bernadette Meehan ซีอีโอของ Wikimedia Foundation กล่าวว่า "การขยายการเข้าถึงความรู้ผ่าน AI เป็นเป้าหมายที่ทรงพลัง แต่ต้องเคารพผู้คน ผู้ร่วมเขียน และชุมชนที่ทำให้ความรู้ที่เชื่อถือได้เกิดขึ้น" ส่วน Stephen LaPorte ที่ปรึกษากฎหมายใหญ่ของมูลนิธิ เขียนในบล็อก Diff ว่า ถ้าศาลให้สิทธิ์บริษัท AI ข้ามเงื่อนไขสัญญาอนุญาตได้ทั้งหมด สำนักพิมพ์จะล็อกข้อมูลไว้หลังกำแพงมากขึ้น และอาสาสมัครที่เขียน Wikipedia ก็จะมีแหล่งอ้างอิงน้อยลง
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
Wikimedia ไม่ได้ยืนข้าง OpenAI หรือ New York Times แต่เสนอเส้นแบ่งใหม่ ให้ AI เรียนได้ แต่ถ้าดึงไปตอบต้องบอกที่มา
ข้อเสนอนี้น่าสนใจเพราะมาจากองค์กรที่อยู่ทั้งสองฝั่งของเรื่อง Wikipedia เป็นทั้งข้อมูลที่ AI เรียน และเป็นผู้ใช้เครื่องมือ AI เอง แถมเนื้อหายังเปิดให้ใช้ฟรีอยู่แล้ว สิ่งที่ Wikimedia ต้องการจึงไม่ใช่เงิน แต่เป็นสิ่งที่ทำให้คนยังกลับมาอ่านและเขียนต่อ คือเครดิตและลิงก์ เส้นแบ่งระหว่าง "เรียน" กับ "หยิบมาตอบ" ยังฟังง่ายกว่าข้อถกเถียงเรื่อง fair use ทั่วไปมาก
จุดที่ต้องระวังคือ น้ำหนักของเอกสารนี้ในทางกฎหมายยังไม่แน่นอน ศาลยังไม่ได้รับคำแถลง และเส้นแบ่งในทางปฏิบัติก็ไม่ได้ชัดเท่าในเอกสาร แชตบอตรุ่นใหม่ผสมความรู้จากการฝึกกับข้อมูลที่ค้นสด ๆ ในคำตอบเดียว ส่วนคำว่า "ให้เครดิตตาม CC BY-SA" ในหน้าจอแชตควรหน้าตาเป็นอย่างไร ก็ยังไม่มีใครกำหนด ReadEval มองว่าถ้าศาลเห็นด้วยแม้เพียงบางส่วน ผลที่ผู้ใช้น่าจะได้เห็นคือคำตอบที่มีลิงก์ที่มามากขึ้น ซึ่งเป็นผลดีกับคนอ่านอยู่แล้ว ไม่ว่าศาลจะตัดสินคดีหลักออกมาทางไหน
แหล่งที่มา
- Wikimedia Foundation: The Wikimedia Foundation files to protect open knowledge in New York Times v OpenAI case (30 ต.ค. 2026)
- Diff (บล็อกของ Wikimedia): Why Wikimedia Is Speaking Up in a Major AI Copyright Case โดย Stephen LaPorte
- คำร้องขออนุญาตและร่างคำแถลงในฐานะมิตรศาลของ Wikimedia Foundation, In re: OpenAI, Inc. Copyright Infringement Litigation, 25-md-3143 (S.D.N.Y.) เอกสารหมายเลข 2361 ยื่น 29 ต.ค. 2026
- The Verge: Wikipedia’s operator says a bad AI copyright ruling could threaten the open web (Lauren Feiner)
- Reuters ผ่าน Claims Journal: Government Backs OpenAI in New York Times Copyright Case (2 ก.ย. 2026)
- ChatGPT Is Eating the World: Summary judgment briefing starts in OpenAI MDL Litigation before Judge Stein
- ChatGPT Is Eating the World: Summary judgment briefing gets pushed back in OpenAI MDL suit, replies due Nov. 6
- วิกิพีเดียภาษาไทย: ข้อความสัญญาอนุญาตท้ายหน้า (CC BY-SA 4.0)
- Creative Commons: Attribution-ShareAlike 4.0 International (CC BY-SA 4.0)
- Wikimedia Commons: Wikipedia logo v2

