โมเดล AI แจกฟรีเดือนตุลาคม ตัวไหนรันบนโน้ตบุ๊ก 16GB ได้ ตัวไหนต้องใช้เซิร์ฟเวอร์
เทียบโมเดลแบบเปิดเดือนตุลาคม 2026 โน้ตบุ๊ก 16GB รันได้สบายแค่ Nemotron Bolt E4B ตัวใหญ่ต้องใช้หลักร้อย GB ส่วน Mistral Large 4 และ Kimi K3.1 Pro ยังไม่ปล่อยไฟล์
สารบัญ (11 หัวข้อ)
- สรุปประเด็นสำคัญ
- ตารางเทียบ: ตัวไหนรันบนโน้ตบุ๊ก 16GB ได้
- รุ่นเล็กที่คนทั่วไปลองได้จริง
- รุ่นใหญ่: โหลดได้ แต่เหมาะกับองค์กร
- ยังไม่ปล่อยไฟล์: Mistral Large 4 และ Kimi K3.1 Pro
- ภาษาไทยใช้ได้ไหม
- ใช้ทำธุรกิจได้ไหม
- เช็กเครื่องและลองรันอย่างไร
- ไม่อยากรันเอง ลองที่ไหนได้
- สิ่งที่แหล่งข้อมูลรายงานไม่ตรงกัน
- บทวิเคราะห์จาก ReadEval
ลองนึกภาพว่ามีคนแจกแบบบ้านให้ดาวน์โหลดฟรี แต่พอเปิดดูกลับพบว่าแบบส่วนใหญ่เป็นห้างสรรพสินค้า ส่วนที่ดินหลังบ้านคุณสร้างได้แค่หลังเล็กที่สุด นี่คือภาพของโมเดล AI แบบ "โหลดไปรันเองได้" ที่ออกมาถี่เป็นพิเศษในเดือนตุลาคม 2026 ทั้งจาก NVIDIA, Meta และ DeepSeek ไปจนถึงสตาร์ตอัป ทุกตัวเปิดให้ดาวน์โหลด แต่จะรันบนโน้ตบุ๊กที่บ้านได้หรือไม่เป็นอีกเรื่อง
การแจกแบบนี้เรียกว่า open-weight คือบริษัทปล่อยไฟล์ตัวโมเดลให้นำไปรันบนเครื่องของตัวเอง "ที่ดิน" ในภาพเปรียบเทียบนี้คือหน่วยความจำของเครื่อง ทั้ง RAM และหน่วยความจำการ์ดจอ เพราะไฟล์โมเดลทั้งก้อนต้องโหลดค้างไว้ตลอดเวลาที่ใช้งาน ต่างจากแบบบ้านตรงที่โมเดลย่อส่วนได้ วิธีที่เรียกว่าการบีบอัด (quantization) ลดความละเอียดของตัวเลขข้างในจนไฟล์เล็กลงหลายเท่า แลกกับความแม่นยำที่ลดลงบ้าง แต่ถึงย่อแล้ว ตัวใหญ่ก็ยังใหญ่เกินบ้านอยู่ดี
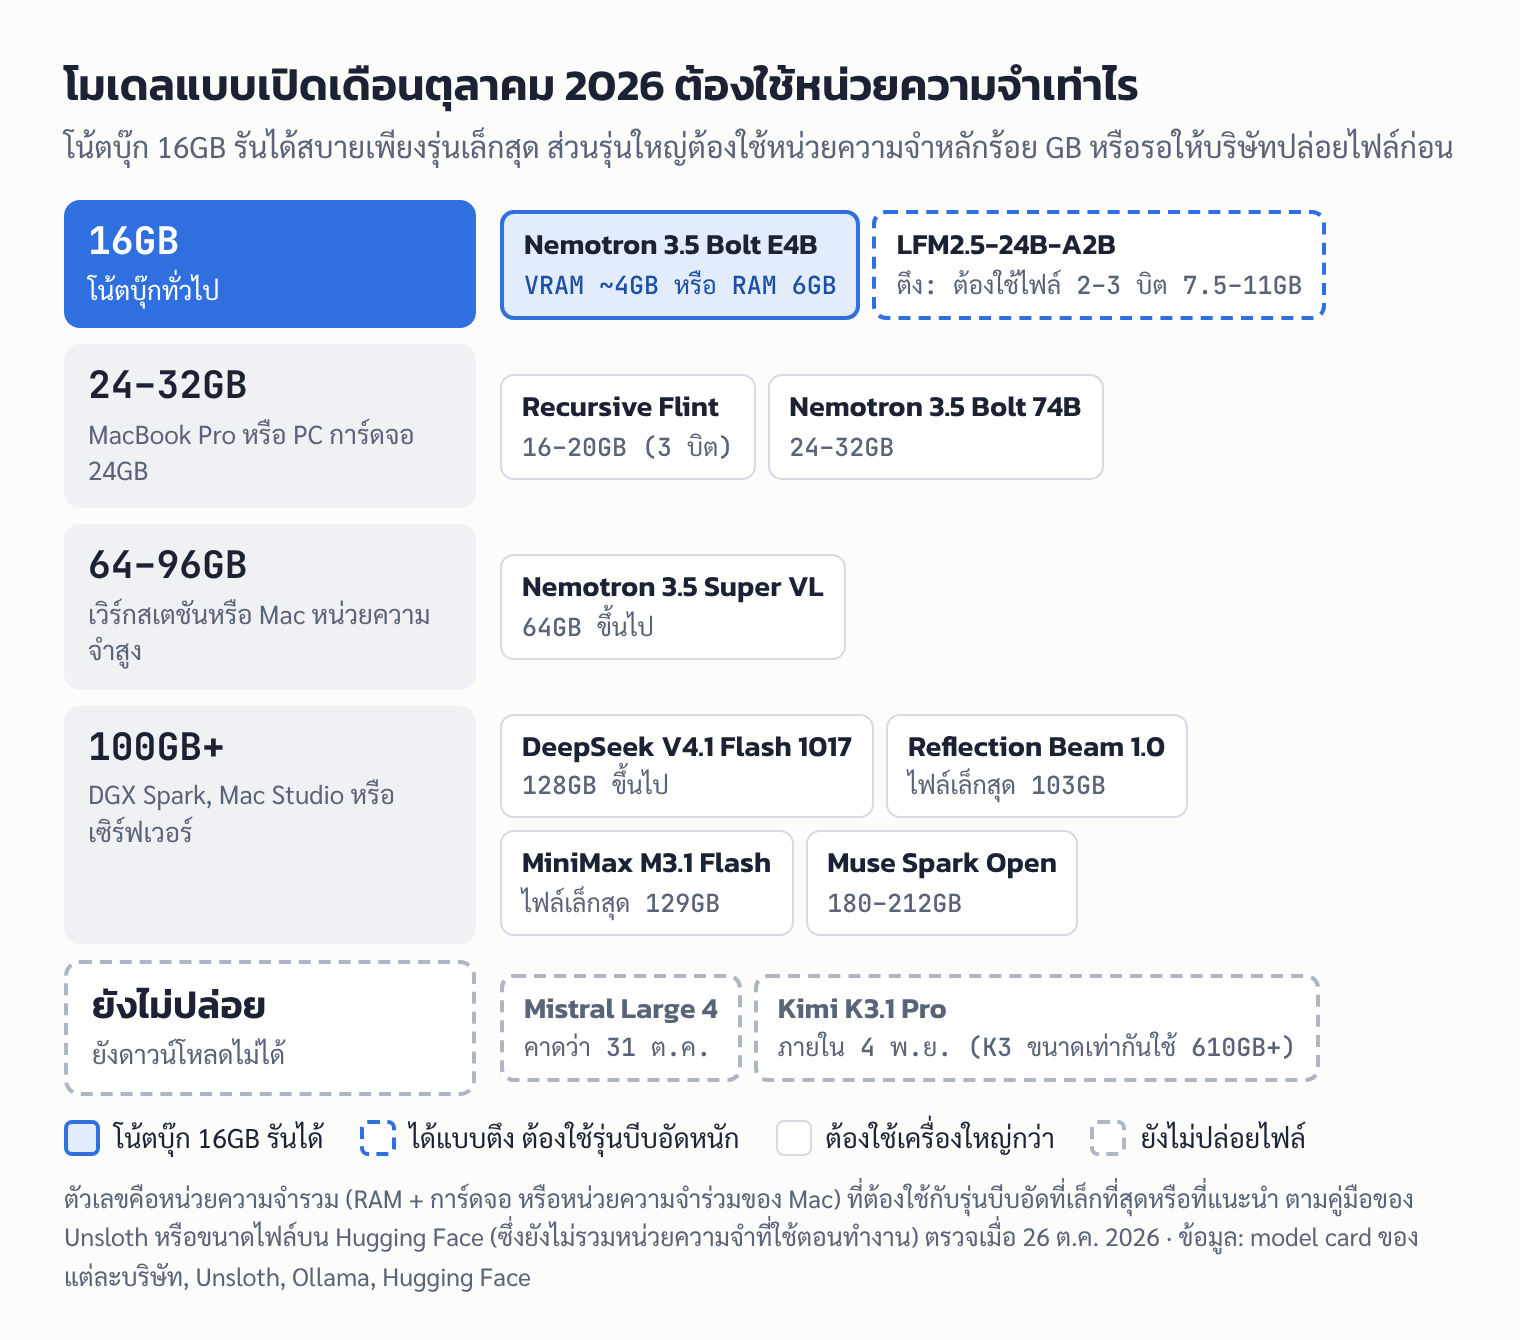
ReadEval ไล่ดูโมเดลแบบเปิดที่เป็นข่าวในเดือนนี้ เทียบกับโน้ตบุ๊ก RAM 16GB ซึ่งเป็นสเปกที่พบบ่อย ตัวที่รันได้สบายมีเพียง Nemotron 3.5 Bolt E4B รุ่นเล็กของ NVIDIA ซึ่งใช้หน่วยความจำการ์ดจอเพียงราว 4GB อีกตัวคือ LFM2.5 ของ Liquid AI พอรันได้แบบตึง ๆ ถ้าเลือกรุ่นที่บีบอัดหนัก ส่วนตัวใหญ่ที่เป็นข่าวมากที่สุดต้องใช้หน่วยความจำราว 100GB ขึ้นไป หรือกว่า 6 เท่าของโน้ตบุ๊กทั่วไป และ Mistral Large 4 กับ Kimi K3.1 Pro ยังไม่ได้ปล่อยไฟล์ด้วยซ้ำ
แล้วทำไมต้องสนใจ เพราะโมเดลที่รันในเครื่องไม่ส่งข้อความของคุณออกไปไหน ไม่มีค่าสมาชิก และใช้ได้แม้ไม่ต่ออินเทอร์เน็ต เหมาะกับงานที่มีข้อมูลลับ ข้อควรรู้คือรุ่นเล็กแลกความเก่งกับขนาด อย่าคาดหวังระดับเดียวกับแชตบอตบนคลาวด์ และตัวเลขผลทดสอบที่แต่ละบริษัทโฆษณาเป็นผลที่บริษัทวัดเองเกือบทั้งหมด
ถ้าอยากลอง ให้เช็กก่อนว่าเครื่องคุณมีหน่วยความจำเท่าไร แล้วเริ่มจากรุ่นเล็กผ่านโปรแกรมฟรีอย่าง Ollama โดยดาวน์โหลดจากเว็บทางการเท่านั้น และระวังรุ่นที่มีคำว่า cloud ซึ่งแปลว่าโมเดลทำงานบนเซิร์ฟเวอร์ ไม่ใช่ในเครื่องคุณ ส่วนตัวใหญ่ ลองผ่านเว็บหรือแอปของบริษัทง่ายกว่า ตารางเทียบทุกตัว วิธีเช็กเครื่อง และคำสั่งที่ใช้อยู่ด้านล่าง
สรุปประเด็นสำคัญ
- โน้ตบุ๊ก 16GB รันได้สบายตัวเดียวในกลุ่มนี้: Nemotron 3.5 Bolt E4B ของ NVIDIA (ปล่อย 23 ต.ค. 2026) ใช้หน่วยความจำการ์ดจอราว 4GB หรือ RAM ราว 6GB ตามคู่มือของ Unsloth ส่วน LFM2.5-24B-A2B ของ Liquid AI รันได้แบบตึงด้วยรุ่นบีบอัด 2–3 บิต
- เครื่อง 24–32GB ได้เพิ่มอีกสองตัว: Flint ของ Recursive และ Nemotron 3.5 Bolt 74B ของ NVIDIA
- ตัวใหญ่ต้องใช้ 64GB ถึงหลายร้อย GB: Nemotron 3.5 Super VL, Reflection Beam, MiniMax M3.1 Flash, DeepSeek V4.1 Flash 1017 และ Muse Spark Open เหมาะกับองค์กรหรือคนที่มีเครื่องระดับเวิร์กสเตชัน
- ยังไม่ปล่อยไฟล์ (ณ 26 ต.ค. 2026): Mistral Large 4 (หน้า Hugging Face ระบุกำหนด 31 ต.ค.) และ Kimi K3.1 Pro (Moonshot บอกว่า "ภายใน 4 พ.ย.") ตอนนี้ใช้ได้ผ่าน API และแอปเท่านั้น
ตารางเทียบ: ตัวไหนรันบนโน้ตบุ๊ก 16GB ได้
| โมเดล (บริษัท) | ขนาด (ทั้งหมด / ใช้งานจริงต่อ token) | สัญญาอนุญาต | หน่วยความจำขั้นต่ำ (ที่มา) | โน้ตบุ๊ก 16GB |
|---|---|---|---|---|
| Nemotron 3.5 Bolt E4B (NVIDIA) | 8B / 4B (effective) | OpenMDW-1.1 | VRAM ราว 4GB หรือ RAM 6GB (Unsloth) · ไฟล์ Ollama 7.2–7.9GB | ได้ |
| LFM2.5-24B-A2B (Liquid AI) | 24B / 2.45B | LFM Open License v1.0 | ไฟล์ Ollama 14–15GB (4 บิต) · ไฟล์ Unsloth 7.5–11GB (2–3 บิต) | ตึง (ต้องใช้รุ่น 2–3 บิต) |
| Flint (Recursive) | 39.8B / 2.5B | Apache 2.0 | 13–15GB (2 บิต), 16–20GB (3 บิต) (Unsloth) · ไฟล์ Ollama 23GB | ไม่ได้ (ตึงเกินไป) |
| Nemotron 3.5 Bolt 74B-A9B (NVIDIA) | 74B / 9B | OpenMDW-1.1 | 24–32GB (Unsloth) · ไฟล์ Ollama 25GB | ไม่ได้ |
| Nemotron 3.5 Super VL (NVIDIA) | 120B / 12B | OpenMDW-1.1 | 64GB ขึ้นไป (Unsloth, รุ่น 1 บิต) · ไฟล์ Ollama 80–90GB | ไม่ได้ |
| Beam 1.0 (Reflection AI) | 501B / 23B | Apache 2.0 | ไฟล์เล็กสุด 103GB (Unsloth, 1 บิต) · Reflection: เซิร์ฟเวอร์ GPU 8 ใบสำหรับรุ่น 8 และ 4 บิต · Ollama มีแต่แบบ cloud | ไม่ได้ |
| MiniMax M3.1 Flash (MiniMax) | ราว 428B / 23B | MiniMax Community License | ไฟล์เล็กสุด 129GB (Unsloth, 1 บิต) · Ollama มีแต่แบบ cloud | ไม่ได้ |
| DeepSeek V4.1 Flash 1017 (DeepSeek) | 552B (แกนหลัก) | MIT | 128GB ขึ้นไป (Unsloth) | ไม่ได้ |
| Muse Spark Open (Meta) | 816B / 42B | Muse Model License | 180–212GB (Unsloth, 1 บิต) · 700GB รุ่น NVFP4 (model card) | ไม่ได้ |
| Mistral Large 4 (Mistral AI) | ราว 1T / 49B (52B รวมชั้น embedding และชั้นผลลัพธ์) | ยังไม่ประกาศ | ยังไม่มีไฟล์ ยังไม่มีตัวเลข | ยังไม่ปล่อย |
| Kimi K3.1 Pro (Moonshot AI) | 2.8T / 104B | ยังไม่ประกาศ | ยังไม่มีไฟล์ · Kimi K3 ขนาดเท่ากันต้องใช้ 610GB ขึ้นไป (Unsloth, 1 บิต) | ยังไม่ปล่อย |
ReadEval ตัดสินคอลัมน์สุดท้ายอย่างไร: ใช้ตัวเลขหน่วยความจำที่ผู้พัฒนา คู่มือของ Unsloth (ผู้ทำไฟล์บีบอัดยอดนิยม) หรือขนาดไฟล์ใน Ollama ระบุ แล้วถือว่า "ได้" เมื่อตัวเลขต่ำกว่า 16GB มากพอให้เหลือที่ให้ระบบปฏิบัติการและเบราว์เซอร์ Unsloth ระบุเป็นหลักคร่าว ๆ ว่าหน่วยความจำทั้งหมดของเครื่องควรมากกว่าขนาดไฟล์ที่ดาวน์โหลด และข้อมูลนำเข้าที่ยาวขึ้นจะกินหน่วยความจำเพิ่ม ตัวเลขทั้งหมดตรวจเมื่อ 26 ต.ค. 2026
ขนาดไฟล์ไม่เท่ากับหน่วยความจำที่ต้องใช้: ตัวเลขที่เขียนว่า "ไฟล์" ในตารางคือขนาดดาวน์โหลด ส่วนตอนทำงานจริงต้องใช้มากกว่านั้น เช่น Unsloth ระบุว่า Super VL รุ่น 1 บิตมีไฟล์ 46.1GB แต่ควรมีหน่วยความจำอย่างน้อย 64GB ส่วนชื่อ "4GB" ของ Bolt E4B คือหน่วยความจำการ์ดจอที่ใช้ ไม่ใช่ขนาดไฟล์ ซึ่งจริง ๆ ใหญ่ 6.18GB
Mac กับ PC นับต่างกันนิดหน่อย: Mac ชิป Apple ใช้หน่วยความจำร่วม (unified memory) ก้อนเดียวทั้งหน่วยประมวลผลกลางและการ์ดจอในตัว จึงนับ 16GB ทั้งก้อน ส่วน PC ที่มีการ์ดจอแยก Unsloth แนะนำให้นับ RAM รวมกับหน่วยความจำการ์ดจอ ถ้าไม่มีการ์ดจอเลยก็รันด้วย RAM ล้วนได้ แต่ช้ากว่า
รุ่นเล็กที่คนทั่วไปลองได้จริง
Nemotron 3.5 Bolt E4B (NVIDIA): NVIDIA นำ Gemma 4 E4B ของ Google มาฝึกต่อ เน้นการคุยหลายรอบ ทำตามคำสั่ง และเรียกใช้เครื่องมือ สำหรับผู้ช่วยสั่งงานด้วยเสียงหรือผู้ช่วยในอุปกรณ์ model card ระบุขนาด 8B โดยคำนวณจริงเทียบเท่า 4B รับข้อความยาวได้ถึง 64K token เผยแพร่บน Hugging Face เมื่อ 23 ต.ค. 2026 หน้าบล็อกเทคนิคของ NVIDIA ระบุว่าใช้หน่วยความจำ "เพียงราว 4GB ในงานเป้าหมาย" และวัดการใช้จริงได้ 3.1–5.0GB บนการ์ดจอหลายรุ่น ทั้งนี้ตัวเลขผลทดสอบที่บอกว่าเก่งกว่า Gemma 4 E4B และ Qwen3.5 4B ในหลายชุดทดสอบเป็นของ NVIDIA เอง
LFM2.5-24B-A2B (Liquid AI): เปิดตัว 13 ต.ค. 2026 เป็นรุ่นใหญ่ที่สุดของตระกูล LFM2.5 ขนาด 24B แต่ใช้งานจริงเพียง 2.45B ต่อ token จึงตอบได้เร็ว Liquid AI อ้างว่าทำได้ 184 token ต่อวินาทีบน Apple M5 Max ปัญหาคือรุ่นมาตรฐานใน Ollama (lfm2.5:24b) มีขนาด 15GB ซึ่งเกือบเต็มโน้ตบุ๊ก 16GB คุณต้องเลือกไฟล์บีบอัดหนัก 2–3 บิตของ Unsloth (7.5–11GB) แทน ReadEval ยังไม่พบผลวัดว่ารุ่นบีบอัดหนักขนาดนี้คุณภาพลดลงเท่าไร Liquid AI เองแนะนำว่าโมเดลนี้ไม่เหมาะกับงานที่ต้องใช้ความรู้มาก ถ้าไม่ได้ต่อกับระบบค้นข้อมูลหรือค้นเว็บ
ถ้าเครื่องมี 24–32GB:
- Flint (Recursive): โมเดลช่วยเขียนโค้ดขนาด 39.8B ที่ ReadEval เคยอธิบายไว้ในข่าว Flint Unsloth ระบุว่ารุ่น 3 บิต (ไฟล์ 18.5GB) ใส่ในเครื่อง 24GB ได้เมื่อใช้ข้อมูลนำเข้าสั้น ๆ
- Nemotron 3.5 Bolt 74B-A9B (NVIDIA): ย่อมาจาก Super VL เหลือ 74B และบีบอัดเป็น 2 บิตตั้งแต่ตอนฝึก จนไฟล์เหลือราว 24GB รับทั้งข้อความ ภาพ และวิดีโอ The New Stack รายงานว่า NVIDIA ปรับให้ทำงานบนเครื่อง RTX Spark และ DGX Spark Unsloth แนะนำให้เตรียมหน่วยความจำราว 32GB และถ้ามี 48–64GB จะเหลือพื้นที่สบายกว่า
ข้อควรระวังใน Ollama: ถ้าสั่ง ollama run nemotron-3.5-bolt เฉย ๆ โดยไม่ใส่ :e4b ระบบจะดาวน์โหลดรุ่น 74B ขนาด 25GB ซึ่งเป็นค่าเริ่มต้น ส่วน ollama run lfm2.5 เฉย ๆ จะได้รุ่น 8B ที่ออกเมื่อหลายเดือนก่อน ไม่ใช่รุ่น 24B ตัวใหม่
นอกจากนี้ยังมีโมเดลเล็กเฉพาะทางอีกหลายตัวที่ออกในเดือนนี้ เช่น Nemotron Labs Dory 1.0 ขนาด 4B ของ NVIDIA (16 ต.ค.) ซึ่งเป็นโมเดลทดลองที่รองรับภาษาอังกฤษเท่านั้น ReadEval ไม่ได้ใส่ไว้ในตารางเพราะเป็นงานทดลองมากกว่าโมเดลสำหรับใช้งานทั่วไป
รุ่นใหญ่: โหลดได้ แต่เหมาะกับองค์กร
- Reflection Beam 1.0: โมเดลแบบเปิดตัวแรกของ Reflection AI ปล่อยไฟล์เมื่อ 16 ต.ค. 2026 ภายใต้ Apache 2.0 ขนาด 501B ใช้งานจริง 23B รับข้อมูลนำเข้าได้ 1 ล้าน token จุดขายคือคิดด้วย token น้อยกว่าโมเดลเปิดชั้นนำราว 3 เท่าตามที่บริษัทอ้าง VentureBeat รายงานว่า Artificial Analysis ซึ่งเป็นผู้วัดอิสระให้ความเห็นเบื้องต้นว่า Beam อยู่ในกลุ่มที่ประหยัด token ที่สุดในระดับความเก่งเดียวกัน model card ระบุว่าพัฒนาสำหรับภาษาอังกฤษเป็นหลัก ส่วนการรันเอง Reflection บอก VentureBeat ว่ารุ่น 8 และ 4 บิตใส่ได้ในเซิร์ฟเวอร์ GPU 8 ใบเครื่องเดียว และรุ่นเต็มต้องใช้ GPU "หลายสิบใบ"
- MiniMax M3.1 Flash: เปิดตัว 19 ต.ค. 2026 โดยบอกว่าจะปล่อยไฟล์ "ภายหลัง" แล้วอัปโหลดขึ้น Hugging Face เมื่อ 23 ต.ค. ขนาดราว 428B ใช้งานจริง 23B รับข้อความ ภาพ และวิดีโอ เน้นงานเอเจนต์ เขียนโค้ด และงานความปลอดภัยไซเบอร์ ไฟล์บีบอัดเล็กที่สุดของ Unsloth ยังใหญ่ 129GB
- Nemotron 3.5 Super VL (NVIDIA): ปล่อย 15 ต.ค. 2026 ขนาด 120B ใช้งานจริง 12B รับข้อความ ภาพ และวิดีโอ ออกแบบมาสำหรับงานอ่านเอกสารและงานเอเจนต์ model card ระบุว่ารุ่น NVFP4 รันได้บน DGX Spark 1 เครื่องหรือ H200 1 ใบ
- DeepSeek V4.1 Flash 1017: ไฟล์ราว 510GB ต้องใช้หน่วยความจำ 128GB ขึ้นไป แต่ลองผ่านแอปและเว็บ DeepSeek ได้ฟรี รายละเอียดอยู่ในข่าว DeepSeek V4.1 Flash 1017
- Muse Spark Open (Meta): ขนาด 816B ต้องใช้หน่วยความจำระดับหลายร้อย GB ขึ้นไป และสัญญามีเงื่อนไขเฉพาะของ Meta รายละเอียดอยู่ในข่าว Muse Spark Open
ยังไม่ปล่อยไฟล์: Mistral Large 4 และ Kimi K3.1 Pro
Mistral Large 4: Mistral AI เปิดตัวเมื่อ 6 ต.ค. 2026 แบบ public preview ผ่าน API ใน Mistral Studio และเขียนในประกาศว่า "เราจะปล่อยไฟล์น้ำหนักภายในสิ้นเดือน" เมื่อ ReadEval ตรวจเมื่อ 26 ต.ค. ยังไม่มีไฟล์ให้ดาวน์โหลด มีเพียงหน้า "Upcoming release" บน Hugging Face ที่ระบุกำหนดคาดการณ์ 31 ต.ค. 2026 หน้าเดียวกันอธิบายว่าเป็นโมเดลหลายรูปแบบ (multimodal) ขนาดราว 1 ล้านล้านพารามิเตอร์ ใช้งานจริง 49B ต่อ token หรือ 52B ถ้านับชั้น embedding และชั้นผลลัพธ์ด้วย Mistral ยังไม่ประกาศสเปกเครื่องที่ต้องใช้ ส่วนสัญญาอนุญาต Lindy รายงานว่าเอกสารของ Mistral ระบุว่า "coming soon" (Mistral Large 3 รุ่นก่อนใช้ Apache 2.0 แต่ไม่ได้แปลว่ารุ่นนี้จะใช้แบบเดียวกัน) ReadEval ประเมินว่าด้วยขนาดที่ใหญ่กว่า Muse Spark Open ซึ่งรุ่นบีบอัดเล็กสุดยังต้องใช้ 180GB ขึ้นไป Mistral Large 4 ก็ไม่น่าจะรันบนเครื่องส่วนตัวทั่วไปได้เช่นกัน
Kimi K3.1 Pro: Moonshot AI เปิดตัวเมื่อ 23 ต.ค. 2026 ใช้ได้แล้วบน Kimi.ai แอปมือถือ Kimi Work Kimi Code และ API บล็อกของ Moonshot ระบุว่า "จะปล่อยไฟล์น้ำหนักทั้งหมดภายใน 4 พ.ย. 2026" แต่ยังไม่ระบุสัญญาอนุญาต (Kimi K3 รุ่นก่อนใช้สัญญาเฉพาะที่กำหนดให้ผู้ขายโมเดลเป็นบริการซึ่งมีรายได้เกิน 20 ล้านดอลลาร์ใน 12 เดือนต้องทำสัญญาแยก) ส่วนความเก่ง Artificial Analysis ให้คะแนน 55 บนดัชนีรวม อยู่อันดับ 4 รองจาก Claude Opus 5.5, Claude Sonnet 5.5 และ Muse Wonder Full ตามที่ The Decoder รายงาน ขณะที่ตัวเลข 65.7% บน Terminal-Bench 4.0 เป็นผลที่ Moonshot วัดเอง
ถ้าอยากลองตอนนี้ Notebookcheck รายงานว่าหน้าราคาของ Kimi ระบุให้แพ็กเกจฟรีใช้ K3.1 Pro ได้แบบ "จำกัดการใช้งาน" บนเว็บและ Kimi Work แต่ไม่ได้บอกว่าจำกัดเท่าไร ส่วนรุ่น Highspeed ที่เร็วกว่า 2–3 เท่าต้องใช้แพ็กเกจ Pro ขึ้นไป ReadEval ยังไม่ได้ยืนยันว่าแพ็กเกจฟรีใช้ได้ในไทยหรือไม่
ภาษาไทยใช้ได้ไหม
ยังไม่มีตัวไหนในกลุ่มนี้ที่มีผลทดสอบภาษาไทยจากผู้พัฒนาหรือผู้วัดอิสระ สิ่งที่ model card บอกไว้มีดังนี้
- LFM2.5-24B-A2B: ระบุภาษาไทยเป็น 1 ใน 16 ภาษาที่รองรับ
- Nemotron 3.5 Bolt E4B: ป้ายภาษาบน Hugging Face มีภาษาไทยอยู่ด้วย และบล็อกของ NVIDIA บอกว่ารองรับ 35 ภาษา แต่ข้อมูลฝึกรอบหลังเน้น 7 ภาษาหลักซึ่งไม่มีภาษาไทย
- Nemotron 3.5 Bolt 74B: ระบุภาษาอังกฤษเป็นหลัก พร้อมสเปน ฝรั่งเศส เยอรมัน อิตาลี และญี่ปุ่น ไม่มีภาษาไทย
- Beam 1.0: model card ระบุว่าพัฒนาสำหรับภาษาอังกฤษเป็นหลัก
- Flint: เป็นโมเดลสำหรับเขียนโค้ด model card ไม่ได้ระบุภาษา
ทางที่ดีที่สุดคือลองถามด้วยงานภาษาไทยที่คุณใช้จริงก่อนตัดสินใจ
ใช้ทำธุรกิจได้ไหม
- ใช้ได้ค่อนข้างอิสระ: Apache 2.0 (Flint, Beam), MIT (DeepSeek) และ OpenMDW-1.1 (ตระกูล Nemotron 3.5) ซึ่งตัวบทให้ใช้ แก้ไข และเผยแพร่ได้โดยไม่จำกัด ขอเพียงแนบสัญญาและประกาศลิขสิทธิ์ไปด้วยเมื่อแจกจ่ายต่อ ทั้งนี้ Bolt E4B ฝึกต่อจาก Gemma 4 ซึ่ง NVIDIA ระบุว่าส่วนนั้นอยู่ภายใต้ Apache 2.0
- LFM Open License v1.0 (LFM2.5): ใช้เชิงพาณิชย์ได้เฉพาะองค์กรที่มีรายได้ต่อปีต่ำกว่า 10 ล้านดอลลาร์ ใช้ส่วนตัวหรือทำวิจัยได้
- MiniMax Community License: ให้สิทธิ์ใช้แบบไม่แสวงกำไร ถ้าใช้เชิงพาณิชย์ต้องแสดงข้อความ "Built with MiniMax M3.1-Flash" และแจ้ง MiniMax ทางอีเมลหนึ่งครั้ง ถ้าผลิตภัณฑ์มีรายได้เกิน 20 ล้านดอลลาร์ต่อปีต้องขออนุญาตเป็นลายลักษณ์อักษรก่อน
- Muse Model License: ดูรายละเอียดในข่าว Muse Spark Open
ReadEval สรุปจากตัวบทภาษาอังกฤษ ไม่ใช่คำแนะนำทางกฎหมาย บริษัทที่จะนำไปใช้จริงควรให้ฝ่ายกฎหมายอ่านฉบับเต็ม
เช็กเครื่องและลองรันอย่างไร
1. ดูว่าเครื่องมีหน่วยความจำเท่าไร
- Windows 11: กด Windows+I เปิด Settings เลือก System แล้วเลือก About ดูบรรทัด Installed RAM
- Mac: คลิกเมนู Apple แล้วเลือก About This Mac ดูบรรทัด Memory
2. ติดตั้งโปรแกรมรันโมเดล เลือกอย่างใดอย่างหนึ่ง และดาวน์โหลดจากเว็บทางการเท่านั้น เพราะช่วงนี้มีแอป AI ปลอมที่แฝงมัลแวร์ขโมยบัญชี (อ่านเพิ่มในข่าวแอป AI ปลอม)
- Ollama จาก ollama.com มีทั้ง Windows, macOS และ Linux
- LM Studio จาก lmstudio.ai ซึ่งบัญชี lmstudio-community บน Hugging Face มีไฟล์ Bolt E4B ให้แล้ว
- Unsloth Desktop จาก unsloth.ai ค้นหาโมเดลในแอปแล้วกดดาวน์โหลดได้
3. รันรุ่นเล็กด้วย Ollama เปิด Terminal (Mac) หรือ PowerShell (Windows) แล้วพิมพ์
ollama run nemotron-3.5-bolt:e4bไฟล์ราว 7–8GB จะดาวน์โหลดครั้งแรกครั้งเดียว จากนั้นพิมพ์คุยได้ทันที ถ้าเครื่องมี 24GB ขึ้นไปจะลอง ollama run flint ก็ได้
4. เช็กว่าโมเดลใช้การ์ดจอหรือไม่ เปิดหน้าต่างใหม่แล้วพิมพ์
ollama psคอลัมน์ PROCESSOR บอกว่าโมเดลอยู่ที่ไหน ตามคำอธิบายในหน้า FAQ ของ Ollama "100% GPU" คืออยู่บนการ์ดจอทั้งหมด "100% CPU" คืออยู่ใน RAM ทั้งหมด ซึ่งจะตอบช้ากว่า
ระวังป้าย cloud: ในคลังโมเดลของ Ollama รุ่นอย่าง beam:cloud, minimax-m3.1-flash:cloud, mistral-large-4:cloud และ deepseek-v4.1-flash:1017-cloud ไม่ได้ทำงานในเครื่องคุณ เอกสารของ Ollama ระบุว่าโมเดลแบบ cloud ทำงานบนคลาวด์ของ Ollama ไม่ต้องดาวน์โหลด และต้องล็อกอิน ข้อความที่พิมพ์จึงถูกส่งออกไปประมวลผลภายนอก และใช้เครดิตการใช้งานตามแพ็กเกจของ Ollama
ไม่อยากรันเอง ลองที่ไหนได้
| โมเดล | ช่องทางที่ง่ายที่สุด |
|---|---|
| Kimi K3.1 Pro | Kimi.ai และแอป Kimi (แพ็กเกจฟรีจำกัดการใช้งาน ตามที่ Notebookcheck รายงาน) |
| DeepSeek V4.1 Flash 1017 | chat.deepseek.com และแอป DeepSeek |
| Flint, Nemotron 3.5 Super VL | OpenRouter มีรุ่นที่ไม่คิดเงิน (ต้องสมัครบัญชี) |
| Beam 1.0, MiniMax M3.1 Flash, Muse Spark Open, Mistral Large 4 | API แบบจ่ายตามการใช้งานผ่าน OpenRouter หรือ API ของแต่ละบริษัท |
| LFM2.5-24B-A2B | Liquid Playground บนเว็บของ Liquid AI |
สิ่งที่แหล่งข้อมูลรายงานไม่ตรงกัน
- ขนาดของ Kimi K3.1 Pro: The Decoder ระบุ 2.8T ใช้งานจริง 104B ส่วนบล็อกของ Moonshot เรียกว่าเป็นโมเดล "ระดับ 3T" โดยไม่ระบุตัวเลขแน่ชัด ReadEval ใช้ 2.8T ซึ่งตรงกับขนาดของ Kimi K3 ที่ K3.1 Pro ฝึกต่อมา
- พารามิเตอร์ที่ใช้งานจริงของ Mistral Large 4: ประกาศของ Mistral เขียน 52B ส่วนหน้า Hugging Face แยกว่าเป็น 49B และ 52B เมื่อรวมชั้น embedding กับชั้นผลลัพธ์ ขนาดรวมมีทั้ง 1T (Mistral) และ 1.05T (หน้าโมเดลใน Ollama)
- วันปล่อยไฟล์ Mistral Large 4: ประกาศของ Mistral บอกแค่ "สิ้นเดือน" หน้า Hugging Face ระบุ 31 ต.ค. ส่วน Lindy รายงานว่ามีบางสื่อระบุวันที่ 27 ต.ค. แต่วันที่นั้นไม่ปรากฏในหน้าใดของ Mistral ReadEval จึงยึด 31 ต.ค. ตามหน้า Hugging Face
- "4GB" ของ Bolt E4B: NVIDIA ใช้ตัวเลขนี้ในชื่อรุ่น แต่ไฟล์บน Hugging Face ใหญ่ 6.18GB และรุ่นใน Ollama ใหญ่ 7.2–7.9GB Unsloth อธิบายว่า 4GB คือหน่วยความจำการ์ดจอที่ใช้ ไม่ใช่ขนาดไฟล์หรือ RAM ทั้งหมด นอกจากนี้ model card ระบุว่ารับข้อความเท่านั้นและรับข้อมูลนำเข้าได้ 64K token แต่รุ่นใน Ollama ระบุว่ารับภาพได้และรองรับ 128K token
- ขนาดของ Bolt 74B: NVIDIA เรียกว่า 24GB แต่สื่อหลายแห่งชี้ว่าตัวเลขนี้คือน้ำหนักโมเดลเท่านั้น ต้องเผื่อหน่วยความจำสำหรับข้อความที่ใช้คุยเพิ่ม ซึ่งสอดคล้องกับที่ Unsloth แนะนำ 24–32GB
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
เดือนตุลาคมมีโมเดลแบบเปิดมากเป็นพิเศษ แต่สำหรับคนที่มีโน้ตบุ๊กธรรมดา ตัวที่ลองที่บ้านได้จริงคือรุ่นเล็ก ไม่ใช่ตัวที่ขึ้นหัวข่าว คำว่า open-weight บอกเพียงว่าไฟล์เปิดให้โหลด ไม่ได้บอกว่าเครื่องแบบไหนรับไหว และโมเดลที่ถูกพูดถึงมากที่สุดในเดือนนี้ล้วนต้องใช้หน่วยความจำระดับเวิร์กสเตชันหรือเซิร์ฟเวอร์ ประโยชน์ของการเปิดไฟล์จึงตกกับบริษัทที่อยากเก็บข้อมูลไว้ในระบบของตัวเองมากกว่าผู้ใช้ทั่วไป ข่าวดีคือฝั่งรุ่นเล็กขยับมาเอาใจเครื่องส่วนตัวชัดขึ้น ทั้ง NVIDIA ที่ออกแบบ Bolt ให้พอดีกับหน่วยความจำ 4GB และ 24GB ตั้งแต่ต้น และ Liquid AI ที่ใส่ภาษาไทยไว้ในรายการภาษาที่รองรับ ReadEval แนะนำให้เริ่มจาก Bolt E4B ถ้าเครื่องมี 16GB ทดสอบกับงานจริงของคุณ โดยเฉพาะภาษาไทยซึ่งยังไม่มีใครวัดผลให้ และอย่าคาดหวังความเก่งระดับเดียวกับแชตบอตบนคลาวด์ ส่วนใครรอ Mistral Large 4 หรือ Kimi K3.1 Pro ควรรู้ไว้ก่อนว่าต่อให้ปล่อยไฟล์ตามกำหนด ทั้งสองตัวก็เป็นโมเดลสำหรับเซิร์ฟเวอร์ ช่องทางที่สมเหตุสมผลสำหรับคนทั่วไปคือเว็บหรือแอปของบริษัทเหมือนเดิม
แหล่งที่มา
- VentureBeat: Reflection's Beam aims to undercut Chinese open models with fewer tokens
- Model card ของ Reflection Beam 1.0 (Hugging Face)
- Reflection AI: Introducing Beam
- Mistral AI: Mistral Large 4
- Hugging Face: Mistral-Large-4 (Upcoming release)
- Lindy: What Is Mistral Large 4? Benchmarks, Pricing, and Weights
- The Decoder: Kimi K3.1 Pro is closing in on Claude Opus 5.5
- Moonshot AI: Kimi K3.1 Pro
- The Next Web: Moonshot releases Kimi K3.1 Pro
- Notebookcheck: Kimi K3.1 Pro free to try
- Unite.AI: Moonshot opens Kimi K3 weights under a revenue-tiered license
- Unsloth: Kimi K3 - How to Run Locally
- Model card ของ Nemotron 3.5 Bolt E4B 4GB (Hugging Face)
- NVIDIA Research: Nemotron 3.5 Bolt E4B 4GB technical blog
- Model card ของ Nemotron 3.5 Bolt 74B-A9B 24GB (Hugging Face)
- Model card ของ Nemotron 3.5 Super VL (Hugging Face)
- The New Stack: Nvidia squeezed a 74B agent model into 24GB so it can run on your laptop
- Unsloth: NVIDIA Nemotron 3.5 Bolt - Run Locally Guide
- Unsloth: NVIDIA Nemotron 3.5 Super VL - Run Locally Guide
- Model card ของ Nemotron Labs Dory 1.0 4B (Hugging Face)
- Model card และ LFM Open License v1.0 ของ LFM2.5-24B-A2B (Hugging Face)
- Liquid AI: LFM2.5-24B-A2B
- Unsloth: LFM2.5-24B-A2B GGUF (ขนาดไฟล์)
- Unsloth: Flint - Run Locally Guide
- Model card ของ Recursive Flint (Hugging Face)
- MiniMax: M3.1 Flash
- Model card และ MiniMax Community License ของ M3.1 Flash (Hugging Face)
- Unsloth: MiniMax M3.1 Flash GGUF (ขนาดไฟล์)
- Unsloth: Beam 1.0 GGUF (ขนาดไฟล์)
- Unsloth: Meta Muse Spark Open - Run Locally Guide
- Unsloth: DeepSeek-V4.1-Flash-1017 GGUF guide
- OpenMDW License Agreement 1.1
- Ollama: nemotron-3.5-bolt tags
- Ollama: lfm2.5 tags
- Ollama: flint tags
- Ollama: nemotron-3.5-super tags
- Ollama: beam (cloud)
- Ollama: minimax-m3.1-flash (cloud)
- Ollama: mistral-large-4 (cloud)
- Ollama Docs: Cloud
- Ollama Docs: FAQ (ollama ps)
- Ollama: Pricing
- OpenRouter Models API (รายการโมเดลและรุ่นที่ไม่คิดเงิน)
- How-To Geek: How to check your RAM on Windows 11
- Apple Mac Help: About settings (ดูหน่วยความจำของ Mac)