OpenAI อ้างว่า AI แก้โจทย์คณิตศาสตร์ค้างคาหลายร้อยข้อ คอมพิวเตอร์ตรวจแล้วไม่ถึงครึ่ง
OpenAI ปล่อยต้นฉบับคณิตศาสตร์ที่ AI เขียน 719 ฉบับ รวมคำอ้างว่าพิสูจน์ Unique Games ได้ เครื่องตรวจด้วย Lean ราว 42% ถอนแล้ว 3 ฉบับ และยังไม่มี peer review
สารบัญ (10 หัวข้อ)
Dana Moshkovitz นักวิทยาการคอมพิวเตอร์ทฤษฎี พยายามพิสูจน์โจทย์ชื่อ Unique Games Conjecture มาตลอดเวลาที่ Scott Aaronson สามีของเธอรู้จักเธอ ต้นเดือนตุลาคม OpenAI โพสต์ไฟล์ที่ AI เขียนและอ้างว่าพิสูจน์โจทย์ข้อนี้ได้แล้ว ปฏิกิริยาแรกของเธอคือ "เขียนแย่จนอ่านไม่ได้ถ้าไม่มี AI ช่วย"
ไฟล์นั้นเป็นเพียงหนึ่งในต้นฉบับงานคณิตศาสตร์กว่า 700 ฉบับที่ OpenAI ปล่อยพร้อมกันบน GitHub จากโมเดลภายในที่ยังไม่เปิดให้ใครใช้ หลายชิ้นอ้างว่าไขโจทย์ที่ค้างคามาหลายสิบปี โฆษกบอกว่าเกือบทุกชิ้นได้จากการสั่งงานครั้งเดียว แต่ยอมรับว่านักคณิตศาสตร์ของ OpenAI ยังไม่เข้าใจอีกหลายชิ้น วันรุ่งขึ้น Aaronson เขียนในบล็อกว่า ดูเหมือนยังไม่มีมนุษย์คนไหนเข้าใจบทพิสูจน์เกือบทั้งหมดนี้เลย
แล้วทำไม OpenAI กล้าปล่อยออกมา คำตอบคือผลหลักราว 42% มีบทพิสูจน์ที่แปลเป็นภาษา Lean ซึ่งคอมพิวเตอร์ไล่ตรวจได้ทุกขั้น รวมถึง Unique Games นึกถึงระบบตรวจการบ้านอัตโนมัติที่ไล่ดูวิธีทำทุกบรรทัดว่าไม่มีขั้นไหนผิด ต่างกันตรงที่มันไม่ได้อธิบายว่าทำไมวิธีนั้นได้ผล และถ้าลอกโจทย์มาผิดตั้งแต่ต้น เครื่องก็ยังให้ผ่าน จึงต้องมีคนดูว่าโจทย์ในภาษา Lean ตรงกับปัญหาจริง
ส่วนที่เหลือเกินครึ่งยังไม่มีเครื่องตรวจ OpenAI เขียนไว้เองว่าอาจมีปัญหา และแค่วันถัดมาก็ถอนออก 3 ฉบับ เพราะการตรวจภายในพบเครื่องหมายบวกลบผิดจุดเดียวที่ลามไปสามงาน วงการคณิตศาสตร์จึงแตกเป็นสองฝ่าย ฝ่ายหนึ่งตื่นเต้นและรีบลงมืออ่าน อีกฝ่ายมองว่าเป็นการแสดงอำนาจ ถึงขั้นมีกลุ่มเรียกร้องให้เลิกร่วมงานกับ OpenAI ส่วนคณะที่ปรึกษาที่ OpenAI ร่วมตั้งก็ขอให้เปิดคำสั่ง (prompt) ที่ใช้ ซึ่งบริษัทยังไม่ทำ
ข่าวดีคือการตรวจของมนุษย์เริ่มเดินหน้า ไม่กี่วันต่อมา Aaronson เล่าว่า Moshkovitz เข้าใจบทพิสูจน์ส่วนใหญ่แล้วและทึ่งกับแนวคิดใหม่ในนั้น คนทั่วไปไม่ต้องทำอะไร เพราะโมเดลยังไม่เปิดให้ใช้ แต่ครั้งหน้าที่คุณเห็นข่าว "AI พิสูจน์ได้แล้ว" ลองถามสามข้อ เครื่องตรวจหรือยัง คนนอกบริษัทอ่านแล้วหรือยัง และมีการถอนหรือแก้ไหม ผลงานเด่น ตัวเลขที่ไม่ตรงกัน และคะแนนความน่าเชื่อถืออยู่ด้านล่าง
สรุปประเด็นสำคัญ
- ปล่อยครั้งเดียวหลายร้อยชิ้น: วันที่ 6 ต.ค. 2026 OpenAI เปิดคลัง GitHub
openai/mathพร้อมต้นฉบับ 722 ฉบับ ถอนไป 3 ฉบับในวันรุ่งขึ้น จึงเหลือ 719 ฉบับใน 372 กลุ่มผลงาน (family) จากโมเดลภายในที่ไม่เปิดเผยชื่อ - เครื่องตรวจได้ไม่ถึงครึ่ง: OpenAI นับว่าผลหลัก 300 จาก 719 หรือราว 42% มีบทพิสูจน์ในภาษา Lean รวมถึง Unique Games Conjecture ส่วนที่เหลือบริษัทเตือนเองว่า "อาจมีปัญหา"
- ยังไม่มีมนุษย์นอกบริษัทตรวจครบ: ไม่มีฉบับใดผ่านการตรวจโดยผู้ทรงคุณวุฒิ (peer review) ผล quasi-Riemann เริ่มมีผู้เชี่ยวชาญเห็นพ้องว่าถูก ส่วน Unique Games ยังไม่พบการยืนยันอิสระที่เผยแพร่
- วงการแตกเป็นสองฝ่าย: บางคนเรียกว่าระดับเหรียญฟิลด์ส บางกลุ่มเรียกร้องให้เลิกร่วมงานกับ OpenAI และคณะที่ปรึกษาระบุว่า OpenAI ทำตามคำแนะนำไม่ครบ
OpenAI ปล่อยอะไรออกมา
OpenAI ประกาศผ่านโพสต์ "Sharing AI progress in mathematics" เมื่อเย็นวันที่ 6 ต.ค. 2026 ตามเวลาฝั่งตะวันออกของสหรัฐฯ (ReadEval เปิดหน้าโพสต์ของ OpenAI โดยตรงไม่ได้ จึงใช้ข้อมูลจากคลัง GitHub ของบริษัทเป็นหลัก และใช้รายงานของสื่อสำหรับส่วนที่อยู่ในโพสต์) README ของคลังระบุว่า
- ผลงานเกือบทั้งหมดได้จากขั้นตอนเดียวกัน ด้วย "โมเดลภายในที่ยังไม่เปิดตัว" ของ OpenAI
- แต่ละผลใช้พลังประมวลผลเฉลี่ยเทียบเท่า "การคิดของ ChatGPT Pro ราว 3 ชั่วโมง"
- ตลอดการทดสอบ โมเดลได้รับโจทย์ราว 4,000 ข้อ แล้ว OpenAI คัดเฉพาะผลที่ "มีความสำคัญพอ" มารวมเป็นคลังนี้ Aaronson ประเมินว่าเท่ากับโมเดลแก้ได้ราว 10% ของโจทย์ที่ได้รับ เมื่อให้ลองข้อละราว 3 ชั่วโมงครั้งเดียว
- มีข้อยกเว้นสองงานที่ไม่ได้ทำตามขั้นตอนปกติ คืองาน zero-free region ของฟังก์ชันซีตาของรีมันน์ และ Hodge conjecture สำหรับ CM abelian varieties และงานฉบับ 11/12 ของกลุ่ม quasi-Riemann เป็นฉบับเดียวที่มีคนแก้สำนวนให้อ่านง่ายขึ้น
- OpenAI เปิดสรุปขั้นตอนการคิดของโมเดลแบบย่อเพียง 10 กลุ่มผลงาน ไม่เปิดคำสั่งที่ใช้ และไม่บอกชื่อโมเดล
Sam Altman ซีอีโอ OpenAI เลือกผลงาน 4 ชิ้นว่าใหญ่ที่สุด และ OfficeChai รายงานว่าเขาบอกเองว่านักคณิตศาสตร์ภายนอกยังไม่ได้ยืนยันผลเหล่านี้
| ผลงานที่ OpenAI อ้าง | พูดง่าย ๆ | มีบทพิสูจน์ Lean ไหม |
|---|---|---|
| Unique Games Conjecture (กลุ่ม 102) | โจทย์ที่ Subhash Khot ตั้งไว้ในปี 2002 ถ้าจริง แปลว่าวิธีประมาณคำตอบที่ดีที่สุดที่รู้กันอยู่สำหรับปัญหาอย่าง Max-Cut และ Vertex Cover ไม่มีทางทำให้ดีกว่านี้ได้ในเวลาที่สมเหตุสมผล (ถ้า P ≠ NP) | มี |
| quasi-Riemann hypothesis (กลุ่ม 003) | ไม่ใช่สมมติฐานของรีมันน์ฉบับเต็ม แต่บีบแถบที่ศูนย์ของฟังก์ชันซีตาอยู่ให้แคบลง ซึ่ง Maksym Radziwiłł จาก NYU บอก Quanta ว่าผลที่ตามมาส่วนใหญ่ของสมมติฐานรีมันน์ได้จากผลนี้แล้ว | มี (ฉบับ 7/8) |
| Hodge conjecture สำหรับ CM abelian varieties (กลุ่ม 032) | กรณีพิเศษของโจทย์รางวัลแห่งสหัสวรรษ ไม่ใช่ฉบับเต็ม | ไม่มี |
| free group factors (กลุ่ม 287) | Altman บอกว่าค้างมาตั้งแต่ทศวรรษ 1940 อ้างว่าพีชคณิตที่สร้างจากกลุ่มอิสระ (free group) ไม่ว่าจะมีตัวก่อกำเนิดกี่ตัว (ตั้งแต่ 2 ตัวขึ้นไป) มีโครงสร้างเหมือนกันหมด | มี |
ที่มา: คลัง openai/math (CONTENTS.md และ README), OfficeChai, Quanta Magazine
นอกจากสี่ชิ้นนี้ Aaronson เขียนว่าบางชิ้นเป็นระดับ "ผลงานแห่งปี" ในสาขาของตัวเอง และยกตัวอย่าง เช่น การคูณจำนวนเต็มที่เร็วกว่าขีดจำกัดที่ยืนมาตั้งแต่ทศวรรษ 1960 และ L = BPL ที่บอกว่าความสุ่มไม่ช่วยให้คอมพิวเตอร์ที่มีหน่วยความจำน้อยทำงานได้มากขึ้น
"เครื่องตรวจแล้ว" ต่างจาก "มนุษย์เข้าใจแล้ว" อย่างไร
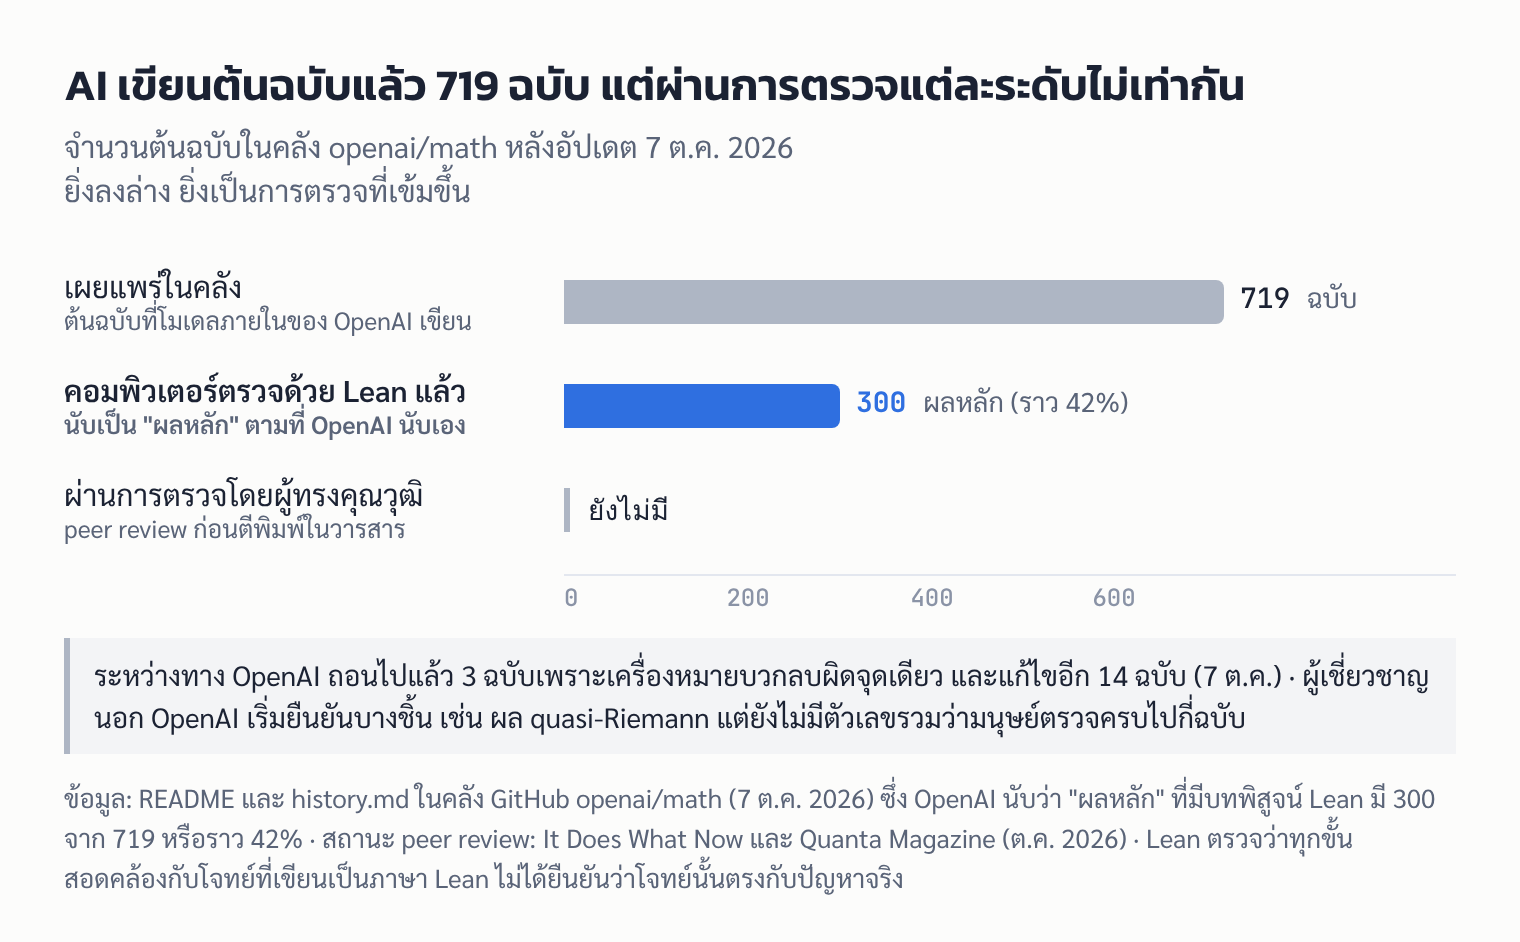
Lean เป็นภาษาโปรแกรมที่ให้คอมพิวเตอร์ตรวจบทพิสูจน์ทีละขั้น ถ้ามีขั้นใดไม่ตามมาจากขั้นก่อนหน้า เครื่องจะไม่ยอมให้ผ่าน จึงเป็นหลักฐานที่แข็งแรงกว่าการที่บริษัทบอกเฉย ๆ ว่าพิสูจน์ได้ Aaronson เขียนในคอมเมนต์ว่าเขาตัดความเป็นไปได้ที่จะมีช่องโหว่ใน Lean ทิ้งแบบเด็ดขาดไม่ได้ แต่มองว่า "โอกาสต่ำมาก"
แต่ Lean มีข้อจำกัดสองข้อที่ทำให้นักคณิตศาสตร์ยังไม่พอใจ
- ตรวจตามโจทย์ที่เขียนให้มันอ่าน: ถ้าการแปลโจทย์เป็นภาษา Lean คลาดจากปัญหาจริง บทพิสูจน์ก็ผ่านได้ทั้งที่ไม่ได้ตอบคำถามที่ตั้งใจ Alexander Bastounis, Fabian Circelli และ Anders C. Hansen โพสต์งานบน arXiv วันที่ 6 ต.ค. 2026 ยกตัวอย่างว่าบทพิสูจน์ Lean ของงาน Navier–Stokes ที่ OpenAI ประกาศเมื่อเดือนกันยายน "ไม่ตรง" กับบทพิสูจน์ที่เขียนเป็นภาษามนุษย์ TechCrunch ระบุว่าผู้เขียนมาจาก University of Cambridge และ King's College London และสรุปว่าความคลาดเคลื่อนนี้ยังไม่ได้แปลว่าคำตอบผิด
- ผ่านแล้วก็ยังไม่มีใครเข้าใจ: Henry Yuen นักทฤษฎีสารสนเทศควอนตัม เขียนถึงบทพิสูจน์จาก AI อีกชิ้นของ OpenAI ตั้งแต่เดือนสิงหาคมว่า "ใช่ มีบทพิสูจน์ Lean แต่มันไม่ได้ทำให้ผมเข้าใจอะไรเลย" Melanie Wood ศาสตราจารย์คณิตศาสตร์ Harvard และหนึ่งในคณะที่ปรึกษา บอก TechCrunch ว่าตอนปล่อยยัง "ไม่มีความเข้าใจของมนุษย์" ในผลเหล่านี้ และ "งานเพิ่งเริ่มต้น"
ความเข้าใจสำคัญเพราะนักคณิตศาสตร์ไม่ได้ต้องการแค่คำตอบว่าจริงหรือเท็จ แนวคิดในบทพิสูจน์คือสิ่งที่นำไปต่อยอดงานอื่นได้ Mark Braverman จาก Princeton บอก Quanta ว่า "คณิตศาสตร์ผ่านข่าวประชาสัมพันธ์ไม่ดีต่อวงการนัก" แต่ก็ยอมรับว่าบทพิสูจน์จาก AI ยังเปิดทางวิจัยใหม่ได้
อะไรถูกถอนและแก้ไปแล้ว
ไฟล์ history.md ในคลังบันทึกการอัปเดตเมื่อ 7 ต.ค. 2026 ไว้ดังนี้
| สิ่งที่เปลี่ยน | รายละเอียด |
|---|---|
| ถอน 3 ฉบับ | เครื่องหมายผิดใน "Algebraicity of Weil classes on split abelian eightfolds" ทำให้ข้อโต้แย้งหลักใช้ไม่ได้ และลามไปถึงอีกสองฉบับที่ใช้ผลนี้ ได้แก่ "Algebraicity of Kuga–Satake Correspondences for K3 Surfaces" และ "The rational Hodge conjecture for products of K3 surfaces" |
| แก้ไข 14 ฉบับ | ซ่อมบทพิสูจน์ แก้ข้อความทฤษฎีบท ระบุเงื่อนไขให้ชัดขึ้น และแก้การอ้างอิงที่ล้าสมัย 1 จุด |
| อัปเดตการอ้างอิง 13 ฉบับ | ให้อ้างถึงฉบับแก้ไขของงานที่เกี่ยวข้อง |
| เพิ่มบทพิสูจน์ Lean | เพิ่ม 6 ชิ้น รวมเป็นผลหลัก 300 จาก 719 หรือราว 42% |
โฆษก OpenAI บอก Retraction Watch ว่าบริษัทพบข้อผิดพลาดเองระหว่างการตรวจสอบภายใน และ "ถ้าพบข้อผิดพลาด เราจะรีบแก้ และถอนงานถ้าหาทางแก้ไม่ได้" ทั้งสามฉบับที่ถอนอยู่ในกลุ่มงาน Hodge conjecture แต่ไม่ใช่ผล Hodge สำหรับ CM abelian varieties ที่ Altman ยกเป็นผลงานเด่น (ผลนั้นยังอยู่ในคลัง และยังไม่มีบทพิสูจน์ Lean)
Alex Townsend รองศาสตราจารย์คณิตศาสตร์ Cornell บอก Retraction Watch ว่าไม่แปลกใจที่ข้อผิดพลาดเดียวลามไปสามฉบับ และคาดว่าจะพบอีก เขาเห็นว่า "OpenAI ควรประกาศเฉพาะต้นฉบับที่ตรวจด้วย Lean แล้วก่อน" ส่วน Andrew Sutherland จาก MIT เรียกการถอนว่า "เป็นสิ่งที่รับผิดชอบ" แต่บอกว่านักคณิตศาสตร์หลายคน "ไม่พอใจกับพฤติกรรมของ OpenAI ที่ผ่านมา" Aaronson เองเขียนในคอมเมนต์ว่า "นี่จะไม่ใช่ครั้งสุดท้ายที่ต้องถอน เหมือนกับเปเปอร์ของมนุษย์นั่นแหละ"
ทำไมนักคณิตศาสตร์แตกเป็นสองฝ่าย
ฝ่ายที่ตื่นเต้น: OfficeChai รวบรวมโพสต์บน X ของนักคณิตศาสตร์หลายคนในวันที่ 6–7 ต.ค. เช่น Alex Kontorovich จาก Rutgers ที่เขียนว่า "ถ้ามนุษย์ทำได้แบบนี้ คงได้เหรียญฟิลด์สทันที" และ Daniel Litt จาก University of Toronto ที่มองว่านักคณิตศาสตร์มีงานน่าตื่นเต้นรออยู่ Aaronson เองเรียกจุดยืนที่ว่าไม่ควรมีใครใช้ AI แก้โจทย์ค้างคาว่า "ยืนอยู่ไม่ได้เลย" แต่ยังสนับสนุนให้ตรวจสอบบริษัท AI เรื่องจังหวะการปล่อยงาน
ฝ่ายที่ไม่พอใจ: ข้อโต้แย้งหลักไม่ได้อยู่ที่ว่าบทพิสูจน์ถูกหรือผิด แต่อยู่ที่วิธีปล่อย
- Association for Human Mathematics ออกแถลงการณ์วันที่ 7 ต.ค. เรียกการปล่อยงานครั้งนี้ว่า "การแสดงอำนาจ" เขียนว่า "นักคณิตศาสตร์ไม่ได้ขอให้ทำงานนี้" และเรียกร้องให้นักคณิตศาสตร์ "ยุติการทำงานร่วมกับ OpenAI" Implicator รายงานว่า Tasmin Chu นักศึกษาปริญญาเอกจาก Caltech เป็นหนึ่งในผู้ร่วมตั้งกลุ่มนี้ Aaronson ตั้งข้อสังเกตว่ากลุ่มนี้พูดแทนสมาชิกของตัวเอง ไม่ใช่ทั้งวงการ
- Terence Tao นักคณิตศาสตร์เจ้าของเหรียญฟิลด์ส บอก TechCrunch ว่าโจทย์กำลังถูกแก้โดยคนสั่งงาน AI ที่ "ไม่สนใจสาขานั้นในภาพกว้าง"
- Dor Minzer ศาสตราจารย์ MIT ผู้เชี่ยวชาญด้านนี้ ได้ข้อความเมื่อ 11 ก.ย. ว่า OpenAI อาจใกล้พิสูจน์ได้ เขากับนักศึกษาสองคนจึงรีบโพสต์งาน 95 หน้าภายในราวสามวัน ซึ่งพิสูจน์โจทย์ใกล้เคียง (4-to-1 games) ได้ด้วยมือมนุษย์ Quanta อ้างคำพูดของเขาว่า การใช้ AI ตัดคุณค่าของความล้มเหลวที่นักวิจัยได้เรียนรู้ออกไป
คณะที่ปรึกษาขอ แต่ OpenAI ให้ไม่ครบ: Advisory Group on Mathematics and Artificial Intelligence (AGMAI) ซึ่ง Institute for Advanced Study เป็นเจ้าภาพ มีสมาชิกอย่าง Timothy Gowers และ Edward Witten ออกแนวปฏิบัติสำหรับห้องแล็บ AI เมื่อ 29 ก.ย. 2026
| AGMAI ขอให้ | OpenAI ทำอย่างไร |
|---|---|
| เปิดชื่อโมเดลที่ใช้ | ไม่เปิด ระบุเพียงว่าเป็น "โมเดลภายในที่ยังไม่เปิดตัว" |
| เปิดคำสั่ง (prompt) ของแต่ละผล | ไม่เปิด |
| เปิดสรุปการคิด เวลา และต้นทุนต่อผล | เปิดสรุปการคิด 10 กลุ่ม และให้ต้นทุนแค่ค่าเฉลี่ย |
| หยุดทดสอบโจทย์ระดับสูงบนโมเดลปิด | ยังทดสอบบนโมเดลปิด |
| ทำบทพิสูจน์ Lean เมื่อทำได้ | ทำแล้วราว 42% |
| ให้ทุนพัฒนาความเข้าใจของมนุษย์ | Implicator รายงานว่า OpenAI จะให้ทุนจัดเวิร์กช็อปและงานประชุม |
ที่มา: Implicator, TechCrunch, README ของ openai/math
AGMAI ระบุในแถลงการณ์วันที่ 6 ต.ค. ว่าการมีส่วนร่วมของกลุ่มไม่ได้แปลว่ารับรองวิธีของ OpenAI และบอก TechCrunch ว่า "ท้ายที่สุดเป็นเรื่องของชุมชนคณิตศาสตร์ที่จะประเมิน" ว่าทำตามคำแนะนำแค่ไหน
ถึงวันนี้ ตรวจไปถึงไหนแล้ว
- Unique Games: วันที่ 8 ต.ค. Aaronson ตอบในคอมเมนต์ว่า Moshkovitz "เข้าใจบทพิสูจน์ส่วนใหญ่แล้ว และทึ่งกับแนวคิดใหม่ในนั้น" แต่ ณ วันที่ 26 ต.ค. 2026 ReadEval ยังไม่พบการตรวจทานฉบับเต็มโดยผู้เชี่ยวชาญอิสระที่เผยแพร่ต่อสาธารณะ
- quasi-Riemann: Quanta รายงานเมื่อ 19 ต.ค. ว่าผู้เชี่ยวชาญ "ส่วนใหญ่เห็นพ้องว่าผลนี้ถูกต้อง" และมีนักคณิตศาสตร์เขียนคำอธิบายยาว 7–13 หน้าเวียนกันอ่าน แต่ Peter Sarnak จาก Princeton จะยังไม่ถือว่าเป็น "ทฤษฎีบท" จนกว่ามนุษย์ตรวจและเข้าใจทุกรายละเอียด และ Radziwiłł วิจารณ์ว่าบทพิสูจน์ทั้งสองฉบับ "เขียนแย่มาก"
- ชุมชนช่วยกันเขียนใหม่: วันที่ 24 ต.ค. บล็อกของ Tao เผยแพร่โพสต์รับเชิญเปิดตัว oai-math-revised คลังที่ชุมชนเป็นเจ้าของ สำหรับปรับปรุงต้นฉบับของ OpenAI ซึ่งผู้เขียนระบุว่า "อาจเข้าใจยากและอ้างอิงไม่ครบ" ใครก็ร่วมแก้หรืออาสาเป็นผู้ตรวจได้
- AGMAI ออกคำแนะนำเพิ่ม: วันที่ 25 ต.ค. คณะที่ปรึกษาแนะนำให้ห้องแล็บ AI เลิกเลือกนักคณิตศาสตร์บางคนให้ได้อ่านผลงานก่อนคนอื่น และให้นำงานไปไว้ในคลังที่บริษัทไม่ได้ควบคุม พร้อมเปิดชื่อโมเดล คำสั่ง จำนวนครั้งที่ลอง และต้นทุน
กระทบคนทั่วไปหรือความปลอดภัยออนไลน์ไหม
- ใช้โมเดลนี้ได้ไหม: ยังไม่ได้ ทั้งในไทยและที่อื่น Implicator รายงานว่า OpenAI บอกว่ากำลังหาทางเปิดให้ใช้ แต่ยังไม่มีกำหนด ReadEval ยังไม่พบข้อมูลว่าจะเปิดในไทยเมื่อใด
- การเข้ารหัสและคริปโต: Justin Drake นักวิจัย Ethereum เตือนเมื่อ 7 ต.ค. ว่าในกรณีเลวร้ายที่สุด ระบบลายเซ็นดิจิทัล ECDSA ที่กระเป๋าคริปโตใช้อาจถูกเจาะได้ "ในไม่กี่เดือน ไม่ใช่หลายปี" และแนะนำให้ทยอยย้ายสินทรัพย์ไปที่อยู่ใหม่ แต่ Implicator ระบุว่า OpenAI ไม่ได้รายงานการโจมตี ECDSA หรือ RSA ในคลังนี้ และ Vitalik Buterin ผู้ร่วมก่อตั้ง Ethereum บอกว่ายังไม่แนะนำให้ย้ายเงินไปกระเป๋าใหม่ตอนนี้ แต่ควรจับตาความเสี่ยง
ความน่าเชื่อถือของคำกล่าวอ้าง
ReadEval ให้คะแนนคำกล่าวอ้างรวมของ OpenAI ว่า "โมเดลแก้โจทย์ค้างคาได้หลายร้อยข้อ" ตามเกณฑ์ 6 ข้อ
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ผ่านบางส่วน (ไม่นับ) | ต้นฉบับและบทพิสูจน์ Lean เปิดให้ใครก็ตรวจซ้ำได้ แต่โมเดลและคำสั่งไม่เปิด คนนอกจึงทำซ้ำคำกล่าวอ้างเรื่อง "สั่งครั้งเดียวได้ผล" ไม่ได้ |
| บอกสภาพแวดล้อมครบ | ไม่ผ่าน | ไม่บอกชื่อโมเดล ไม่เปิดคำสั่ง ให้ต้นทุนเป็นค่าเฉลี่ยเท่านั้น |
| วัดหลายรอบและบอกความแปรปรวน | ไม่ผ่าน | ไม่บอกว่าแต่ละโจทย์ลองกี่ครั้ง โฆษกบอกเพียงว่าบางผล "อาจใช้หลายครั้ง" |
| เทียบอย่างยุติธรรม | ไม่ผ่าน | ไม่บอกว่าโจทย์ราว 4,000 ข้อเลือกมาอย่างไร และคัดผลด้วยเกณฑ์ "สำคัญพอ" ของบริษัทเอง |
| เป็นอิสระ | ไม่ผ่าน | OpenAI ตรวจและคัดผลเอง ยังไม่มีฉบับใดผ่าน peer review มีเพียงผล quasi-Riemann ที่ผู้เชี่ยวชาญภายนอกเริ่มเห็นพ้อง |
| ยอมรับข้อจำกัด | ผ่าน | README เตือนว่าผลที่ไม่มี Lean "อาจมีปัญหา" เปิดบันทึกการถอนและแก้ไข และโฆษกยอมรับว่านักคณิตศาสตร์ของบริษัทยังไม่เข้าใจอีกหลายผล |
| รวม | 1 จาก 6 (หรือ 2 ถ้านับข้อแรก) |
ป้าย 🔴 คำกล่าวอ้าง ใช้กับภาพรวมของคำกล่าวอ้างนี้ ไม่ได้แปลว่าบทพิสูจน์ผิด ผลแต่ละชิ้นที่มีบทพิสูจน์ Lean มีหลักฐานแข็งแรงกว่าป้ายนี้มาก แต่ยังต้องรอมนุษย์ยืนยันว่าโจทย์ในภาษา Lean ตรงกับปัญหาจริง ส่วนผลที่ไม่มี Lean ควรอ่านว่า "OpenAI อ้างว่า" จนกว่าจะมีผู้เชี่ยวชาญภายนอกตรวจ
แหล่งข่าวรายงานไม่ตรงกัน
- 722, 719 หรือ 372: ตัวเลขไม่ได้ขัดกัน แต่นับคนละอย่าง 722 คือต้นฉบับที่ปล่อยวันแรก 719 คือหลังถอน 3 ฉบับ (README และ history.md) และ 372 คือจำนวนกลุ่มผลงาน
- 372 หรือ 377: Quanta Magazine และ Interesting Engineering รายงานว่ามี 377 ผลงาน โดยไม่อธิบายวิธีนับ ส่วน README และ CONTENTS.md ของคลังระบุ 372 กลุ่ม ReadEval ยึดตัวเลขจากคลังของ OpenAI
- สัดส่วนที่ตรวจด้วย Lean: OpenAI นับว่า 42% ของ "ผลหลัก" It Does What Now นับว่า 235 จาก 372 กลุ่ม (ราวสองในสาม) มีเอกสารขอบเขต Lean ส่วนโฆษกบอก Retraction Watch ว่าราว 50% ของผลปล่อยออกมาโดยยังไม่ยืนยัน ตัวเลขต่างกันเพราะนับคนละหน่วย ReadEval ใช้ตัวเลขของ OpenAI และย้ำว่าเป็นตัวเลขที่บริษัทนับเอง
- ถอนผล Hodge หรือไม่: ผู้อ่านบางคนในบล็อกของ Aaronson เล่าว่า OpenAI "ถอนผล rational Hodge conjecture" แต่ history.md แสดงว่าที่ถอนคือฉบับสำหรับ products of K3 surfaces และอีกสองฉบับที่เกี่ยวข้อง ส่วนผล Hodge สำหรับ CM abelian varieties ยังอยู่
- OpenAI ผูกพันกับคำแนะนำหรือไม่: Implicator อ้างคำพูดโฆษกว่าบริษัท "ไม่ได้ผูกพันกับคำแนะนำ" ของคณะที่ปรึกษา แต่บอก Retraction Watch ว่า "ตั้งใจทำตามแนวทางให้ได้มากที่สุด" สองคำพูดนี้ไม่ได้ขัดกันโดยตรง แต่ให้น้ำหนักต่างกัน
- "สั่งครั้งเดียว": มาจากโฆษกของ OpenAI ซึ่ง It Does What Now ระบุว่าให้ข้อมูลกับ Scientific American และ Implicator รายงานคำพูดเดียวกันว่า "เกือบทุกผลได้จากคำสั่งเดียวกับเอเจนต์ตัวเดียว" แม้บางผลอาจต้องลองหลายครั้ง คนนอกยังตรวจไม่ได้เพราะไม่มีคำสั่งและโมเดลให้ลอง Sutherland จาก MIT บอกว่าควรถือว่ายังไม่ยืนยันจนกว่าจะปล่อยโมเดลให้ทำซ้ำได้
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
AI ของ OpenAI อาจพิสูจน์โจทย์สำคัญได้จริงหลายข้อ แต่สิ่งที่ปล่อยออกมาคือกองต้นฉบับที่ยังไม่มีใครอ่านจบ ไม่ใช่องค์ความรู้ที่วงการยอมรับแล้ว ต้องให้เครดิตว่า OpenAI ทำหลายอย่างที่ข่าวทำนอง "AI พิสูจน์ได้แล้ว" มักไม่ทำ คือเปิดต้นฉบับทั้งหมด แนบบทพิสูจน์ที่เครื่องตรวจได้ราว 4 ใน 10 และเปิดบันทึกการถอนและแก้ไขให้เห็น แต่การปล่อยหลายร้อยชิ้นพร้อมกัน โดยไม่บอกชื่อโมเดล ไม่เปิดคำสั่ง และเขียนให้มนุษย์อ่านยาก ได้โยนภาระการตรวจไปให้นักคณิตศาสตร์ทั่วโลกที่ไม่ได้ขอรับงานนี้ ReadEval ประเมินว่าตัวชี้วัดที่ควรติดตามต่อไม่ใช่จำนวนผลงานที่ AI เขียน แต่คือจำนวนผลงานที่นักคณิตศาสตร์นอกบริษัทอ่านเข้าใจและนำไปใช้ต่อได้ ซึ่งตอนนี้เพิ่งเริ่มนับ ส่วนผู้อ่านทั่วไป ข่าวนี้บอกว่า AI ทำงานคิดระดับสูงได้เร็วขึ้นมาก แต่คำว่า "พิสูจน์ได้" จาก AI ยังต้องรอคนอ่านตามให้ทันเสมอ
แหล่งที่มา
- OpenAI: Sharing AI progress in mathematics (ประกาศ 6 ต.ค. 2026 เปิดหน้าโดยตรงไม่ได้ ใช้ผ่านคลัง GitHub และรายงานของสื่อ)
- GitHub openai/math: README, CONTENTS.md และ lean/formalization.yaml
- GitHub openai/math: history.md (การถอนและแก้ไข 7 ต.ค. 2026)
- GitHub openai/math: ขอบเขตบทพิสูจน์ Lean ของกลุ่ม 102 (Unique Games)
- Scott Aaronson, Shtetl-Optimized: The Mathocalypse (7 ต.ค. 2026) และคอมเมนต์ #94, #132
- Implicator: OpenAI's 372 math results leave mathematicians racing
- OfficeChai: OpenAI releases AI-generated proofs of quasi-Riemann, Unique Games, Hodge for CM abelian varieties
- OfficeChai: Mathematicians react with shock and wonder after OpenAI releases over 300 math proofs
- Retraction Watch: OpenAI withdraws three preprints a day after releasing 722 manuscripts
- TechCrunch: OpenAI's math solutions aren't meeting the field's standards yet
- Quanta Magazine: As AI closed in on 'Unique Games' proof, researchers raced to beat the machines
- Quanta Magazine: AI proved the quasi-Riemann hypothesis. What happens now? (19 ต.ค. 2026)
- It Does What Now: OpenAI publishes hundreds of AI-written proofs of open maths problems
- Interesting Engineering: OpenAI unveils 377 math results
- arXiv: Navier-Stokes lost in translation (Bastounis, Circelli, Hansen)
- Henry Yuen: On OpenAI and quantum parallel repetition (ส.ค. 2026)
- Terence Tao's blog: oai-math-revised, a community hub for revising OpenAI's math write-ups (24 ต.ค. 2026)
- AGMAI (บล็อกของ Terence Tao): Disadvantages of designating mathematicians for AI output releases (25 ต.ค. 2026)