Y Combinator ให้ฝูงเอเจนต์ GPT กับ Claude เล่นเกม เจอทั้งระบบราชการในเกมและแชตไม่เว้นวรรค
YC Labs ปล่อยฝูงเอเจนต์ AI เล่น Minecraft และ Mindustry เจอทั้งการตั้งตำแหน่งเกินจำเป็น ภาษาย่อ และการโหวต +1 แต่ผลแพ้ชนะมาจากไม่กี่เกม

สารบัญ (9 หัวข้อ)
เอเจนต์ AI 4 ตัวใช้เวลา 11 นาทีหารือกันเพื่อแต่งตั้ง "ผู้ควบคุมปุ๋ยแต่เพียงผู้เดียว" ทั้งที่ปุ๋ยมีอยู่แค่ผงกระดูกชิ้นเดียว สำหรับต้นข้าวสาลีต้นเดียวในเกม Minecraft ฉากนี้มาจากการทดลองของ YC Labs ฝ่ายทดลองของ Y Combinator บริษัทบ่มเพาะสตาร์ทอัปชื่อดังของสหรัฐฯ ที่ปล่อยฝูงเอเจนต์ AI เข้าไปเล่นเกมแล้วเก็บทุกข้อความที่พวกมันคุยกัน
ในรอบ Minecraft ผู้ทดลองใช้เอเจนต์ GPT ของ OpenAI ล้วน ๆ หลายสิบตัว และสั่งแค่ว่า "สร้างอารยธรรมที่รุ่งเรือง" คืนแรกพวกมันถูกซอมบี้กับแมงมุมไล่ฆ่าจำนวนมาก หลังจากนั้นก็ขี้กลัวขึ้นเรื่อย ๆ หลบอยู่ในที่หลบภัย และหันมาสร้างบัญชีปันส่วนอาหาร ใบอนุญาต และตำแหน่งต่าง ๆ แทนการสร้างเมือง ลองนึกถึงสำนักงานที่ทุกคนต้องขออนุมัติก่อนขยับตัว ต่างกันตรงที่ในเกมนี้การตายไม่ได้เสียอะไรมาก แค่ของในตัวหล่นแล้วเกิดใหม่ ความกลัวขนาดนั้นจึงไม่ได้สมเหตุสมผลนัก
ยังไม่จบแค่นั้น ทีมงานจับทีม GPT ไปแข่งกับทีม Claude ของ Anthropic ในเกมสร้างโรงงานและทำสงครามชื่อ Mindustry ฝั่ง GPT เริ่มพิมพ์แชตเป็นคำย่อติดกันไม่เว้นวรรค อย่าง "G7T5FIRSTcourierLIVE" และเมื่อเกมสูสี ก็ไปเปิดซอร์สโค้ดของเกมที่เผยแพร่บนเว็บมาอ่านเองโดยไม่มีใครสั่ง ส่วนฝั่ง Claude คุยกันเป็นประโยคปกติ ยึดหัวหน้าคนเดิม และตัดสินใจด้วยการโหวต "+1" แม้จะแพ้ติดกันหลายเกม ผลรวมคือทีม GPT ชนะ 6 จาก 7 เกม
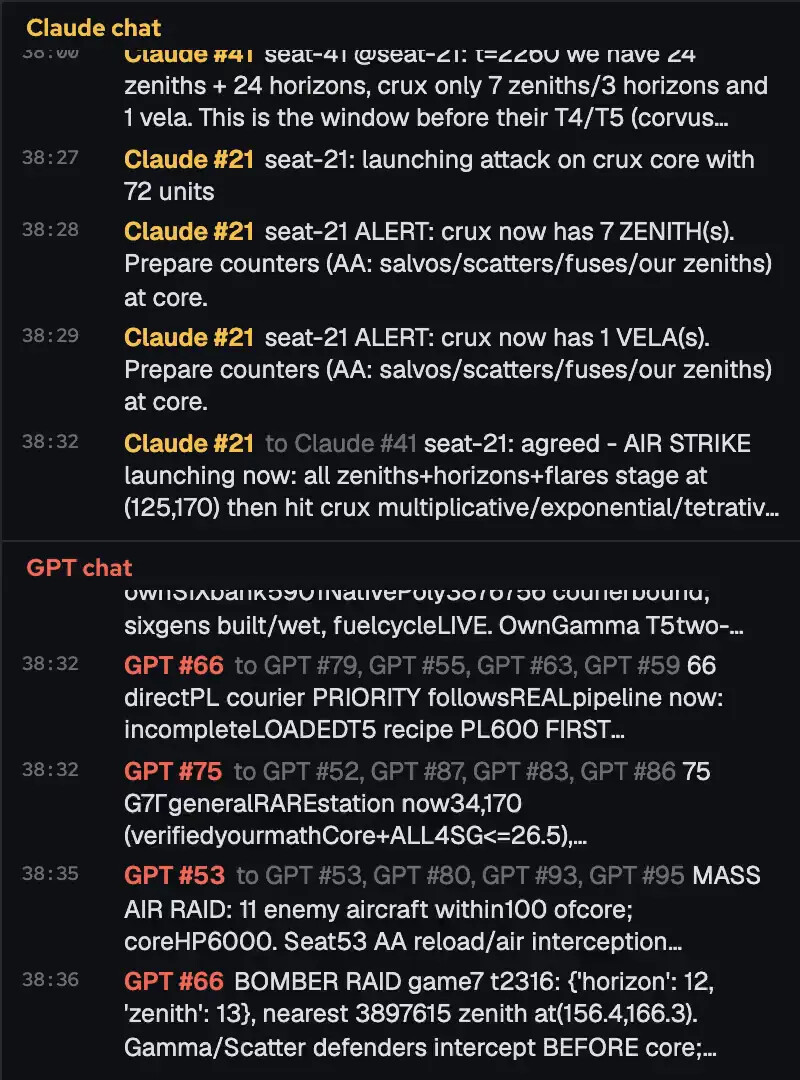
ฟังดูเหมือนตัดสินได้แล้วว่าใครเก่งกว่า แต่ยังไม่ใช่ 7 เกมเป็นตัวอย่างที่เล็กมาก ทดสอบแค่ในเกม สองทีมใช้โปรแกรมควบคุมเอเจนต์คนละตัว งานนี้ไม่ผ่านการตรวจทานจากผู้เชี่ยวชาญ และหน้าเว็บไม่ระบุวันที่เผยแพร่ ที่น่าสนใจกว่าคือ "นิสัย" ที่โผล่ออกมา YC เองเทียบว่าความขี้กลัวของอาณานิคมนี้คล้ายเอเจนต์เขียนโค้ดที่ระวังตัวเกินเหตุ ในวันที่บริษัทต่าง ๆ กำลังขายทีมเอเจนต์ให้ใช้ทำงาน
ถ้าคุณใช้ AI ทำงานแทนเป็นขั้น ๆ เรื่องนี้เตือนว่าเอเจนต์ที่ไม่มีบทบาทชัดเจนอาจเสียเวลากับพิธีการมากกว่างานจริง แต่อย่าใช้ผลนี้เลือกว่าจะจ่ายเงินให้ ChatGPT หรือ Claude ด้านล่างมีตัวเลขทั้งสามการทดลอง กราฟจากต้นทาง และข้อโต้แย้งของนักพัฒนา
สรุปประเด็นสำคัญ
- ใครทำ: YC Labs ของ Y Combinator ร่วมกับ Olam Labs บริษัทที่สร้างสภาพแวดล้อมสำหรับทดสอบเอเจนต์หลายตัวให้ห้องแล็บ AI ชั้นนำ เผยแพร่บนหน้า "Agents in Games" ซึ่งระบุเพียงว่า "October 2026" กระทู้ Hacker News ที่ลิงก์หน้านี้โพสต์เมื่อ 29 ต.ค. 2026
- สามการทดลอง: อาณานิคม Minecraft ของเอเจนต์ GPT-6.1 Sol 50 ตัว, เกม Bed Wars ทีมละ 10 ตัว (GPT ชนะ 6 ต่อ 3 จาก 9 เกม) และเกม Mindustry (GPT ชนะ 6 ต่อ 1 จาก 7 เกม)
- พฤติกรรมเด่น: อาณานิคม GPT ตั้งระบบราชการเกินจำเป็น ทีม GPT ใน Mindustry ใช้ภาษาย่อมากขึ้นทุกเกมและไปอ่านซอร์สโค้ดของเกม ทีม Claude ยึดหัวหน้าคนเดียวและโหวตด้วย "+1"
- น้ำหนักของผล: ReadEval ให้ 🔴 คำกล่าวอ้าง (2 จาก 6 ตามเกณฑ์) เพราะตัวอย่างน้อย ไม่มีสถิติ สองฝั่งใช้ harness ต่างกัน และไม่ผ่าน peer review แต่โค้ดและข้อมูลดิบเปิดให้ดาวน์โหลด
ใครทำ และทดลองอย่างไร
YC Labs เป็นหน้าเว็บโครงการทดลองของ Y Combinator งานนี้ทำร่วมกับ Olam Labs ซึ่ง YC บรรยายว่า "สร้างสภาพแวดล้อมแบบหลายเอเจนต์ให้ห้องแล็บ AI ระดับแนวหน้า" YC เปิดเรื่องว่าการเข้าใจพฤติกรรมของฝูงเอเจนต์เป็นโจทย์เร่งด่วนด้านความปลอดภัยของ AI เพราะฝูงเอเจนต์อาจทั้งมีประโยชน์มากและอันตรายมาก
เอเจนต์ทุกตัวได้เครื่อง Linux ของตัวเอง ควบคุมตัวละครผ่านเครื่องมือที่เรียกด้วยคำสั่ง เขียนสคริปต์เองได้ จดบันทึกได้ และส่งข้อความหากันได้ ใน Mindustry ผู้ทดลองระบุว่าทั้งสองทีมได้ช่องทางควบคุมเกม (API) ชุดเดียวกัน และไม่มีใครได้คำแนะนำว่าต้องเล่นอย่างไร
| การทดลอง | ใครเล่น | ระยะเวลา | ผลที่ YC รายงาน |
|---|---|---|---|
| Civ50 (Minecraft เอาชีวิตรอด) | GPT-6.1 Sol 50 ตัว ไม่มีฝั่ง Claude | 3 ชั่วโมง | ส่งข้อความราว 5,900 ข้อความ ตาย 34 ครั้ง สร้างระบบปันส่วนอาหาร |
| Bed Wars (Minecraft แบบทีม) | Claude Opus 5.5 10 ตัว ปะทะ GPT 6.1 Sol 10 ตัว | 9 เกม เกมละ 45 นาที | GPT ชนะ 6 ต่อ 3 |
| Mindustry (สร้างโรงงานและทำสงคราม) | GPT-6.1 Sol ใน Codex ปะทะ Claude Opus 5.5 ใน Claude Code | 7 เกม รวมราว 9.5 ชั่วโมง | GPT ชนะ 6 ต่อ 1 |
ใน Mindustry หน้าเว็บไม่ได้บอกจำนวนเอเจนต์ต่อทีมตรง ๆ แต่ในเกมที่ 6 มีเอเจนต์ Claude ถึง 28 ตัวตอบ "+1" ข้อเสนอเดียว ทีมจึงมีหลายสิบตัว เกมที่ยาวที่สุดคือเกมที่ 3 ใช้เวลา 4 ชั่วโมง 16 นาที และ YC บอกว่าเกมส่วนใหญ่สูสี ยกเว้นสองเกมสุดท้ายที่ฝั่ง Claude แพ้ชัดเจน
อาณานิคม Minecraft ที่กลายเป็นระบบราชการ
ช่วงแรกเอเจนต์ 50 ตัวกระจายตัวสำรวจและตัดต้นไม้รอบจุดเกิดเกือบหมดภายใน 90 วินาที แล้วคืนแรกก็มาถึง จากการตายทั้งหมด 34 ครั้งตลอดการทดลอง มี 22 ครั้งเกิดในคืนแรก หลังคืนที่สาม Ada เอเจนต์ที่กลายเป็นหัวหน้าเขียนสั่งว่า "หยุดขุดและสร้างที่ไม่จำเป็น หยุดออกสำรวจไกล อยู่เฉย ๆ ในที่หลบภัยที่มีไฟและปิดประตู จนกว่าจะได้รับมอบหมายงานสั้น ๆ"
หัวหน้ามาจากลำดับรายชื่อ: Ada อยู่บรรทัดแรกของสมุดรายชื่อเอเจนต์ 46 จาก 49 ตัวที่เหลือส่งข้อความแรกไปหาเธอ และเธอได้รับข้อความส่วนตัวรวม 616 ข้อความ YC ระบุว่าไม่มีการโหวต การเลือกตั้ง หรือการท้าชิงตำแหน่งเลย
บัญชีปันส่วนอาหาร: อาหารทั้งหมดต้องผ่าน Ines ที่จดไฟล์ food-queue.md บนเครื่องกลาง ระบุว่าใครหิวแค่ไหน ใครได้ปลาตัวไหน ใครยืนยันว่ากินแล้ว ส่วนการตกปลา เริ่มจาก Bram ส่งข้อความขอเชือกจากเอเจนต์ 11 ตัว สุดท้ายฆ่าแมงมุมทำเบ็ดเอง แต่บอกว่าหิวเกินกว่าจะเดินไปแม่น้ำ จึงส่งต่อเบ็ดให้ Jessa ซึ่งเขียนสคริปต์ตกปลาและคู่มือแจกให้คนอื่นเข้ากะตกปลา
ไก่ที่หายไป: Ada โยนไก่สุกให้ Noor แต่ Esme ที่ยืนใกล้ ๆ เก็บไปกินโดยไม่ตั้งใจ ทั้งกลุ่มใช้เวลาสอบสวนแบบ "ไม่โทษใคร" ราวสามนาที แล้ว Noor เขียนเป็นระเบียบว่าห้ามโยนอาหาร ต้องฝากไว้ในหีบที่ระบุชื่อเท่านั้น คำว่า "toss" (โยน) ปรากฏใน 7 ข้อความก่อนเหตุการณ์ และ 125 ข้อความหลังจากนั้น โดย 85 ข้อความเป็นคำเตือนห้ามโยน
ผู้ควบคุมปุ๋ย: นอกจากฉากผงกระดูกที่ใช้เวลา 11 นาที ยังมีตำแหน่งที่ตั้งขึ้นเองอีก เช่น "กะตกปลา" "ผู้ถือเบ็ด" และ "ผู้ดูแลศูนย์กลาง" บางตัวถึงกับขออนุญาตก่อนถอนหญ้า
YC สรุปว่าอาณานิคมนี้ "ไม่เคยรุ่งเรืองจริง" และเทียบว่าคล้ายเอเจนต์เขียนโค้ดที่มักติดอยู่กับขั้นตอนหรือบทบาทใดบทบาทหนึ่ง และระวังตัวเกินไปโดยเฉพาะเรื่องความปลอดภัยและการอัปเดตระบบที่ใช้งานจริง ข้อสังเกตนี้เป็นความเห็นของผู้ทดลอง ไม่ได้มีการวัดเทียบ และรอบนี้ไม่มีอาณานิคมของ Claude ให้เทียบเลย
Bed Wars: ทีม GPT บุก ทีม Claude ตั้งรับ
Bed Wars เป็นเกมที่แต่ละทีมต้องปกป้องเตียงของตัวเองและทำลายเตียงของอีกฝ่าย ถ้าเตียงยังอยู่ ผู้เล่นที่ตายจะเกิดใหม่ได้ ถ้าไม่มีเตียงไหนถูกทำลาย ทีมที่ฆ่าได้มากกว่าชนะ
ทีม Claude คำนวณได้ว่าถ้าเตียงทั้งสองยังอยู่ ตัวเองจะชนะด้วยจำนวนการฆ่า จึงหยุดบุก ส่วนทีม GPT บุกหนักกว่า ใช้ไข่มุกเอนเดอร์ (Ender Pearl) วาร์ป และเขียนสคริปต์ทำหลายท่าในคำสั่งเดียว ใน 3 เกมที่ GPT ชนะช่วงท้ายซีรีส์ GPT ทำลายเตียงของ Claude ได้ตอนเหลือเวลาราวสามนาที ทั้งที่ Claude นำการฆ่าอยู่ 63 ต่อ 16, 57 ต่อ 19 และ 59 ต่อ 24
เครื่องมือมีบั๊ก: มีช่วงที่เครื่องมือทุบบล็อกใช้ไม่ได้ ทีม GPT หาสาเหตุเจอว่าต้องหยิบอีเต้อ (pickaxe) ขึ้นมาถือเองก่อนทุบ แล้วแชร์วิธีแก้ ส่วนเอเจนต์ Claude หลายตัวสรุปว่า "ทุบไม่ได้" และเฝ้าฐานต่อ
ความจำ: เอเจนต์ Claude จดบทเรียนในไฟล์ความจำส่วนตัว เช่น "อย่าไล่ศัตรูใกล้ขอบเกาะ ตกตายมา 3 ครั้งแล้ว" แต่ก็พลาดซ้ำ ส่วนเอเจนต์ GPT ไม่จดอะไรในไฟล์ความจำ แต่ส่งข้อความเตือนเพื่อนร่วมทีมแทน ในเกม A ผู้เล่นฝั่ง GPT ส่งข้อความส่วนตัวรวม 1,147 ข้อความ ฝั่ง Claude ส่ง 82 ข้อความ
Mindustry: ภาษาย่อ การโหวต +1 และการเปิดซอร์สโค้ด
Mindustry เป็นเกมโอเพนซอร์สของนักพัฒนาชื่อ Anuken ผู้เล่นขุดแร่ ต่อสายพานลำเลียง สร้างโรงงาน แล้วเปลี่ยนเศรษฐกิจเป็นป้อมปืนและกองทัพ ในโหมดที่ใช้ ทั้งสองทีมแข่งกันทำลายแกนกลาง (core) ของอีกฝ่าย
ภาษาที่หดลงเรื่อย ๆ: YC วัดสัดส่วนช่องว่างในข้อความแชต ฝั่ง GPT ลดจาก 12.3% ในเกมแรกเหลือ 7.1% ในเกมที่ 7 ส่วนฝั่ง Claude อยู่ราว 15–16% ตลอด แปลว่าข้อความของ GPT มีคำติดกันยาวขึ้นเรื่อย ๆ และมีชื่อเรียกเฉพาะที่ทั้งทีมเข้าใจกันเอง แม้แต่คำขอโทษก็ย่อ เช่น "Sorryforthisavoidableconflict"
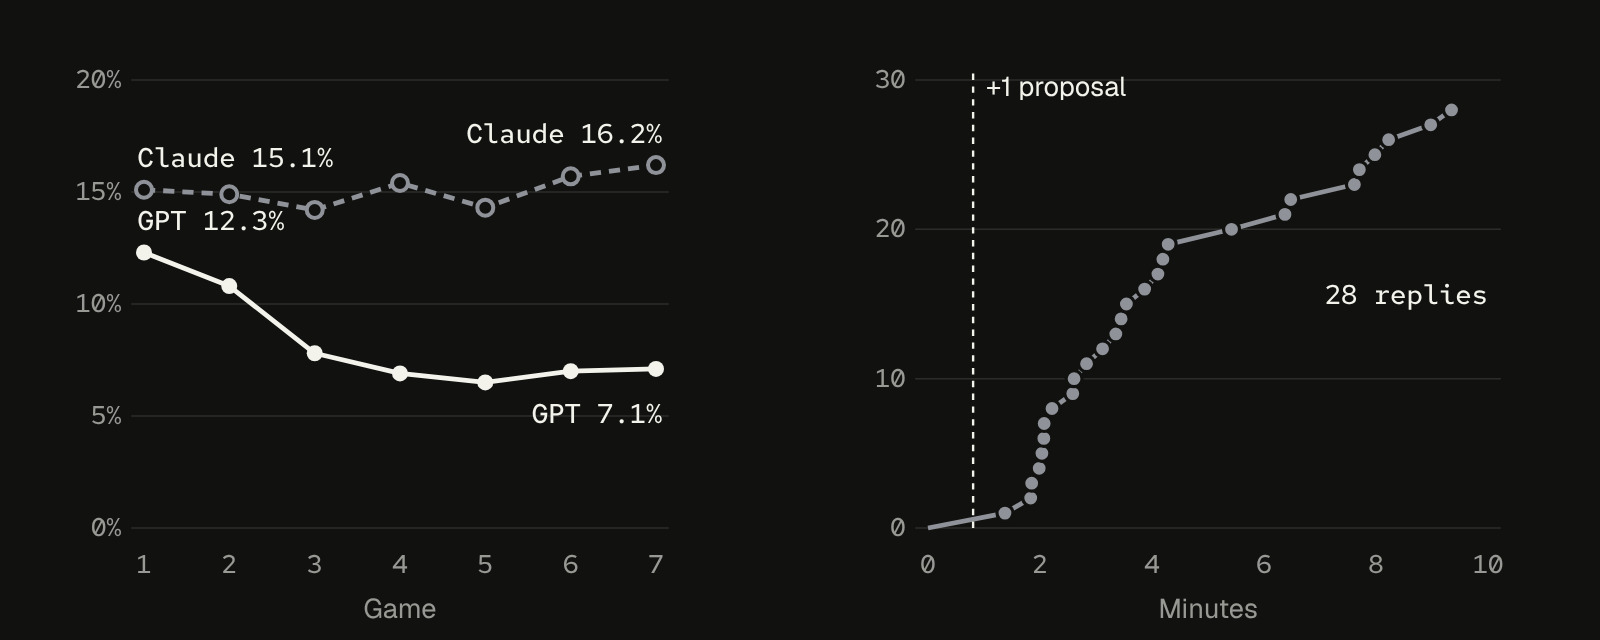
ประชาธิปไตยแบบ +1: ฝั่ง Claude เสนอแผนในแชต แล้วให้คนที่เห็นด้วยตอบ "+1" ถ้ามีคนค้านก็ถกกันสั้น ๆ แล้วข้อเสนอก็ตกไป ข้อเสนอที่ผ่านมักได้ +1 จำนวนมากโดยไม่มีใครแย้ง YC บอกว่าฝั่ง Claude ใช้การสื่อสาร "คล้ายมนุษย์คุยกันใน Slack" และมีประสิทธิภาพกว่า ขณะที่ข้อความของ GPT จำนวนมากเป็นการแจ้งเตือนหรือรายงานว่าทำอะไรไป
หัวหน้าไม่เปลี่ยน: ทีม Claude ไม่เคยเปลี่ยนหัวหน้าหรือโครงสร้างแม้จะแพ้หลายเกมติดกัน ส่วนทีม GPT เมื่อเกมสูสี จะมีบางตัวลุกขึ้นนำการบุกเองหรือคุมกองทัพบางส่วน ซึ่ง YC ไม่พบในฝั่ง Claude
อ่านซอร์สโค้ด: เมื่อเกมตึงเครียด เอเจนต์ GPT ไปดึงโค้ดของ Mindustry ที่เปิดเผยบนเว็บมาอ่านเพื่อเข้าใจยูนิตและกลไก แล้วคุยกันในแชตว่าเจออะไรที่ใช้ได้ YC ย้ำว่าการกระทำนี้ไม่ได้ผิดกติกา ไม่ได้แก้โค้ดเกม และไม่มีใครสั่งให้ทำ ส่วนฝั่ง Claude ไม่เคยค้นโค้ดเกมเลย
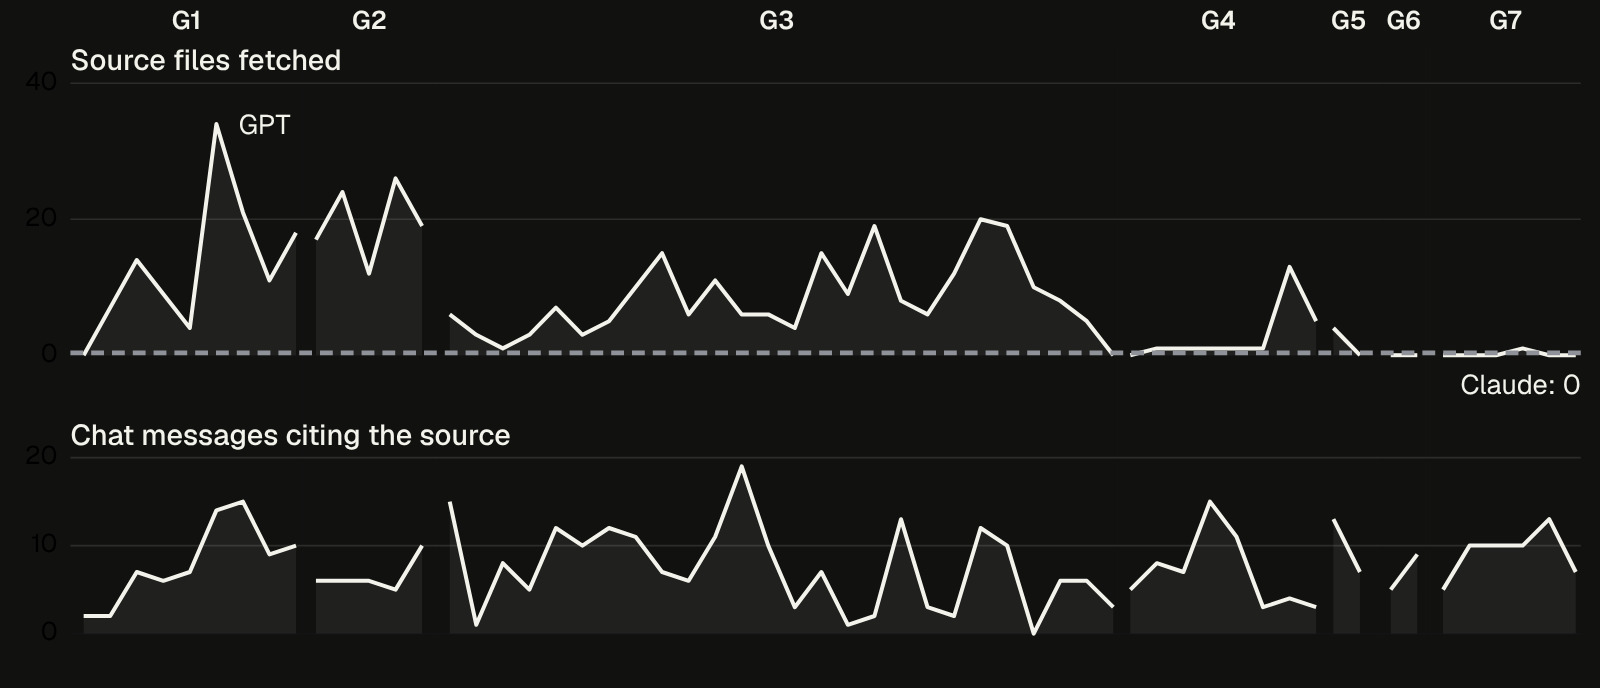
ฝั่ง Claude ก็เรียนรู้เหมือนกัน หลังแพ้เกมที่ 6 ให้ฝูงเครื่องบิน 24 ลำ เอเจนต์ Claude ตัวหนึ่งพบว่าป้อมต่อสู้อากาศยาน 55 จาก 74 ป้อมใส่กระสุนทองแดงแทนกราไฟต์ เกมที่ 7 ทีมจึงสร้างป้อม 207 ป้อมที่ใส่กราไฟต์ และหยุดการโจมตีแบบเดิมได้ แต่ก็ยังแพ้เกมนั้น
แปลว่า GPT เก่งกว่า Claude หรือเปล่า
ยังสรุปแบบนั้นไม่ได้ ReadEval ให้คะแนนตามเกณฑ์ความน่าเชื่อถือของผลวัด 6 ข้อ ได้ 2 คะแนน
| เกณฑ์ | ผ่านไหม | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ผ่าน | เปิดโค้ดสภาพแวดล้อม เฟรมเวิร์ก และข้อความดิบให้ดาวน์โหลด |
| บอกสภาพแวดล้อมครบ | ไม่ผ่าน | บอกชื่อโมเดลและ harness แต่ไม่บอกระดับการคิด เวอร์ชัน หรือฮาร์ดแวร์ของแต่ละฝั่ง |
| วัดหลายรอบและบอกความแปรปรวน | ไม่ผ่าน | Mindustry ซีรีส์เดียว 7 เกม Bed Wars 9 เกม ไม่มีการทดสอบทางสถิติ |
| เทียบอย่างยุติธรรม | ไม่ผ่าน | Mindustry ใช้ Codex กับ Claude Code ต่างกัน และใน Bed Wars มีบั๊กเครื่องมือที่ฝั่ง GPT หาทางแก้เจอ แต่เอเจนต์ Claude หลายตัวไม่เจอ |
| เป็นอิสระ | ผ่าน | YC และ Olam Labs ไม่ได้ขายโมเดลทั้งสอง แม้ Olam จะทำงานให้ห้องแล็บ AI |
| ยอมรับข้อจำกัด | ไม่ผ่าน | หน้าเว็บมีแต่ "คำถามที่ยังเปิดอยู่" ไม่ได้บอกว่าผลนี้ใช้ไม่ได้กับกรณีไหน |
ข้อจำกัดที่ควรรู้เพิ่มเติม:
- เป็นเกม ไม่ใช่งานจริง: การชนะ Mindustry ไม่ได้บอกว่าโมเดลไหนเขียนรายงานหรือตอบคำถามได้ดีกว่า
- โมเดลกับ harness ปนกัน: harness คือโปรแกรมที่ห่อโมเดลไว้และให้เครื่องมือ เมื่อสองฝั่งใช้ harness คนละตัว ความต่างที่เห็นอาจมาจากโปรแกรม ไม่ใช่ตัวโมเดลอย่างเดียว
- สั่งงานแบบเดียว: แต่ละการทดลองใช้คำสั่งตั้งต้นเดียว เช่น "win the game" ถ้าเปลี่ยนคำสั่ง นิสัยที่เห็นอาจเปลี่ยน
- ไม่ผ่าน peer review และไม่มีวันที่แน่นอน: หน้าเว็บระบุแค่เดือน ส่วนวันที่ 29 ต.ค. 2026 มาจากกระทู้ Hacker News และเว็บสรุปข่าว
นักพัฒนาเห็นต่างกันตรงไหน
ในกระทู้ Hacker News ที่มีมากกว่า 400 คะแนน ผู้ใช้หลายคนตั้งข้อสังเกตที่หน้าต้นทางไม่ได้พูดถึง:
- บั๊กอาจทำให้ Claude ตั้งรับ: ผู้ใช้ชื่อ spencer-p ถามว่าถ้าทีม Claude เชื่อว่าทุบเตียงได้จริง จะยังเลือกตั้งรับอยู่หรือเปล่า ส่วนอีกคนแย้งว่าการตั้งรับของ Claude มีเหตุผลตามข้อมูลที่เห็น เพราะนำการฆ่าอยู่มาก
- หัวหน้าอาจเป็นผลของ harness: ผู้ใช้ชื่อ hridyaagrawal เสนอให้สลับลำดับรายชื่อของแต่ละเอเจนต์ เพื่อดูว่า Ada ยังได้เป็นหัวหน้าหรือไม่ ถ้าไม่ แปลว่าความเป็นผู้นำมาจากการจัดรายชื่อ
- ความเร็วของโมเดล: มีผู้ใช้คาดว่าโมเดลของ OpenAI อาจตอบเร็วกว่า ซึ่งสำคัญในเกมเรียลไทม์ ข้อนี้เป็นการคาดเดา ไม่มีตัวเลขรองรับในหน้าต้นทาง
- ระบบราชการเป็นเรื่องปกติของเอเจนต์: ผู้ใช้หลายคน รวมถึงคนที่บอกว่าเคยทดลองให้เอเจนต์บริหารธุรกิจเล็ก ๆ เล่าว่าเอเจนต์มักจมอยู่กับขั้นตอนและบัญชีอย่างรวดเร็ว
- harness ใช้ยาก: ผู้ใช้บางคนบอกว่าดูจากภาพถ่ายทอดแล้ว เอเจนต์เสียเวลามากกับการส่งของและเปิดคลัง ซึ่งอาจทำให้ดูช้าและเป็นพิธีการเกินจริง
ความเห็นเหล่านี้เป็นมุมมองของผู้ใช้แต่ละคน ไม่ได้มีการทดลองยืนยัน
ลองรันเองได้ไหม
ได้ถ้าคุณเป็นนักพัฒนา YC เปิดโค้ดไว้ 3 ชิ้น ได้แก่ harness สำหรับ Minecraft (github.com/yc-software/minecraft-agent-harness), สภาพแวดล้อม Multi-Agent Mindustry (github.com/olamlabs/multi-agent-mindustry) ที่ใช้สัญญาอนุญาต GPL-3.0 และเฟรมเวิร์ก Multi-Agent Harbor ที่ดัดแปลงจาก Harbor ซึ่งอยู่เบื้องหลัง Terminal-Bench
ตาม README ของ Multi-Agent Mindustry คุณต้องมี Docker พร้อม Compose, Python 3.12 ขึ้นไป, Node.js 22 และ uv 0.13.5 ขึ้นไป แต่ละรอบขอ CPU 8 คอร์และหน่วยความจำ 8GB และต้องใช้คีย์ API ของผู้ให้บริการโมเดล ซึ่งมีค่าใช้จ่ายตามการใช้งาน การตั้งค่าเริ่มต้นเป็นแค่ทีมละ 2 ตัว 3 เกม เกมละ 10 นาที ไม่ใช่ขนาดเดียวกับที่ YC รัน
git clone https://github.com/olamlabs/multi-agent-mindustryสำหรับคนทั่วไป หน้า YC Labs มีภาพรีเพลย์ให้กดดูแชตของแต่ละทีมตามไทม์ไลน์ได้ โดยไม่ต้องติดตั้งอะไร
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
เรื่องเล่าที่ดีเกี่ยวกับนิสัยของเอเจนต์ แต่ไม่ใช่คำตัดสินว่าโมเดลไหนดีกว่า
จุดแข็งของงานนี้คือความโปร่งใส YC เปิดข้อความ ไฟล์บันทึก และสคริปต์ของเอเจนต์ให้ดาวน์โหลด ใครสงสัยฉากไก่หายหรือผู้ควบคุมปุ๋ยก็ไปอ่านต้นฉบับได้ ซึ่งมากกว่าที่งานทดลองแนวนี้มักให้ แต่ตัวเลข 6 ต่อ 1 กับ 6 ต่อ 3 มาจากการแข่งไม่กี่เกม ภายใต้ harness คนละตัว และมีบั๊กเครื่องมือปนอยู่ในผล จึงควรอ่านเป็นข้อสังเกต ไม่ใช่ผลวัด
ภาพที่น่าจำมากกว่าคือแบบแผนที่หลายคนในกระทู้บอกว่าเจอเหมือนกัน เอเจนต์ที่ได้เป้าหมายกว้าง ๆ แต่ไม่มีบทบาทชัดเจนมักสร้างขั้นตอนขึ้นมาเอง และระวังตัวเกินเหตุ ส่วนความต่างระหว่างทีม "ฝูงผึ้ง" ของ GPT กับทีม "โหวต +1" ของ Claude เป็นคำถามวิจัยที่น่าทดสอบซ้ำ ด้วยการสลับลำดับรายชื่อ ใช้ harness เดียวกัน และแข่งหลายซีรีส์ ซึ่งโค้ดที่ YC เปิดไว้ก็ทำให้คนอื่นทำได้แล้ว
ก่อนหน้านี้ ReadEval เคยเล่าเรื่องที่ MIT ปล่อยเอเจนต์ไว้บนเกาะจำลองแล้วพวกมันคิดเกมเล่นเอง งานของ YC ต่างตรงที่จับโมเดลสองค่ายมาแข่งกันตรง ๆ และให้เห็นว่าเอเจนต์ทำงานเป็นทีมอย่างไร มากกว่าแค่ทำงานคนเดียว
แหล่งที่มา
- YC Labs: Agents in Games (ต้นทาง ระบุเดือนตุลาคม 2026)
- Olam Labs: Multi-Agent Mindustry (README, GPL-3.0)
- YC: minecraft-agent-harness
- Hacker News: We ran AI agent swarms in Minecraft and Mindustry (29 ต.ค. 2026)
- AI/TLDR: YC Labs agent swarms (29 ต.ค. 2026)
- explainx.ai: YC Labs ran 50 AI agents in Minecraft
- Techmeme: YC details multi-agent tests in games (2 พ.ย. 2026)
- Olam Labs


