GPT-6 Astra แก้ตัวเลขข้างใน AI อีกตัวตรง ๆ จนเลิกคิดวน คะแนนคณิตขึ้นจาก 7.9% เป็น 48.1%
ทีม MIT ให้ GPT-6 Astra แก้ค่าน้ำหนักของ Qwen3.5-0.8B โดยไม่เทรนใหม่ คะแนนคณิตขึ้นเพราะโมเดลเลิกคิดวน ไม่ใช่ฉลาดขึ้น และยังเป็นผลเบื้องต้น

สารบัญ (10 หัวข้อ)
ลองนึกภาพว่ามีคนยื่นตัวเลขหลายร้อยล้านตัวให้คุณ แล้วขอว่า "ช่วยทำให้มันเก่งคณิตขึ้นหน่อย" คนส่วนใหญ่คงไม่รู้จะเริ่มตรงไหน แต่ทีมนักวิจัยจาก MIT CSAIL ยื่นโจทย์แบบนี้ให้ GPT-6 Astra โมเดล AI ของ OpenAI และมันแก้ตัวเลขในโมเดล AI อีกตัวได้ตรง ๆ จนคะแนนสอบคณิตดีขึ้นมาก โดยไม่ต้องฝึก (เทรน) ใหม่เลย
ตัวเลขกองนั้นเรียกว่า ค่าน้ำหนัก (weights) เป็นที่เก็บทุกอย่างที่ AI เรียนรู้มา นึกถึงมิกเซอร์เสียงที่มีปุ่มหมุนหลายร้อยล้านปุ่ม การเทรนคือให้คอมพิวเตอร์ค่อย ๆ หมุนปุ่มเองจากตัวอย่างจำนวนมาก ส่วนงานนี้ให้ Astra เปิดดูปุ่มแล้วหมุนเอง ต่างจากมิกเซอร์จริงตรงที่ไม่มีปุ่มไหนติดป้ายว่าทำหน้าที่อะไร และปุ่มเดียวมักมีผลกับหลายอย่างพร้อมกัน นักวิจัยจึงเขียนว่าสำหรับมนุษย์เกือบทุกคน การอ่านตัวเลขพวกนี้ "แทบเป็นไปไม่ได้"
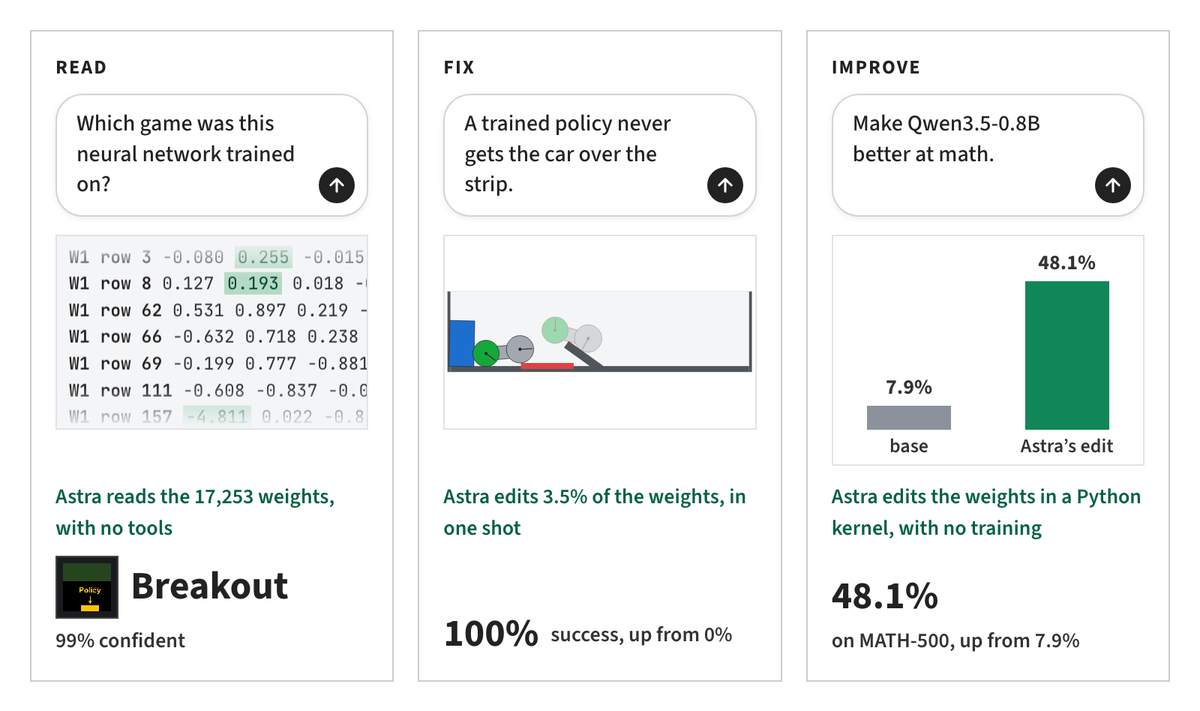
โมเดลที่ถูกแก้คือ Qwen3.5-0.8B โมเดลขนาดเล็กตระกูล Qwen ซึ่งผู้สร้างเตือนไว้เองว่ามักคิดวน พูดประโยคเดิมซ้ำจนหมดเวลาโดยไม่ได้ตอบ Astra ไล่หาจนเจอจุดที่ทำให้วน แล้วแก้ตัวเลขแค่ 0.016% หรือราว 1 ใน 6,000 ตัว ผลคือคะแนนชุดโจทย์คณิต MATH-500 ขึ้นจาก 7.9% เป็น 48.1% หรือราว 6 เท่า
แต่ต้องอ่านตัวเลขนี้ให้ถูก AI ตัวเล็กไม่ได้ฉลาดขึ้น มันแค่เลิกพูดวนจนได้ตอบโจทย์ที่ทำได้อยู่แล้ว เหมือนนักเรียนที่รู้วิธีทำ แต่เขียนบรรทัดเดิมซ้ำจนหมดเวลาสอบ พอทีมลองกับโมเดลเล็กอีกตัวที่ไม่ค่อยวน Astra ก็ทำให้เก่งขึ้นไม่ได้ งานนี้ยังเป็นบล็อกโพสต์ที่ผู้เขียนเรียกเองว่า "ผลเบื้องต้นมาก" ยังไม่ผ่านการตรวจโดยผู้ทรงคุณวุฒิ (peer review) และ Astra ใช้ Python กับการลองรันโมเดลหลายสิบรอบช่วย ไม่ได้แค่จ้องตัวเลข
ที่วงการตื่นเต้นเพราะถ้าวิธีนี้ใช้กับโมเดลใหญ่ได้จริง อาจแก้นิสัยแย่ ๆ ของ AI ได้โดยไม่ต้องเทรนใหม่ หรือตรวจหาปัญหาที่ซ่อนอยู่จากตัวเลขโดยตรง โพสต์นี้ขึ้นอันดับหนึ่งบน Hacker News แต่ผู้ใช้ทั่วไปยังไม่มีอะไรต้องทำ ถ้าอยากเห็นด้วยตา ลองหน้าทดลองบน Hugging Face ที่ให้โมเดลก่อนและหลังแก้แข่งกันตอบโจทย์ ตัวเลขทุกรอบ การทดลองที่ล้มเหลว และผลตรวจซ้ำอยู่ด้านล่าง
สรุปประเด็นสำคัญ
- เกิดอะไรขึ้น: Rikiya Takehi และทีมจาก MIT CSAIL ให้ GPT-6 Astra ของ OpenAI แก้ค่าน้ำหนักของ Qwen3.5-0.8B ตรง ๆ โดยไม่ใช้การเทรน แก้ 131,072 ตัวจากราว 800 ล้านตัว (0.016%) คะแนน MATH-500 ขึ้นจาก 7.9% เป็น 48.1% (เผยแพร่ 2 พ.ย. 2026)
- คะแนนขึ้นเพราะอะไร: เพราะโมเดลเลิกคิดวน สัดส่วนคำตอบที่วนจนชนเพดานความยาวลดจาก 93% เหลือราว 33% ไม่ใช่เพราะโมเดลรู้คณิตมากขึ้น ทีมลองกับ Gemma 3 270M ที่ไม่ค่อยวน แล้วทำให้เก่งขึ้นไม่ได้
- ข้อจำกัด: เป็นบล็อกโพสต์ ยังไม่ผ่าน peer review ทดลองกับโมเดลเล็กเท่านั้น และงานแก้ Qwen ใช้ Python กับการลองรันโมเดล 50 รอบช่วย ส่วนการทดลองหาโมเดลขี้ประจบจากตัวเลขล้วน ๆ ล้มเหลวทั้ง 4 ครั้ง
- ตรวจซ้ำได้: ทีมเปิดบันทึกการทดลองทั้งหมดและโมเดลที่แก้แล้ว Ahsen Khaliq จาก Hugging Face สร้างโมเดลขึ้นใหม่จากบันทึกและรันวัดซ้ำได้ 51.0% ใกล้กับตัวเลขในโพสต์
"ค่าน้ำหนัก" คืออะไร และทำไมอ่านยาก
โมเดลภาษาอย่าง ChatGPT หรือ Qwen ทำงานโดยเอาข้อความที่รับเข้ามาไปคูณและบวกกับตัวเลขชุดใหญ่ทีละชั้น ตัวเลขเหล่านั้นคือค่าน้ำหนัก ได้มาจากการเทรน ซึ่งเป็นกระบวนการที่คอมพิวเตอร์ปรับตัวเลขทีละนิดตามสูตรคณิตศาสตร์ (gradient descent) จนคำตอบดีขึ้น Qwen3.5-0.8B มีค่าน้ำหนักราว 800 ล้านตัว แบ่งเป็น 24 ชั้น
ปัญหาคือไม่มีใครเขียนตัวเลขพวกนี้ด้วยมือ จึงไม่มีป้ายบอกว่าตัวไหนทำอะไร งานสาขาที่พยายามแกะว่าข้างในโมเดลทำงานอย่างไร (mechanistic interpretability) ต้องใช้เครื่องมือเฉพาะทาง และมักต้องรันโมเดลจริงเพื่อดูว่าส่วนไหนทำงานตอนไหน ทีม MIT เรียกสิ่งที่ลองทำครั้งนี้ว่า Weight-Space Programming คือให้ AI ทั่วไปที่ไม่ได้ถูกฝึกมาเพื่องานนี้ อ่านและเขียนค่าน้ำหนักโดยตรงตามคำสั่งภาษาคน เหมือนอ่านและแก้โค้ดโปรแกรม
ภาพเปรียบมิกเซอร์เสียงใช้ได้ถึงแค่ตรงนี้: ปุ่มบนมิกเซอร์จริงมีหน้าที่เดียวชัดเจน แต่ค่าน้ำหนักทำงานเป็นกลุ่ม พฤติกรรมหนึ่งอย่าง เช่น การคิดวน อาจกระจายอยู่ในตัวเลขหลายหมื่นตัวที่ต้องแก้ไปพร้อมกันในทิศทางเดียวกัน ซึ่งเป็นสิ่งที่ Astra ทำ
Astra ทำอะไรกับ Qwen ทีละขั้น
ตามที่ทีมเขียนไว้ในโพสต์และในหน้าโมเดลบน Hugging Face:
- ทีมให้ Astra ใช้หน้าต่าง Python คล้ายโน้ตบุ๊กที่โหลดค่าน้ำหนักของ Qwen ไว้ (ไม่มีการ์ดจอ) พร้อมโจทย์ฝึกจากชุด GSM8K และ MATH (ไม่ใช่ชุดที่ใช้สอบจริง)
- Astra ได้สิทธิ์ "ลองรันโมเดล" (forward pass) จำกัดจำนวน คือ 10, 25 หรือ 50 ครั้งในแต่ละการทดลอง แต่ละครั้งให้โมเดลตอบโจทย์ได้สูงสุด 512 ข้อ ห้ามเทรนและห้ามใช้ข้อมูล gradient
- Astra สังเกตว่าโมเดลเดิมวนซ้ำจนชนเพดาน 32,768 โทเคน ใน 85 จาก 96 คำตอบแรกที่ลอง
- มันไล่จนพบว่าการวนมาจาก "ทิศทาง" หนึ่งที่ส่วน MLP ของชั้นที่ 15 และ 19 เขียนออกมา แล้วลบทิศทางนั้นออกจาก 64 คอลัมน์ในแต่ละชั้น รวม 131,072 ค่าน้ำหนัก
- ทีมวัดผลด้วยชุดสอบที่ Astra ไม่เคยเห็น โดยใช้การตั้งค่าการสุ่มคำตอบแบบเดียวกันทั้งก่อนและหลังแก้
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval (ทำตามคำสั่ง) | คำตอบที่ชนเพดานความยาว |
|---|---|---|---|---|
| ก่อนแก้ | 7.9% | 13.8% | 21.0% | 93.0% |
| แก้ด้วย 10 รอบ | 12.3% | 25.7% | 49.0% | 87.2% |
| แก้ด้วย 25 รอบ | 14.1% | 25.1% | 39.9% | 86.4% |
| แก้ด้วย 50 รอบ | 48.1% | 67.1% | 62.3% | 33.1% |
ที่มา: บล็อกของทีม MIT CSAIL (2 พ.ย. 2026) MATH-500 เป็นชุดโจทย์คณิตระดับแข่งขัน GSM8K เป็นโจทย์ปัญหาคณิตระดับประถม ส่วน IFEval วัดว่าโมเดลทำตามคำสั่งได้ครบไหม ตารางนี้ชี้ว่าคะแนนกระโดดจริงก็ต่อเมื่อการวนลดลงมาก (รอบ 50) และคะแนนนอกเรื่องคณิตอย่าง IFEval ก็ขึ้นด้วย เพราะการวนไม่ได้เกิดเฉพาะกับโจทย์คณิต
ทีมชี้ว่าวิธีลบ "ทิศทาง" เดียวออกจากค่าน้ำหนักนี้คล้ายเทคนิคที่นักวิจัยเคยใช้ลบพฤติกรรมบางอย่างของโมเดลมาก่อน ความใหม่จึงอยู่ที่ AI ทั่วไปหาจุดและลงมือแก้เอง ไม่ใช่ตัววิธีแก้
ตกลง AI ตัวเล็กฉลาดขึ้นจริงไหม
ไม่ใช่ และทีมวิจัยเขียนเรื่องนี้ไว้เอง: "การแก้อาการวนไม่เหมือนกับการทำให้โมเดลเก่งคณิตขึ้น มันแค่ทำให้โมเดลตอบจบในข้อที่คิดออกอยู่แล้ว"
เพื่อพิสูจน์ ทีมลองกับ Gemma 3 270M โมเดลที่เล็กกว่าราวหนึ่งในสามและแทบไม่วน (คำตอบชนเพดานแค่ 8.5%) Astra อ่านคำตอบที่ผิดแล้วพบแต่ความผิดพลาดธรรมดา เช่น คิดเลขผิดหรือแก้สมการผิดขั้น ไม่มีจุดเดียวให้ปิด การแก้แต่ละครั้งขยับคะแนนไม่เกินราว 1 จุด (6.8% ขึ้นสูงสุดเป็น 7.7%) และ Astra เองก็รายงานว่ายังสรุปไม่ได้ว่าดีขึ้นจริง ทีมสรุปว่า "การแก้ค่าน้ำหนักลบอุปสรรคที่บังความสามารถได้ แต่เพิ่มความสามารถที่โมเดลไม่มีไม่ได้"
มีอีกจุดที่ควรรู้: ตัวเลข 7.9% ของโมเดลเดิมวัดภายใต้การตั้งค่าของทีมวิจัย (temperature 0.6, presence penalty 1.5) หน้าโมเดลของ Qwen เองเตือนว่ารุ่น 0.8B "มีแนวโน้มติดวงวนในโหมดคิดมากกว่ารุ่นอื่น" และแนะนำให้ปรับค่าการสุ่มตามงาน ผู้ร่วมวงบน Hacker News บางคนจึงตั้งคำถามว่าคะแนนตั้งต้นต่ำเกินจริงหรือเปล่า ReadEval ยังไม่พบการทดสอบที่เทียบกับการแก้แบบง่ายกว่า เช่น ปรับค่าการสุ่มเพื่อลดการวน
การทดลองอื่นในโพสต์เดียวกัน
งานแก้ Qwen เป็นการทดลองที่ 8 จากทั้งหมด 8 ชุด ชุดก่อนหน้าใช้เครือข่ายเล็กกว่ามาก:
- อ่านค่าน้ำหนักแล้วบอกว่าเครือข่ายถูกฝึกเล่นเกมอะไร: เครือข่าย 17,253 ตัวเลข ที่ฝึกเล่นเกม Breakout, Pong, Pac-Man และ Freeway ฉบับตารางเล็ก Astra ตอบถูกทั้ง 4 ตัวโดยไม่ใช้เครื่องมือ และไม่ได้รับรายชื่อเกมให้เลือก
- บอกว่าโมเดลวาดภาพวาดรูปอะไร: ตอบถูกทั้งวงกลม สี่เหลี่ยม และสามเหลี่ยม แต่วาดออกมาเป็นเส้นขอบ ทั้งที่โมเดลจริงวาดรูปทึบ ทีมมองว่าข้อผิดนี้ชี้ว่า Astra อ่านโครงสร้างตัวเลข ไม่ได้แอบคำนวณผลลัพธ์
- ซ่อมรถที่ขึ้นทางลาดไม่ได้: เครือข่ายควบคุมรถที่ไม่เคยผ่านด่านเลย หลัง Astra แก้ 3.5% ของค่าน้ำหนักในครั้งเดียว รถผ่านครบทั้ง 1,024 รอบ
- เขียนเครือข่ายเล่นเกมขึ้นมาใหม่จากศูนย์: ในเกม Breakout, Seaquest และ Asterix เครือข่ายที่ Astra เขียนชนะเครือข่ายที่ฝึกด้วย PPO 100 ล้านก้าวทั้ง 3 เกม
- หาโมเดลขี้ประจบ: ทีมฝึก Gemma 3 270M สองชุด ชุดหนึ่งตอบตามจริง อีกชุดตอบตามที่ผู้ใช้เดา Astra ดูตัวเลขล้วน ๆ แล้ว บอกไม่ได้ทั้ง 4 ครั้ง จนทีมผ่อนกติกาให้ดูว่าส่วนต่าง ๆ ของโมเดลจับจ้องคำไหนตอนรัน จึงชี้ตัวขี้ประจบได้ถูกทั้ง 3 คู่
เชื่อผลนี้ได้แค่ไหน
ReadEval ให้คะแนนตามเกณฑ์ผลวัดที่เชื่อถือได้ 4 จาก 6 ข้อ อยู่ระดับ 🟡 พอใช้อ้างอิงได้
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ผ่าน | เปิดบันทึกทุกการทดลองบน GitHub (ทุกข้อความที่ส่งให้ Astra โค้ดที่รัน และผลวัด) และเผยแพร่โมเดลที่แก้แล้ว |
| บอกสภาพแวดล้อมครบ | ผ่าน | ระบุค่าการสุ่มคำตอบ เพดานโทเคน จำนวนรอบที่สุ่มต่อข้อ และระดับการคิดของ Astra ในแต่ละการทดลอง |
| วัดหลายรอบและบอกความแปรปรวน | ไม่ผ่าน | คะแนนเฉลี่ยหลายคำตอบต่อข้อ แต่การแก้แต่ละระดับรายงานผลเพียงชุดเดียว และไม่รายงานช่วงความคลาดเคลื่อน |
| เทียบอย่างยุติธรรม | ไม่ผ่าน | เทียบกับโมเดลเดิมที่วนจนแทบตอบไม่ได้ และไม่เทียบกับวิธีแก้การวนแบบอื่น |
| เป็นอิสระ | ผ่าน | ผู้วิจัยอยู่ MIT ไม่ได้ขาย Astra และมีคนนอกรันวัดซ้ำ |
| ยอมรับข้อจำกัด | ผ่าน | เขียนเองว่าเป็นผลเบื้องต้น และรายงานการทดลองที่ล้มเหลวด้วย |
การตรวจซ้ำจากคนนอก: Ahsen Khaliq จาก Hugging Face สร้างโมเดลที่แก้แล้วขึ้นใหม่จากบันทึกของทีม ตรวจว่าตัวเลขที่เปลี่ยนตรงกับที่ทีมประเมินทุกตัว แล้วรัน MATH-500 ครบ 500 ข้อ ข้อละ 4 คำตอบ ได้ 51.0% และคำตอบที่ชนเพดาน 31.6% ใกล้กับ 48.1% และ 33.1% ในโพสต์ แต่การรันของโมเดลเดิมในรอบนั้นเป็นการทดสอบสั้น 25 ข้อ (ได้ 5.0%) จึงยังไม่ใช่การวัดเทียบเต็มชุด
ลองเล่นเองได้ไหม
ได้ ถ้าอยากเห็นด้วยตา:
- หน้าทดลองบน Hugging Face (huggingface.co/spaces/akhaliq/weight-space-programming-demo): พิมพ์โจทย์ แล้วดูโมเดลเดิมวนซ้ำขณะที่โมเดลที่แก้แล้วตอบจบ
- โมเดลที่แก้แล้ว (huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming): สัญญาอนุญาต Apache 2.0 สำหรับนักพัฒนาที่อยากดาวน์โหลดไปรันเอง หน้าโมเดลบอกค่าที่ใช้และตัวอย่างโค้ดไว้
- บันทึกการทดลอง (github.com/RikiyaT/lm_understand-logs): ทุกข้อความที่ส่งให้ Astra และสิ่งที่มันตอบกลับ
เรื่องนี้คือ AI พัฒนา AI ด้วยกันเองหรือเปล่า
ยังห่างไกล ในโพสต์ ทีมวิจัยยกการพัฒนาตัวเองแบบวนซ้ำ (recursive self-improvement) เป็นหนึ่งในทางที่งานนี้ "อาจ" เปิดในอนาคต เพราะ AI ที่ตรวจ แก้ และปรับปรุงค่าน้ำหนักของตัวเองหรือของรุ่นใหม่ได้ เป็นเส้นทางที่ตรงกว่าการเขียนโค้ดสั่งเทรน แต่สิ่งที่เกิดจริงครั้งนี้คือ Astra แก้โมเดลอื่นที่เล็กกว่ามาก ในกรอบที่คนกำหนดทุกขั้น และแก้ได้แค่นิสัยเสียที่มีจุดชัดเจน
หัวข้อนี้เป็นเรื่องที่บริษัท AI เองก็จับตา ล่าสุด Anthropic เขียนในเอกสารขายหุ้นว่าโมเดลรุ่นต่อไปอาจแตะเกณฑ์ AI เร่งการพัฒนา AI ซึ่งพูดถึงการใช้ AI ช่วยวิจัยและสร้างโมเดลรุ่นถัดไป ไม่ใช่การแก้ค่าน้ำหนักตรง ๆ แบบงานนี้ ทั้งสองเรื่องจึงเป็นคนละระดับ แต่ชี้ไปทางเดียวกัน คือ AI เริ่มมีบทบาทในการปรับปรุง AI มากขึ้น
สิ่งที่แหล่งข่าวเล่าไม่เหมือนกัน
- ทำไมคะแนนขึ้น: The Register เขียนว่า Astra "ลดการคิดวนและทำให้คะแนนคณิตดีขึ้นถึง 6 เท่า" แต่ไม่ได้บอกว่าคะแนนขึ้นเพราะการวนลดลง และไม่ได้พูดถึงการทดลองกับ Gemma ที่ไม่สำเร็จ บล็อกต้นทางเขียนชัดกว่าว่าการแก้ครั้งนี้ไม่ได้เพิ่มความสามารถทางคณิต ReadEval ยึดตามบล็อกต้นทาง
- ใช้เครื่องมือหรือเปล่า: The Register เขียนว่า Astra "แค่แก้ตัวเลข" ของ Qwen แต่บล็อกระบุว่างานนี้ใช้หน้าต่าง Python และลองรันโมเดลได้ 50 รอบ ต่างจากการทดลองช่วงแรกที่ Astra อ่านตัวเลขโดยไม่ใช้เครื่องมือ
- ขนาดของผล: บทความหัวว่า "เลิกเทรนใหม่ได้แล้ว" (Forget retraining) ขณะที่ทีมวิจัยเองเรียกว่า "ผลเบื้องต้นมาก" และบอกว่ากำลังสร้างชุดวัดมาตรฐานเพื่อให้ผลแบบนี้ตรวจซ้ำได้อย่างเป็นระบบ
- คะแนนบน Hacker News: ตอนรวบรวมข้อมูล กระทู้ได้ราว 2,680 คะแนนและกว่า 800 ความเห็น ตัวเลขนี้ขยับตลอด
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
การทดลองนี้น่าสนใจจริง แต่สิ่งที่พิสูจน์ได้คือ AI หาและซ่อมนิสัยเสียของโมเดลเล็กได้ ไม่ใช่ทำให้ AI ฉลาดขึ้น จุดที่ ReadEval มองว่าใหม่จริงคือการทดลองช่วงแรกที่ Astra อ่านเครือข่ายเล็ก ๆ จากตัวเลขล้วนแล้วบอกได้ว่ามันทำอะไร และเขียนเครือข่ายเล่นเกมได้โดยไม่ต้องฝึก ส่วนงานแก้ Qwen ที่เป็นข่าวใหญ่ ใกล้กับเทคนิคที่นักวิจัยใช้กันอยู่แล้ว ต่างตรงที่ AI ทำเองทุกขั้น ข้อจำกัดยังชัด: ใช้กับโมเดลเล็ก ต้องลองรันหลายสิบรอบ ไม่ผ่าน peer review และหาโมเดลขี้ประจบจากตัวเลขล้วนไม่ได้ ข่าวดีคือทีมเปิดทุกอย่างให้ตรวจ และคนนอกรันซ้ำได้ใกล้เคียง ถ้าชุดวัดมาตรฐานที่ทีมกำลังทำออกมา และมีคนลองกับโมเดลขนาดใหญ่ได้ผลเหมือนกัน ตอนนั้นค่อยพูดได้ว่า AI เริ่มแก้ AI ได้จริง ตอนนี้จำไว้ประโยคเดียวพอ: AI ช่วยให้โมเดลเล็กเลิกพูดวน ไม่ได้สอนให้มันเก่งคณิต
แหล่งที่มา
- Takehi, Teoh, Zhang, Khattab (MIT CSAIL): Sparks of Weight-Space Programming (บล็อกงานวิจัย 2 พ.ย. 2026)
- RikiyaT/lm_understand-logs: บันทึกการทดลองทั้งหมด (GitHub)
- Hugging Face: Qwen3.5-0.8B ที่แก้แล้ว พร้อมผลรันวัดซ้ำ
- Hugging Face Spaces: หน้าทดลองเทียบโมเดลก่อนและหลังแก้
- Qwen: หน้าโมเดล Qwen3.5-0.8B (คำเตือนเรื่องการคิดวน)
- The Register: Forget retraining - AI can now tweak another AI's weights
- Hacker News: Astra can read and write weights to improve Qwen


