ตามรอยตัวเลขที่ ChatGPT, Gemini และ Claude ยกมา มีแค่ 4 ใน 10 ที่ย้อนถึงงานวิจัยที่พูดตรงกัน
Trakkr ตามลิงก์สถิติที่ผู้ช่วย AI 5 ตัวยกมา 1,285 ตัว พบราว 40% ที่ไปถึงงานวิจัยซึ่งพูดตรงกัน บางตัวที่ AI ทุกตัวตอบเหมือนกันไม่มีต้นทางเลย

สารบัญ (12 หัวข้อ)
- สรุปประเด็นสำคัญ
- Trakkr ทดลองอย่างไร
- ผลออกมาเป็นอย่างไร
- AI แต่งตัวเลขขึ้นมาเองหรือเปล่า
- ตัวเลขเพี้ยนไประหว่างทางได้อย่างไร
- สถิติซอมบี้ที่ AI ทั้งห้าตัวยกมาเหมือนกัน
- AI ตอบตรงกันแปลว่าถูกไหม
- วิธีเช็กตัวเลขที่ได้จาก AI
- ใช้กับคำตอบภาษาไทยด้วยไหม
- งานนี้เชื่อถือได้แค่ไหน
- สิ่งที่แหล่งข้อมูลไม่ตรงกัน
- บทวิเคราะห์จาก ReadEval
ลองถาม ChatGPT, Gemini, Claude, Perplexity และ AI Overviews ของ Google ว่า "เซลส์กี่เปอร์เซ็นต์ที่เลิกตามลูกค้าหลังติดตามไปแค่ครั้งเดียว" ทั้งห้าตัวตอบตรงกันว่า 44% และบางตัวแนบลิงก์อ้างอิงมาด้วย ฟังดูหนักแน่น แต่เมื่อทีมวิจัยของ Trakkr บริษัทที่ทำเครื่องมือติดตามว่า AI อ้างอิงเว็บไหน กดลิงก์ตามไปทีละทอด ปลายทางกลับเป็นบทความตัวอย่างผลงานของนักเขียนฟรีแลนซ์ ที่ไม่ได้อ้างงานวิจัยใดเลย
นี่คือจุดเริ่มของการทดลองชื่อ "Zombie stats" Trakkr ถามผู้ช่วย AI ทั้งห้าด้วยคำถามที่ต้องตอบเป็นตัวเลข แล้วสุ่มสถิติที่มีลิงก์อ้างอิงมาตามรอยทีละทอดจนกว่าจะเจอต้นทาง ผลคือมีเพียงราว 4 ใน 10 ที่ไปจบที่งานวิจัยซึ่งพูดเรื่องเดียวกันจริง บางส่วนเจองานวิจัยแต่ตัวเลขหรือบริบทเพี้ยนไประหว่างทาง ที่เหลือไปจบที่หน้าที่ตรวจไม่ได้ หรือไม่มีต้นทางเลย Trakkr เรียกตัวเลขกลุ่มสุดท้ายว่า "สถิติซอมบี้" คือตัวเลขที่ถูกเล่าต่อไม่รู้จบ ทั้งที่ไม่มีงานวิจัยอยู่ข้างใต้
นึกถึงข้อความส่งต่อในไลน์ที่ขึ้นต้นว่า "ผลวิจัยจากมหาวิทยาลัยดังพบว่า…" คนส่งต่อแทบไม่มีใครแต่งเอง AI ก็คล้ายกัน งานนี้พบว่าหน้าเว็บที่ AI อ้างมีตัวเลขนั้นอยู่จริง 82% แปลว่าส่วนใหญ่ AI ไม่ได้มั่วตัวเลขขึ้นมาเอง ปัญหาคือหน้าที่มันอ้างเกินครึ่งเป็นบล็อกของบริษัท ซึ่งก็หยิบตัวเลขมาจากที่อื่นอีกทอด ต่างจากข้อความในไลน์ตรงที่ AI มักแนบลิงก์มาให้ คุณจึงตามรอยต่อเองได้
ที่น่าคิดที่สุดคือ การที่ AI ทุกตัวตอบตรงกันไม่ได้แปลว่าตัวเลขนั้นถูก ตัวเลขหลายตัวที่ทั้งห้าตัวยกมาเหมือนกัน รวมถึง 44% ข้างต้น กลับหาต้นทางที่เป็นงานวิจัยไม่เจอเลย อย่างไรก็ตาม งานนี้ทำโดยบริษัทที่ขายเครื่องมือด้านนี้เอง ยังไม่ผ่านการตรวจทานจากนักวิจัยภายนอก และทดสอบด้วยคำถามภาษาอังกฤษจากตำแหน่งในสหรัฐฯ
ถ้าคุณใช้ตัวเลขจาก AI ทำรายงาน สไลด์ หรือโพสต์ ให้มองว่ามันเป็นเบาะแส ยังไม่ใช่แหล่งอ้างอิง กดลิงก์ดู ถ้าเป็นบล็อกหรือหน้ารวมสถิติให้ตามต่อจนเจองานวิจัยตัวจริง แล้วดูว่าสำรวจใคร กี่คน เมื่อไร วิธีเช็กทีละขั้น ตัวอย่างสถิติซอมบี้ และข้อจำกัดของงานนี้อยู่ด้านล่าง
สรุปประเด็นสำคัญ
- ใครทำ: Trakkr Research (Study 013) เขียนโดย Mack Grenfell เผยแพร่ 28 ต.ค. 2026 Trakkr เป็นบริษัทขายเครื่องมือวัดการมองเห็นแบรนด์ในคำตอบของ AI งานนี้ไม่ได้ตีพิมพ์ในวารสารและไม่ผ่าน peer review
- ทำอะไร: ถาม ChatGPT, Perplexity, Gemini, Claude และ Google AI Overviews ด้วยคำถาม 200 ข้อที่ต้องตอบเป็นตัวเลข ผ่าน API ของแต่ละบริษัท เปิดการค้นเว็บ ตั้งตำแหน่งในสหรัฐฯ ถามครั้งเดียวเมื่อ 25 ต.ค. 2026 แล้วตามรอยสถิติที่มีลิงก์ 1,285 ตัว ลึกได้ถึง 5 หน้า
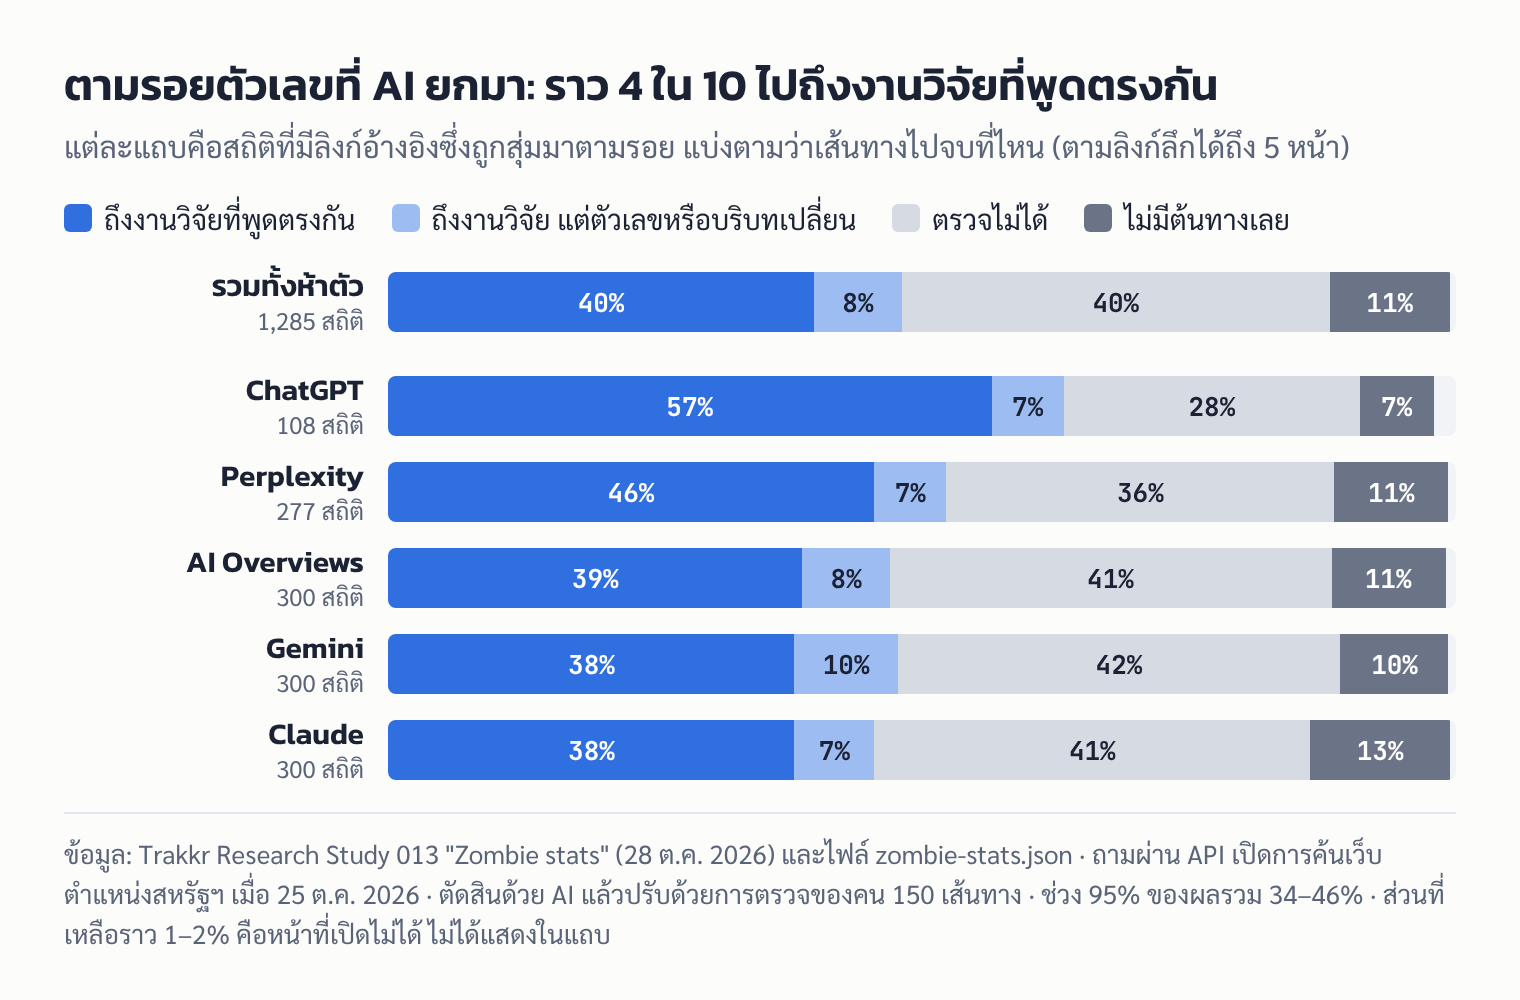
- ผลรวม: 40% ไปถึงงานวิจัยที่พูดตรงกัน (ช่วง 95% อยู่ที่ 34–46%) 8% เจองานวิจัยแต่ตัวเลขหรือบริบทเปลี่ยน 40% ตรวจไม่ได้ และ 11% ไม่มีต้นทางเลย
- รายตัว: ChatGPT ดีที่สุดที่ 57% และยกตัวเลขน้อยที่สุด อีกสี่ตัวอยู่ระหว่าง 38–46% ซึ่ง Trakkr บอกว่าใกล้กันเกินกว่าจะจัดอันดับ
- ตอบตรงกันไม่ได้แปลว่าถูก: ตัวเลขที่ AI ตั้งแต่ 3 ตัวขึ้นไปยกมาเหมือนกัน ไปถึงงานวิจัยที่พูดตรงกันแค่ 11 จาก 29 ตัว และมี 4 ตัวที่ AI ทั้งห้ายกมาแต่หาต้นทางไม่เจอ
- ความน่าเชื่อถือ: 🟡 พอใช้อ้างอิงได้ (3 จาก 6 ข้อตามเกณฑ์ของ ReadEval) วิธีการเปิดเผยละเอียดและมีช่วงความไม่แน่นอน แต่ผู้ทำได้ประโยชน์จากผลแบบนี้ และยังไม่มีใครภายนอกตรวจซ้ำ
Trakkr ทดลองอย่างไร
Trakkr ตั้งคำถาม 200 ข้อ แบ่งเป็นคำถามทั่วไป 160 ข้อใน 16 หัวข้อ เช่น การตลาด การขาย การเงินส่วนตัว โซเชียลมีเดีย และความปลอดภัยไซเบอร์ กับอีก 40 ข้อที่ถามถึง "สถิติดัง" ที่ทีมสงสัยอยู่แล้ว ซึ่งรายงานแยกต่างหาก คำว่า "สถิติ" ในงานนี้หมายถึงสัดส่วน อัตรา ค่าเฉลี่ย จำนวน หรือต้นทุนที่ AI พูดเหมือนเป็นข้อเท็จจริง ไม่นับคำแนะนำอย่าง "ควรออมเงิน 20% ของรายได้" และไม่นับราคาสินค้า
จากคำตอบทั้งหมด ทีมดึงสถิติออกมาได้ 3,167 ตัว ในจำนวนนี้ 2,419 ตัวมีลิงก์อ้างอิง แล้วสุ่มมาตามรอย ChatGPT ใช้ทุกตัวที่มี (108 ตัว) ส่วนตัวอื่นสุ่มไม่เกิน 300 ตัว รวม 1,285 ตัว การตามรอยคือเปิดหน้าที่ AI อ้าง หาตัวเลขในหน้านั้น แล้วตามแหล่งที่หน้านั้นอ้างต่อไป ลึกได้ถึง 5 หน้า ถ้าหน้าไหนเอ่ยชื่อแหล่งโดยไม่มีลิงก์ ทีมจะค้นหาเอง
ขั้นตัดสินว่าแต่ละเส้นทางไปจบที่ไหน Trakkr ให้โมเดล AI ตัวหนึ่งเป็นผู้ตัดสินทุกเส้นทาง ให้โมเดลที่เก่งกว่าตัดสินซ้ำ 300 เส้นทาง (ตรงกัน 82%) แล้วให้คนตรวจซ้ำ 150 เส้นทางที่สุ่มมา และให้คนที่สามชี้ขาดเมื่อผลไม่ตรงกัน จุดสำคัญคือ AI ผู้ตัดสินเข้มกว่าคนมาก ถ้าดูจาก AI ตัดสินอย่างเดียว จะมีแค่ 23% ที่ไปถึงต้นทาง แต่คนหาต้นทางเจอในหลายเส้นทางที่ AI พลาด Trakkr จึงปรับทุกตัวเลขด้วยผลตรวจของคน จนได้ 40%
ผลออกมาเป็นอย่างไร
| ผู้ช่วย AI | ไปถึงงานวิจัยที่พูดตรงกัน | ช่วง 95% | สถิติต่อคำตอบ | จำนวนที่ตามรอย |
|---|---|---|---|---|
| ChatGPT | 57% | 48–65% | 1.3 | 108 |
| Perplexity | 46% | 38–52% | 2.2 | 277 |
| Google AI Overviews | 39% | 32–46% | 4.8 | 300 |
| Gemini | 38% | 31–45% | 6.2 | 300 |
| Claude | 38% | 31–45% | 6.8 | 300 |
| รวมทั้งห้า | 40% | 34–46% | – | 1,285 |
ตัวเลขในตารางมาจากหน้ารายงานและไฟล์ข้อมูล zombie-stats.json ของ Trakkr ช่วง 95% บอกว่าค่าจริงน่าจะอยู่ระหว่างตัวเลขสองตัวนั้น ช่วงของสี่ตัวหลังซ้อนทับกันเกือบหมด Trakkr จึงไม่จัดอันดับกลุ่มนี้ ส่วน ChatGPT ทำได้ดีที่สุดพร้อมกับยกตัวเลขน้อยที่สุด ราว 1 ตัวต่อคำตอบ ขณะที่ Claude ยกเกือบ 7 ตัว พูดง่าย ๆ คือ ยิ่ง AI ใส่ตัวเลขเยอะ ก็ยิ่งมีตัวเลขที่ต้องตรวจเยอะ
เพื่อดูว่าผลนี้ไม่ได้เกิดจากคำถามที่ทีมเลือกเอง Trakkr ยังสุ่มสถิติ 300 ตัวจาก AI Overviews ที่ตอบคำค้นจริงในชีวิตประจำวันระหว่าง 25 ก.ย.–25 ต.ค. 2026 มาตามรอยแบบเดียวกัน ได้ผลใกล้กันที่ 40%
AI แต่งตัวเลขขึ้นมาเองหรือเปล่า
ส่วนใหญ่ไม่ใช่ หน้าที่ AI อ้างมีตัวเลขนั้นอยู่จริง 82% ของครั้ง ปัญหาอยู่ที่ต้นน้ำ เพราะมีเพียง 21% ของหน้าที่ถูกอ้างที่เป็นงานวิจัยต้นฉบับ ที่เหลือเป็นหน้าที่เล่าต่อ
| ประเภทหน้าที่ AI อ้างเป็นหน้าแรก | สัดส่วนของการอ้าง | ตามแล้วถึงงานวิจัยที่พูดตรงกัน |
|---|---|---|
| บล็อกของบริษัท | 54% | 37% |
| บริษัทวิจัยหรือผลสำรวจ | 13% | 62% |
| ข่าวหรือนิตยสาร | 10% | 37% |
| หน้ารวมสถิติ | 8% | 35% |
| หน่วยงานรัฐหรือองค์กรทางการ | 7% | 61% |
| อื่น ๆ | 8% | 41% |
แม้แต่หน้าที่เริ่มจากบริษัทวิจัยก็ยังพลาดเกือบ 4 ใน 10 ส่วนใหญ่เพราะรายงานฉบับเต็มต้องกรอกฟอร์มก่อนดาวน์โหลด Trakkr สรุปไว้ว่า "การอ้างอิงบอกว่า AI เจอตัวเลขที่ไหน ไม่ได้บอกว่าตัวเลขมาจากไหน"
ตัวเลขเพี้ยนไประหว่างทางได้อย่างไร
ในสถิติที่ตามไปถึงงานวิจัยได้ 17% เปลี่ยนไประหว่างทาง แต่ตัวเลขเปลี่ยนเองแค่ราว 1 ใน 4 ของกรณีที่เปลี่ยน (26%) ที่เหลือเป็นบริบทที่หายหรือเปลี่ยน ได้แก่ สิ่งที่วัด (20%) ปีที่สำรวจ (17%) แหล่งที่มา (16%) กลุ่มคนที่ถูกถาม (14%) และประเทศหรือพื้นที่ (4%)
ตัวอย่างที่ชัดที่สุดคือประโยค "94% ของความประทับใจแรกต่อเว็บไซต์มาจากการออกแบบ" ซึ่ง Google AI Overviews ตอบเป็นข้อเท็จจริง Trakkr ตามไปพบว่าต้นทางคืองานวิจัยของ Elizabeth Sillence และคณะ ในงานประชุม CHI ปี 2004 ReadEval เปิดอ่านงานวิจัยฉบับนั้นแล้ว พบว่าทีมวิจัยเฝ้าดูผู้หญิง 15 คนที่กำลังตัดสินใจเรื่องสุขภาพค้นข้อมูลบนเว็บ และตัวเลข 94% คือสัดส่วนของ "ความเห็นที่พูดถึงเหตุผลที่ไม่เชื่อหรือปฏิเสธเว็บไซต์สุขภาพ" ที่เกี่ยวกับการออกแบบ ไม่ใช่ความประทับใจแรกของคนทั่วไปต่อเว็บไซต์ทุกแบบ ระหว่างทาง ข่าวประชาสัมพันธ์ของบริษัทแห่งหนึ่งในปี 2018 และคอลัมน์นิตยสารธุรกิจในปี 2024 ค่อย ๆ ขยายความจนกลายเป็นประโยคที่ AI ยกมา
อีกตัวอย่างคือรายงานของ MIT NANDA ปี 2025 ที่ระบุว่าองค์กร 95% ไม่ได้ผลตอบแทนที่วัดได้จาก generative AI แต่ถูกเล่าต่อเป็น "โครงการนำร่อง AI 95% ล้มเหลว" ซึ่ง Trakkr ชี้ว่าไม่ใช่เรื่องเดียวกัน AI ทั้งห้าตัวยกตัวเลขนี้มา และ Trakkr จัดไว้ในกลุ่ม "เปลี่ยนไประหว่างทาง"
สถิติซอมบี้ที่ AI ทั้งห้าตัวยกมาเหมือนกัน
| ตัวเลขที่ AI ยกมา | ตามรอยแล้วเจออะไร |
|---|---|
| 44% ของเซลส์เลิกตามลูกค้าหลังติดตามครั้งเดียว | AI Overviews อ้างหน้ารวมสถิติของบริษัทขายแห่งหนึ่ง (ปี 2020) ซึ่งลิงก์ "ที่มา" ไปยังบทความตัวอย่างของนักเขียนฟรีแลนซ์ (ออนไลน์อย่างช้าปี 2017) บทความนั้นอ้างสไลด์ 2 ชุด รายการในบล็อก และข่าว 2 ชิ้น ไม่มีชิ้นไหนเป็นงานวิจัยเรื่องการติดตามลูกค้า เส้นทางอื่นก็จบแบบเดียวกัน |
| 90% ของผู้ใช้โซเชียลติดตามอย่างน้อยหนึ่งแบรนด์ | ถูกพูดโดยไม่มีแหล่งที่มา ไม่พบงานวิจัยที่มีตัวเลขนี้ |
| 75% ของคนค้นหาไม่เลื่อนไปเกินหน้าแรกของผลการค้นหา | ถูกเล่าต่อโดยไม่มีแหล่งที่มา มักอ้างหน้ารวมสถิติการตลาดเก่าที่ปัจจุบันไม่มีตัวเลขนี้แล้ว |
| หาลูกค้าใหม่แพงกว่ารักษาลูกค้าเดิม 5–25 เท่า | บทความ Harvard Business Review ปี 2014 ของ Amy Gallo ให้ช่วงนี้โดยขึ้นต้นว่า "ขึ้นอยู่กับว่าคุณเชื่องานวิจัยชิ้นไหน" แต่ไม่ได้ระบุชื่องานวิจัย |
ตัวเลข 44% มักมาคู่กับอีกประโยคดังว่า "80% ของการขายต้องติดตาม 5 ครั้งขึ้นไป" ซึ่งอยู่ในพาดหัวเดียวกันของบทความตัวอย่างนั้น ประโยคนี้มักอ้างว่ามาจากสมาคม National Sales Executives Association องค์กรที่สืบทอดต่อมาคือ Sales & Marketing Executives International (SMEI) เขียนไว้บนเว็บของตัวเองว่า สิ่งที่ใกล้เคียงที่สุดในคลังเอกสารคือแบบสำรวจสมาชิกสาขา Long Island นิวยอร์ก เมื่อปี 1942 ซึ่งมีผู้ตอบไม่ถึง 40 คน
AI ตอบตรงกันแปลว่าถูกไหม
ไม่จำเป็น Trakkr เทียบคำถาม 71 ข้อที่ AI ทั้งห้าตอบเป็นเปอร์เซ็นต์ พบว่า 28 ข้อได้ตัวเลขต่างกัน 4–5 แบบ และ 31 ข้อตัวเลขสูงสุดกับต่ำสุดห่างกันตั้งแต่ 20 จุดขึ้นไป เช่น คำถาม "นักการตลาดกี่เปอร์เซ็นต์ใช้เครื่องมือ marketing automation" ถามคำต่อคำในวันเดียวกัน AI Overviews ตอบ 49–51% ChatGPT ตอบ 62% Gemini ตอบ 70–79% Perplexity ตอบ 81% และ Claude ตอบ 96%
แต่ข้อที่ตอบตรงกันก็ไม่ได้น่าเชื่อกว่า AI ทั้งห้าให้ตัวเลขเดียวกันใน 10 ข้อ Trakkr ตามรอยได้ 5 ข้อ ไปถึงงานวิจัยที่พูดตรงกันแค่ 2 ข้อ และในสถิติ 29 ตัวที่ AI ตั้งแต่ 3 ตัวขึ้นไปยกมาเหมือนกัน มีแค่ 11 ตัวที่ไปถึงงานวิจัยที่พูดตรงกัน Trakkr สรุปว่า "AI ห้าตัวให้ตัวเลขเดียวกัน ไม่ได้แปลว่ามีห้าแหล่ง"
ข้อนี้สอดคล้องกับการทดลองของ ModelCompare ที่ ReadEval เคยเล่า ซึ่งพบว่าโมเดลจากหลายค่ายตอบคำถามปลายเปิดไปทางเดียวกันเกือบหมด เพราะเรียนจากข้อมูลชุดคล้ายกัน ความเห็นพ้องของ AI หลายตัวจึงอาจเป็นเสียงเดียวที่ดังจากหลายปาก
วิธีเช็กตัวเลขที่ได้จาก AI
Trakkr แนะนำไว้ดังนี้ ใช้ได้ทั้งในแชตบอตและใน AI Overviews
- กดลิงก์อ้างอิง แล้วกดต่ออีกทอด ถ้าหน้าที่ AI อ้างเป็นหน้ารวมสถิติหรือบล็อกของบริษัท ให้ใช้ลิงก์ในหน้านั้นไปต่อ ทำซ้ำจนเจองานวิจัยตัวจริง หรือจนไปต่อไม่ได้
- ดูว่าสำรวจใคร กี่คน และเมื่อไร การเปลี่ยนแปลงส่วนใหญ่ที่พบอยู่ในบริบท ไม่ใช่ตัวเลข เช่น ผลสำรวจของประเทศเดียว งานวิจัยอายุสิบปี หรือกลุ่มตัวอย่างแค่ 15 คน
- อย่าถือว่า AI หลายตัวตอบตรงกันคือการยืนยัน ตัวเลขที่ถูกยกมาซ้ำบ่อยที่สุดไม่ได้มีที่มาดีกว่าตัวเลขอื่น
- เมื่อจะใช้จริง ให้อ้างงานวิจัยต้นทาง ไม่ใช่หน้าที่เล่าต่อ และถ้าหาต้นทางไม่เจอ ให้ตัดตัวเลขนั้นออก หรือเขียนให้ชัดว่ายังยืนยันไม่ได้
ถ้าคุณเป็นคนเผยแพร่ตัวเลขเอง เช่น ทำผลสำรวจขององค์กร Trakkr แนะนำให้วางวิธีการ ขนาดกลุ่มตัวอย่าง วันที่ และลิงก์ไว้ในหน้าเดียวกับตัวเลข เปิดผลหลักไว้ในหน้าที่ไม่ต้องกรอกฟอร์ม และคอยดูว่า AI อ้างหน้าไหนเมื่อพูดถึงตัวเลขของคุณ เพราะหลายครั้งเป็นหน้าที่คัดลอกไปพร้อมตัวเลขเก่า
ใช้กับคำตอบภาษาไทยด้วยไหม
ยังไม่ยืนยัน Trakkr ถามเป็นภาษาอังกฤษผ่าน API โดยตั้งตำแหน่งในสหรัฐฯ และส่วนที่ตรวจกับคำค้นจริงก็นับเฉพาะคำค้นภาษาอังกฤษ ReadEval ยังไม่พบงานที่ทดสอบแบบเดียวกันกับคำถามภาษาไทย ผลในแอปที่คุณใช้อาจต่างไปด้วย เพราะ Trakkr ระบุเองว่าแอปอาจตอบต่างจาก API ส่วนวิธีเช็กด้านบนใช้ได้กับทุกภาษา
งานนี้เชื่อถือได้แค่ไหน
ReadEval ให้คะแนนตามเกณฑ์ "ผลวัดที่เชื่อถือได้" 6 ข้อ
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ไม่ผ่าน | เปิดไฟล์ข้อมูลสรุป คำถาม และเส้นทางที่ตรวจด้วยคน แต่ไม่เปิดเส้นทางทั้ง 1,285 เส้น และไม่ระบุชื่อหน้าที่เล่าต่อ |
| บอกสภาพแวดล้อมครบ | ไม่ผ่าน | บอกว่าใช้ API เปิดการค้นเว็บ ตำแหน่งสหรัฐฯ และวันที่ถาม แต่ไม่ระบุรุ่นของโมเดลแต่ละตัว และไม่บอกว่าโมเดลที่ใช้เป็นผู้ตัดสินคือรุ่นไหน |
| วัดหลายรอบและบอกความแปรปรวน | ผ่าน | ถามแค่ครั้งเดียว แต่สุ่มตัวอย่างหลายร้อยตัวต่อผู้ช่วย บอกช่วง 95% ทุกตัวเลข และตรวจซ้ำด้วยคน |
| เทียบอย่างยุติธรรม | ผ่าน | ใช้คำถามเดียวกันคำต่อคำกับทุกตัวในวันเดียวกัน และยอมบอกว่าสี่ตัวหลังจัดอันดับไม่ได้ |
| เป็นอิสระ | ไม่ผ่าน | Trakkr ขายเครื่องมือที่บอกว่า AI อ้างหน้าไหนของแบรนด์ หน้ารายงานจบด้วยการชวนสมัครใช้ และยังไม่มีบุคคลที่สามตรวจซ้ำ |
| ยอมรับข้อจำกัด | ผ่าน | เขียนหัวข้อ "Where it falls short" แยกไว้ ระบุว่าใช้ API ไม่ใช่แอป ถามวันเดียว ใช้ AI ตัดสิน และนับแหล่งที่ติดฟอร์มว่า "ตรวจไม่ได้" ไม่ใช่ "ไม่มี" |
รวม 3 จาก 6 ข้อ ป้าย 🟡 พอใช้อ้างอิงได้ ภาพรวมที่ว่าตัวเลขจาก AI จำนวนมากย้อนไปไม่ถึงงานวิจัยมีหลักฐานรองรับ และตัวอย่างที่ ReadEval ตรวจเอง (งานวิจัย CHI 2004 และหน้าของ SMEI) ตรงกับที่ Trakkr เล่า แต่ตัวเลข 40% ขึ้นกับการปรับด้วยผลตรวจของคน 150 เส้นทาง ข้อมูลของ Trakkr เองระบุว่าคนกับ AI ผู้ตัดสินเห็นตรงกันแค่ 62% ของเส้นทางที่ตรวจ ตัวเลขนี้จึงควรอ่านเป็นช่วง 34–46% มากกว่าค่าที่แน่นอน และต้องจำไว้ว่า 40% ที่ "ตรวจไม่ได้" ไม่ได้แปลว่าผิด แค่ยืนยันไม่ได้
สิ่งที่แหล่งข้อมูลไม่ตรงกัน
- ที่มาของ "80% ต้องติดตาม 5 ครั้ง": VentureBeat (Stewart Rogers, ส.ค. 2014) เขียนว่าสถิติชุดนี้ "แต่งขึ้นทั้งหมด" และสมาคม National Sales Executive Association ไม่มีอยู่จริง แต่ SMEI ตอบโต้บนเว็บของตัวเองว่าสมาคมนี้คือชื่อเดิมของ SMEI และต้นทางคือแบบสำรวจปี 1942 ที่มีผู้ตอบไม่ถึง 40 คน Trakkr เล่าตามฉบับของ SMEI ReadEval ยึดฉบับของ SMEI เช่นกันเพราะเป็นข้อมูลจากองค์กรเอง แต่ข้อสรุปไม่ต่างกันมาก คือไม่มีงานวิจัยที่หนักแน่นรองรับตัวเลขนี้
- จำนวนคำตอบและจำนวนที่ตรวจด้วยคน: หน้ารายงานเขียนว่าได้คำตอบ 1,000 คำตอบ (200 ข้อ × 5 ตัว) ส่วนไฟล์ข้อมูลระบุ 800 ซึ่งตรงกับคำถามทั่วไป 160 ข้อ × 5 ตัว ส่วนการตรวจด้วยคน หน้ารายงานบอกทั้ง 150 และ 180 เส้นทาง ไฟล์ข้อมูลระบุว่า 150 เส้นทางเป็นการสุ่มเพื่อปรับตัวเลข และอีก 30 เส้นทางเป็นกรณีที่ยกมาแสดงในรายงาน ReadEval ใช้ 150 ตามที่ใช้คำนวณผลจริง
- สื่ออื่น: ณ 29 ต.ค. 2026 ReadEval ยังไม่พบสื่อใหญ่รายงานงานนี้ ข้อมูลหลักจึงมาจาก Trakkr เพียงแหล่งเดียว ส่วนที่ตรวจกับแหล่งอื่นได้คือตัวอย่างรายตัว
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
ตัวเลขที่ AI ให้มาพร้อมลิงก์คือจุดเริ่มต้นของการตรวจ ไม่ใช่จุดจบ
สิ่งที่งานนี้แสดงได้ดีคือ ปัญหาไม่ได้อยู่ที่ AI แต่งตัวเลขขึ้นเองเป็นหลัก แต่อยู่ที่อินเทอร์เน็ตเต็มไปด้วยหน้าที่เล่าตัวเลขต่อกันโดยไม่มีใครย้อนกลับไปดูต้นทาง แล้ว AI ก็หยิบหน้าเหล่านั้นมาตอบด้วยน้ำเสียงมั่นใจเท่ากับตัวเลขที่มีงานวิจัยรองรับ ลิงก์อ้างอิงจึงให้ความรู้สึกว่าตรวจแล้ว ทั้งที่มันบอกแค่ว่า AI เจอตัวเลขที่ไหน ReadEval ประเมินว่าคนที่ได้รับผลมากที่สุดคือคนทำรายงาน สไลด์นำเสนอ และคอนเทนต์ ซึ่งมักใช้ตัวเลขประเภทการตลาดและการขายแบบที่งานนี้ทดสอบ และตัวเลขที่หยิบมาจาก AI ก็จะถูกเผยแพร่ต่อจนกลายเป็นหน้าที่ AI รุ่นต่อไปอ้างอีกที ส่วนผลรายตัว เช่น ChatGPT ได้ 57% หรือ Claude ยกตัวเลขมากที่สุด ไม่ควรใช้เลือกว่าจะเชื่อ AI ตัวไหน เพราะทุกตัวยกตัวเลขที่ไม่มีต้นทาง และงานนี้มาจากบริษัทที่ได้ประโยชน์จากข้อสรุปว่า "ต้องคอยดูว่า AI อ้างหน้าไหน" ทางที่ใช้ได้จริงคือนิสัยง่าย ๆ ข้อเดียว ก่อนใช้ตัวเลขจาก AI ให้ตามไปจนเจองานวิจัยตัวจริง และอ่านว่าสำรวจใคร กี่คน เมื่อไร ถ้าตามไม่ถึง ก็อย่าใช้
แหล่งที่มา
- Trakkr Research: Zombie stats (Study 013) โดย Mack Grenfell, 28 ต.ค. 2026
- Trakkr: ไฟล์ข้อมูลสรุป zombie-stats.json (รายตัว ประเภทหน้า วิธีการ)
- Sillence และคณะ: Trust and Mistrust of Online Health Sites (CHI 2004)
- SMEI: Sales Statistics – How many calls to close a sale?
- VentureBeat: These incredible sales stats everyone cites are actually completely false (ส.ค. 2014)
- Harvard Business Review: The Value of Keeping the Right Customers (Amy Gallo, 2014)


