แชตบอตพูดลื่นแต่ตอบผิด ดูฉลาดพอ ๆ กับบอตที่ห้วนแต่ถูก ผู้ร่วมทดลอง 8 ใน 10 ไม่ทันเห็นข้อผิด
งานวิจัย Radboud University พบว่าแชตบอตที่พูดลื่นแต่แต่งข้อมูลถูกมองว่าฉลาดพอ ๆ กับบอตที่ตอบห้วนแต่ถูก และผู้ร่วมทดลองถึง 80% ไม่เห็นข้อผิด

สารบัญ (10 หัวข้อ)
ลองนึกภาพแฟนหนังสือ The Lord of the Rings ที่นั่งอ่านบทสนทนาระหว่างคนกับแชตบอต แชตบอตตอบคำถามเรื่องหนังสือได้ลื่นไหล สุภาพ เหมือนคุยกับเพื่อนที่รู้จริง แต่ในคำตอบมีข้อมูลที่แต่งขึ้นแทรกอยู่อย่างแนบเนียน งานวิจัยใหม่จาก Radboud University ในเนเธอร์แลนด์พบว่า ผู้เข้าร่วมถึง 80% หรือ 8 ใน 10 คน ไม่ทันสังเกตข้อมูลผิดเลย ทั้งที่ทุกคนถูกคัดมาแล้วว่ารู้เรื่องหนังสือเล่มนี้
ทีมของ Marianna de Sá Siqueira นักวิจัยด้านการสื่อสาร ให้ผู้เข้าร่วม 395 คนอ่านบทสนทนาที่เขียนไว้ล่วงหน้าคนละหนึ่งแบบ แชตบอตในบทสนทนามีทั้งแบบพูดลื่นเหมือนคน และแบบตอบสั้นห้วนเป็นทางการ แต่ละแบบมีทั้งรุ่นที่ตอบถูกทั้งหมดและรุ่นที่แอบแต่งข้อมูล ไม่แปลกที่แชตบอตพูดลื่นและตอบถูกได้คะแนนดีที่สุด จุดที่น่าสนใจคือแชตบอตที่พูดลื่นแต่ให้ข้อมูลผิด ถูกมองว่าฉลาดพอ ๆ กับแชตบอตที่พูดห้วนแต่ตอบถูก
เรื่องนี้คล้ายพนักงานขายที่พูดเก่ง เรามักเชื่อไปเองว่าคนที่อธิบายคล่องต้องรู้จริง Barbara Müller หนึ่งในผู้เขียนงานวิจัยบอกว่า เมื่อข้อความฟังสละสลวยและเป็นธรรมชาติ คนจะคิดเองว่าผู้พูดฉลาด แล้วรู้สึกว่าไม่ต้องตรวจต่อ แต่ภาพเปรียบนี้ใช้ได้ไม่หมด เพราะคนที่พูดเรื่องหนึ่งได้คล่องมักผ่านเรื่องนั้นมาจริง ส่วน Tibor Bosse ผู้เขียนอีกคนชี้ว่าโมเดลภาษาถูกฝึกให้เขียนประโยคที่ฟังดูเป็นไปได้และอ่านง่ายเป็นหลัก ความถูกต้องเป็นเรื่องรอง ความลื่นของแชตบอตจึงไม่ได้บอกว่ามันรู้จริง
เรื่องนี้เกี่ยวกับทุกคนที่ถาม ChatGPT, Gemini หรือแชตบอตอื่นเพื่อหาข้อมูล ข่าวดีคือข้อมูลผิดยังทำให้คะแนนความฉลาดลดลงจริง แต่ภาษาที่สวยชดเชยส่วนที่เสียไปได้มาก นักวิจัยมองว่าคำเตือนบรรทัดเดียวที่แชตบอตแสดงไว้ไม่พอ และเสนอให้บังคับบริษัทเทคโนโลยีแสดงให้ผู้ใช้เห็นว่าระบบไม่แน่ใจคำตอบไหน
ระหว่างนี้คุณป้องกันตัวเองได้ อย่าวัดความน่าเชื่อจากภาษาที่สวย สั่งให้แชตบอตบอกตรง ๆ เมื่อไม่แน่ใจ และขอแหล่งที่มาแล้วเปิดดูเอง โดยเฉพาะเรื่องเงิน สุขภาพ และกฎหมาย ด้านล่างมีรายละเอียดการทดลอง ข้อจำกัดของตัวเลข 80% และคำสั่งที่คุณลองใส่ในแชตบอตได้
สรุปประเด็นสำคัญ
- งานวิจัย: "Users' perception of chatbot language fluency and hallucination" โดย Marianna A. de Sá Siqueira, Tibor Bosse และ Barbara C. N. Müller จาก Radboud University ตีพิมพ์ในวารสาร Computers in Human Behavior: Artificial Humans เล่ม 10 บทความหมายเลข 100412 เปิดให้อ่านฟรี (CC BY 4.0) มหาวิทยาลัยประกาศข่าวเมื่อ 29 ต.ค. 2026
- ผล: ภาษาที่ลื่นทำให้แชตบอตดูฉลาดขึ้น ข้อมูลผิดทำให้ดูฉลาดน้อยลง และแชตบอตที่ "ลื่นแต่ผิด" ได้คะแนนความฉลาดไม่ต่างอย่างมีนัยจากแชตบอตที่ "ห้วนแต่ถูก" ส่วนความรู้สึกว่าฉลาดก็สัมพันธ์กับความไว้ใจ ความพอใจ และความตั้งใจจะใช้ต่อ
- ข้อจำกัด: ผู้เข้าร่วมอ่านบทสนทนาที่เขียนไว้ก่อน ไม่ได้คุยกับแชตบอตเอง ใช้หัวข้อเดียว และตัวเลข 80% มาจากข่าวของมหาวิทยาลัย ไม่อยู่ในบทคัดย่อ
- ความน่าเชื่อถือ: 🟡 พอใช้อ้างอิงได้ (3 จาก 6 ข้อตามเกณฑ์ของ ReadEval) ออกแบบการทดลองชัดและใช้สถิติหลายแบบ แต่ ReadEval ยังเปิดบทความฉบับเต็มไม่ได้
เขาทดลองอย่างไร
บทคัดย่อของงานระบุว่าเป็นการทดลองแบบ 2 x 2 ระหว่างกลุ่ม (between-subjects) ผู้เข้าร่วม 395 คน แต่ละคนเห็นบทสนทนาระหว่างผู้ใช้กับแชตบอตที่เขียนไว้ล่วงหน้าเพียงแบบเดียว หัวข้อคือ The Lord of the Rings และข่าวของมหาวิทยาลัยระบุว่าผู้เข้าร่วมถูกคัดล่วงหน้าว่ามีความรู้พื้นฐานเรื่องหนังสือ ตัวแปรที่เปลี่ยนมีสองอย่าง คือความลื่นของภาษา (สูงหรือต่ำ) และการหลอน (hallucination) หรือการให้ข้อมูลที่แต่งขึ้น (มีหรือไม่มี)
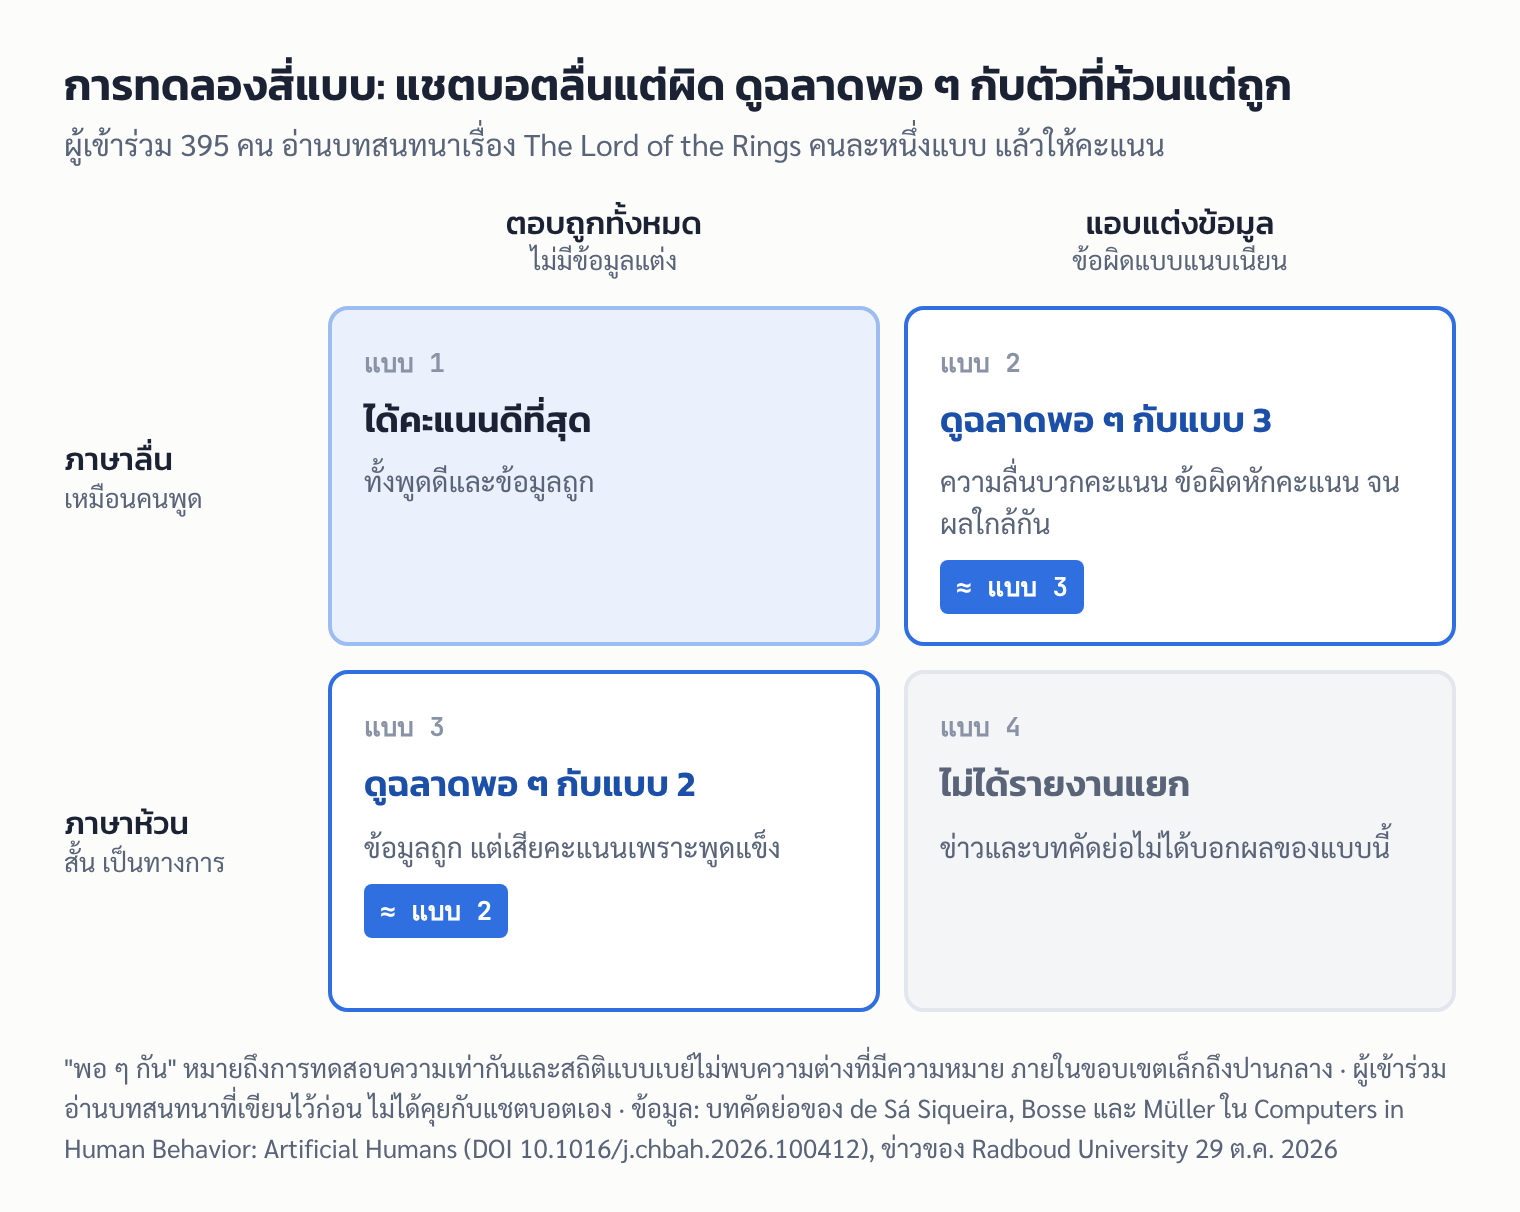
| แบบ | ภาษา | ข้อมูล | ผลตามข่าวและบทคัดย่อ |
|---|---|---|---|
| 1 | ลื่น เหมือนคน | ถูกทั้งหมด | ได้คะแนนดีที่สุด |
| 2 | ลื่น เหมือนคน | แอบแต่งบางส่วน | ถูกมองว่าฉลาดพอ ๆ กับแบบ 3 |
| 3 | สั้น ห้วน เป็นทางการ | ถูกทั้งหมด | ถูกมองว่าฉลาดพอ ๆ กับแบบ 2 |
| 4 | สั้น ห้วน เป็นทางการ | แอบแต่งบางส่วน | ข่าวและบทคัดย่อไม่ได้ระบุผลของแบบนี้แยกไว้ |
สิ่งที่วัดคือความฉลาดที่ผู้ใช้รับรู้ (perceived intelligence) แล้วดูต่อว่าความรู้สึกนี้สัมพันธ์กับความไว้ใจ ความพอใจในการใช้งาน และความตั้งใจจะใช้แชตบอตอีกหรือไม่ ข่าวของมหาวิทยาลัยใช้คำว่าแชตบอตแบบ 2 ถูกมองว่า "ฉลาดและน่าคุย" (intelligent and pleasant) พอ ๆ กับแบบ 3
ผลที่ได้แปลว่าอะไร
บทคัดย่อแยกผลไว้เป็นสมมติฐาน 4 ข้อ
- ภาษาลื่นทำให้ดูฉลาดขึ้น: ยืนยัน
- ข้อมูลผิดทำให้ดูฉลาดน้อยลง: ยืนยัน แปลว่าผู้ใช้ไม่ได้มองข้ามข้อผิดทั้งหมด
- ภาษาลื่นช่วย "กลบ" ผลของข้อมูลผิดมากเป็นพิเศษ: ไม่ยืนยัน พูดง่าย ๆ คือความลื่นไม่ได้ทำให้ข้อผิดเสียคะแนนน้อยลง แต่ทั้งสองอย่างมีผลแยกกัน ReadEval อธิบายง่าย ๆ ว่าความลื่นบวกคะแนนเข้ามา ข้อมูลผิดหักคะแนนออกไป และในการทดลองนี้สองแรงหักล้างกันจนแบบ 2 กับแบบ 3 ได้ผลใกล้กัน
- ความรู้สึกว่าฉลาดสัมพันธ์กับความไว้ใจ ความพอใจ และความตั้งใจใช้ต่อ: ยืนยัน
ข้อที่ทำให้ผล "พอ ๆ กัน" หนักแน่นกว่าการบอกว่า "หาความต่างไม่เจอ" คือทีมใช้การทดสอบความเท่ากัน (equivalence test) และสถิติแบบเบย์ (Bayesian) ซึ่งบทคัดย่อระบุว่าไม่พบความต่างที่มีความหมายระหว่างสองแบบนี้ ภายในขอบเขตความต่างระดับเล็กถึงปานกลาง
ตัวเลข 80% มาจากไหน
ตัวเลขนี้มาจากข่าวของ Radboud University ซึ่งเขียนว่าผู้เข้าร่วม "มากถึง 80 เปอร์เซ็นต์" ไม่สังเกตเห็นข้อผิดเลย ส่วนบทคัดย่อของบทความไม่ได้พูดถึงตัวเลขนี้ ReadEval จึงยังตอบไม่ได้ว่า
- 80% คิดจากผู้เข้าร่วมทั้ง 395 คน หรือเฉพาะคนที่ได้อ่านแบบที่มีข้อมูลผิด
- วัดการ "สังเกตเห็น" อย่างไร เช่น ถามตรง ๆ หลังอ่าน หรือให้ชี้จุดผิด
- ข้อมูลที่แต่งขึ้นในบทสนทนาเป็นเรื่องอะไร และ "แนบเนียน" แค่ไหน
บทความฉบับเต็มเปิดให้อ่านฟรีบน ScienceDirect แต่เว็บไซต์ปฏิเสธการเข้าถึงจากเครื่องมือของ ReadEval ข้อมูลวิธีการทดลองในข่าวนี้จึงมาจากบทคัดย่อ (ผ่านฐานข้อมูล OpenAlex) และข่าวของมหาวิทยาลัย
ทำไมคนเชื่อคำที่พูดลื่น
Bosse อธิบายในข่าวของมหาวิทยาลัยว่า "เมื่อก่อนคนบ่นว่าแชตบอตน่ารำคาญและไม่รู้อะไรเลย ตอนนี้มันพูดฉลาดจนเราเชื่อเร็วเกินไป" และมองว่าคำเตือนบรรทัดเดียวตอนเริ่มแชตแก้ปัญหาไม่ได้ เพราะบริษัทคงไม่บอกเองในทุกคำตอบว่าระบบไม่แน่ใจ ถ้าแชตบอตแสดงความลังเลออกมาเอง คนจะไม่หลงเชื่อข้อมูลผิดว่าเป็นความจริง
งานนี้ไม่ใช่งานแรกที่ชี้ไปทางเดียวกัน
- คำอธิบายยิ่งยาว คนยิ่งมั่นใจ: งาน "What large language models know and what people think they know" ของ Mark Steyvers และคณะ ในวารสาร Nature Machine Intelligence (มกราคม 2025) พบว่าผู้ใช้มักประเมินความแม่นของคำตอบจากโมเดลภาษาสูงเกินจริง และคำอธิบายที่ยาวขึ้นทำให้คนมั่นใจขึ้น แม้คำตอบจะไม่ได้แม่นขึ้น เมื่อทีมปรับคำอธิบายให้สะท้อนความมั่นใจจริงของโมเดล ช่องว่างนี้ก็แคบลง ซึ่งสนับสนุนข้อเสนอของทีม Radboud เรื่องการแสดงความไม่แน่ใจ
- ทำไมโมเดลชอบเดา: บทความ "Why Language Models Hallucinate" ของ Adam Tauman Kalai และคณะจาก OpenAI (กันยายน 2025) เสนอว่าการฝึกและการให้คะแนนโมเดลส่วนใหญ่ให้รางวัลกับการเดามากกว่าการยอมรับว่าไม่รู้ คล้ายข้อสอบที่ตอบมั่วยังมีโอกาสได้คะแนน แต่เว้นว่างได้ศูนย์แน่นอน
ลองทำอะไรได้บ้าง
งานวิจัยนี้ไม่ได้ทดสอบวิธีป้องกันตัว ข้อด้านล่างจึงเป็นคำแนะนำของ ReadEval ที่ตั้งตามข้อสรุปของงาน
- อย่าวัดจากภาษา: คำตอบที่เรียบเรียงสวยไม่ได้แปลว่าถูก ถ้าเป็นเรื่องที่คุณจะนำไปใช้ต่อ ให้ตรวจข้อเท็จจริงสำคัญอย่างน้อยหนึ่งจุดกับแหล่งอื่น
- ขอแหล่งที่มาแล้วเปิดดูจริง: แชตบอตอาจแต่งชื่อแหล่งอ้างอิงขึ้นเองได้ การมีลิงก์จึงยังไม่พอ ต้องเปิดดูว่าหน้านั้นพูดแบบที่แชตบอตอ้างจริงหรือไม่
- ระวังเป็นพิเศษกับเรื่องที่คุณรู้น้อย: ในการทดลอง ขนาดคนที่รู้เรื่องหนังสือยังพลาดถึง 80% ตามข่าวของมหาวิทยาลัย
- สั่งให้บอกเมื่อไม่แน่ใจ: ใส่คำสั่งด้านล่างไว้ในการตั้งค่าที่แชตบอตใช้กับทุกแชต
คำสั่งนี้ ReadEval เขียนเอง ไม่ใช่ถ้อยคำจากงานวิจัย
ถ้าคุณไม่แน่ใจข้อมูลส่วนไหน ให้บอกตรง ๆ ว่าไม่แน่ใจ แยกให้เห็นว่าส่วนไหนเป็นข้อเท็จจริงที่ตรวจสอบได้ และส่วนไหนเป็นการคาดเดา ห้ามแต่งชื่อ ตัวเลข วันที่ หรือแหล่งอ้างอิงขึ้นเอง ถ้าไม่รู้ให้ตอบว่าไม่รู้ และเมื่อให้ข้อเท็จจริงสำคัญ ให้บอกแหล่งที่มาที่ฉันเปิดตรวจเองได้If you are unsure about any part of an answer, say so plainly. Separate facts that can be checked from guesses. Never invent names, numbers, dates or references. If you don't know, say you don't know. For key facts, name a source I can open and check myself.ใส่ใน ChatGPT: ตามหน้าช่วยเหลือ "ChatGPT Custom Instructions" ของ OpenAI บนเว็บหรือแอปเดสก์ท็อปไปที่ Settings > Personalization บนแอป iOS และ Android ไปที่ Settings > Customize ChatGPT ตรวจว่าเปิด Enable customization อยู่ แล้ววางคำสั่งในช่อง Custom Instructions (เว็บ help.openai.com ปฏิเสธการเข้าถึงจากเครื่องมือของ ReadEval ขั้นตอนนี้จึงอ้างตามที่ ReadEval เคยตรวจไว้ในข่าวเมื่อ 26 ต.ค. 2026)
ใส่ใน Gemini: ตามหน้าช่วยเหลือ "Customize Gemini's responses with your instructions" ของ Google
- บนเว็บ (gemini.google.com): Menu > Settings & help > Personal Intelligence > Instructions for Gemini > Add + พิมพ์คำสั่ง แล้วกด Submit
- บนแอป Android: แตะ Menu > รูปโปรไฟล์หรือตัวอักษรย่อของคุณ > Personal Intelligence > Instructions for Gemini > Add + พิมพ์คำสั่ง แล้วกด Submit
ข้อควรระวัง: ReadEval ประเมินว่าคำสั่งนี้ช่วยได้บางส่วนเท่านั้น เพราะโมเดลอาจบอกว่า "มั่นใจ" ในเรื่องที่ผิดก็ได้ งานของ Steyvers และคณะที่ทำให้ช่องว่างความมั่นใจแคบลง เป็นการปรับคำอธิบายตามค่าความมั่นใจภายในของโมเดล ซึ่งผู้ใช้ทั่วไปมองไม่เห็น ไม่ใช่การพิมพ์สั่งในแชต ส่วนใครอยากใส่คำสั่งอื่นควบคู่ เช่น คำสั่งห้ามแชตบอตเออออตาม ดูได้ในข่าวงานวิจัยของ Georgia Tech ที่ ReadEval ลงไว้ก่อนหน้า
ใช้กับผู้ใช้ชาวไทยได้แค่ไหน
ข่าวของมหาวิทยาลัยและบทคัดย่อไม่ได้ระบุว่าผู้เข้าร่วมเป็นคนชาติใด หรือบทสนทนาเป็นภาษาอังกฤษหรือดัตช์ ReadEval จึงยืนยันไม่ได้ว่าผลจะออกมาเท่ากันกับคนไทยที่คุยกับแชตบอตเป็นภาษาไทย สิ่งที่พอบอกได้คือกลไกที่งานนี้ชี้ คือคนใช้ความลื่นของภาษาเป็นสัญญาณว่าผู้พูดฉลาด ไม่ได้ผูกกับภาษาใดภาษาหนึ่ง แต่นั่นเป็นการประเมินของ ReadEval ไม่ใช่ผลที่งานนี้ทดสอบ
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- คุยเองหรืออ่านบทสนทนา: Tech Xplore เขียนว่าผู้เข้าร่วม "คุยกับ" แชตบอตหนึ่งในสี่แบบ แต่ข่าวของมหาวิทยาลัยบอกว่าผู้เข้าร่วม "ได้เห็น" บทสนทนา และบทคัดย่อระบุชัดว่าเป็น "บทสนทนาที่กำหนดไว้ล่วงหน้า" ที่ผู้เข้าร่วมสังเกต ReadEval ยึดตามบทคัดย่อ
- ใครควรแสดงความไม่แน่ใจ: Tech Xplore สรุปว่า Bosse "เสนอ" ให้บริษัทเทคโนโลยีแสดงความไม่แน่ใจ แต่คำพูดในข่าวของมหาวิทยาลัยหนักกว่านั้น คือควร "บังคับ" (oblige) บริษัทให้ทำ ReadEval ยึดคำพูดต้นฉบับ
- วันที่ตีพิมพ์: ข้อมูลใน Crossref ระบุว่าเล่ม 10 เป็นฉบับเดือนธันวาคม 2026 ส่วนฉบับออนไลน์เปิดให้อ่านภายใต้ CC BY 4.0 ตั้งแต่ 21 ต.ค. 2026 ก่อนมหาวิทยาลัยประกาศข่าวราวหนึ่งสัปดาห์
ความน่าเชื่อถือของผลวัด
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ไม่ผ่าน | ReadEval ยังยืนยันไม่ได้ว่าทีมเปิดบทสนทนาทั้งสี่แบบและข้อมูลดิบให้คนอื่นทดลองซ้ำ |
| บอกสภาพแวดล้อมครบ | ผ่าน | บทคัดย่อบอกรูปแบบการทดลอง จำนวนผู้เข้าร่วม หัวข้อ และตัวแปรที่เปลี่ยนชัดเจน |
| วัดหลายรอบและบอกความแปรปรวน | ผ่าน | ใช้กลุ่มตัวอย่าง 395 คน พร้อมการทดสอบความเท่ากันและสถิติแบบเบย์ ไม่ได้ดูแค่ค่าเฉลี่ย |
| เทียบอย่างยุติธรรม | ไม่ผ่าน | สี่แบบควบคุมตัวแปรได้ดี แต่การอ่านบทสนทนาที่เขียนไว้ก่อนในหัวข้อเดียว ยังห่างจากการใช้แชตบอตจริง |
| เป็นอิสระ | ผ่าน | ทีมมหาวิทยาลัยไม่ได้ขายแชตบอตหรือผลิตภัณฑ์ที่เกี่ยวข้อง |
| ยอมรับข้อจำกัด | ไม่ผ่าน | ReadEval เปิดส่วนข้อจำกัดในบทความฉบับเต็มไม่ได้ จึงให้ผ่านไม่ได้ |
รวม 3 จาก 6 ข้อ อยู่ในระดับ 🟡 พอใช้อ้างอิงได้ ถ้าบทความฉบับเต็มเปิดเผยบทสนทนาและวิธีวัดการสังเกตข้อผิด คะแนนอาจสูงขึ้น
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
ภาษาที่สวยของแชตบอตเป็นเรื่องของสำนวน ไม่ใช่หลักฐานว่าข้อมูลถูก งานนี้ไม่ได้บอกว่าคนแยกแชตบอตที่ตอบผิดไม่ออกเลย เพราะข้อมูลผิดยังทำให้คะแนนลดลงจริง แต่บอกว่าความลื่นของภาษาชดเชยส่วนที่เสียไปได้มากพอจนแชตบอตที่แต่งข้อมูลดูดีเท่ากับแชตบอตที่ตอบถูกแต่พูดห้วน ซึ่งน่ากังวลกว่า เพราะแชตบอตที่คนใช้กันทุกวันวันนี้ล้วนพูดลื่นแทบทั้งหมด ข้อจำกัดสำคัญคือผู้เข้าร่วมเป็นคนอ่านบทสนทนา ไม่ใช่คนถามเอง และตัวเลข 80% ที่ถูกพาดหัวยังไม่มีรายละเอียดวิธีวัดในข้อมูลที่ ReadEval เข้าถึงได้ ReadEval เห็นด้วยกับทีมวิจัยว่าคำเตือนบรรทัดเดียวไม่พอ แต่ระหว่างที่บริษัทยังไม่แสดงความไม่แน่ใจในแต่ละคำตอบ ภาระตรวจสอบยังอยู่ที่ผู้ใช้ หลักจำง่าย ๆ คือ ยิ่งคำตอบฟังน่าเชื่อ ยิ่งควรเปิดแหล่งที่มาดูเอง
แหล่งที่มา
- Radboud University: Fluent language makes a hallucinatory chatbot just as credible as a curt, flawless one (29 ต.ค. 2026)
- Computers in Human Behavior: Artificial Humans: Users' perception of chatbot language fluency and hallucination (de Sá Siqueira, Bosse, Müller)
- OpenAlex: บทคัดย่อและข้อมูลการเปิดให้อ่านฟรีของบทความ (DOI 10.1016/j.chbah.2026.100412)
- Crossref: ข้อมูลเล่ม วันที่ และสัญญาอนุญาตของบทความ
- Tech Xplore: ข่าวงานวิจัยของ Radboud เรื่องแชตบอตพูดลื่นแต่ตอบผิด
- Nature Machine Intelligence: What large language models know and what people think they know (Steyvers และคณะ, 2025)
- arXiv: Why Language Models Hallucinate (Kalai และคณะ, OpenAI, 2025)
- OpenAI Help: ChatGPT Custom Instructions
- Gemini Apps Help: Customize Gemini's responses with your instructions


