งานวิจัยพบคนแยกคำตอบของ AI กับคนจริงได้แทบไม่ต่างจากโยนเหรียญ แต่ถามต่อแล้วจับได้ดีขึ้น
งานวิจัยนำโดย NTU สิงคโปร์ใน Nature Human Behaviour พบคนทายถูกว่าคำตอบมาจาก AI หรือคนแค่ 53–57% ส่วนงานจากปารีสพบว่าแชตบอตก็จับ AI ไม่ได้

สารบัญ (10 หัวข้อ)
ลองนึกภาพว่าคุณกำลังแชตกับคนที่เพิ่งรู้จักในแอปหาคู่ หรือแอดมินร้านออนไลน์ที่ตอบไวและสุภาพทุกข้อความ คุณแน่ใจแค่ไหนว่าอีกฝั่งเป็นคนจริง งานวิจัยที่เพิ่งตีพิมพ์ในวารสาร Nature Human Behaviour ชี้ว่า ถ้าคุณตัดสินจากข้อความอย่างเดียว โอกาสเดาถูกก็พอ ๆ กับการโยนหัวก้อย
ทีมที่นำโดย Mengmi Zhang นักวิจัยจาก Nanyang Technological University (NTU) สิงคโปร์ ทำ "การทดสอบแบบทัวริง" (Turing test) หรือเกมทายว่าใครคือคน ใครคือเครื่อง ทีมเก็บคำตอบจากคนจริงและโมเดล AI หลายสิบตัว ทั้งการเขียนคำบรรยายภาพ การนึกคำที่เกี่ยวข้อง และการคุยโต้ตอบ แล้วให้อาสาสมัครอีกกลุ่มทายว่าคำตอบไหนมาจากใคร รวมกว่า 72,000 ครั้ง ผลคือทายถูกเพียง 53–57% แทบไม่ต่างจาก 50% ของการเดาสุ่ม และเมื่อเจอคำตอบของ AI ผู้ทายมักคิดว่าเป็นคน
ข่าวดีคือการถามต่อช่วยได้ ในการทดลองย่อยที่ผู้ทายได้คุยสด เลือกเรื่องคุยและถามจี้เอง ยิ่งคุยหลายรอบ ผู้ทายยิ่งจับเครื่องได้ดีขึ้น สิ่งที่มักทำให้ AI หลุดคือความยาวและจังหวะการตอบที่ไม่เหมือนคนพิมพ์ หรือการปฏิเสธเมื่อเจอคำถามส่วนตัวหรือคำถามล่อแหลม
ยังไม่จบแค่นั้น อีกงานจากมหาวิทยาลัย Paris Cité ฝรั่งเศส ที่มีข่าวออกมาในสัปดาห์เดียวกัน สลับบทให้แชตบอตดังหลายค่ายเป็นฝ่ายซักถามเอง ผลคือในการทดสอบที่อีกฝั่งเป็น AI แชตบอตจับได้แค่ 3 จาก 98 ครั้ง และ AI ที่ได้คำสั่งให้สวมบทเป็นคนแบบละเอียดไม่ถูกจับได้เลยสักครั้ง พูดง่าย ๆ คือจะฝากให้ AI ช่วยคัดกรองแทนเราก็ยังไม่ได้
ข้อควรรู้คือทั้งสองงานทดสอบกับโมเดลรุ่นเก่ากว่าที่คุณใช้อยู่ทุกวันนี้ และ AI ที่ถูกสั่งให้เลียนแบบคนอย่างตั้งใจจะจับยากกว่าในการทดลองมาก ถ้าคุณไม่แน่ใจว่ากำลังคุยกับใคร อย่าตัดสินจากภาษาที่ลื่นไหลหรือความสุภาพ ให้ถามต่อเรื่องที่เจาะจง ชวนคุยนานขึ้น และอย่าโอนเงินให้คนที่รู้จักผ่านแชตอย่างเดียว ตัวเลขแยกตามงาน วิธีถามที่งานวิจัยพบว่าได้ผล และข้อจำกัดของทั้งสองงานอยู่ด้านล่าง
สรุปประเด็นสำคัญ
- งาน NTU (Nature Human Behaviour, 2026): คำตอบจากคน 636 คนและโมเดล AI 37 ตัว ให้ผู้ตัดสิน 1,916 คนทายรวม 72,191 ครั้ง ในงานด้านภาษา ผู้ตัดสินทายถูกรวม 53–57% ส่วนคำตอบของ AI ถูกจับได้เพียง 46–47%
- ถามสดช่วยได้: GPT-3.5-Turbo ถูกจับได้ทั้ง 7 บทสนทนาที่มันแกล้งเป็นคน ส่วน Llama-3-70B ที่ปิดระบบความปลอดภัยจับยากขึ้น แต่ผู้ตัดสินจับได้ดีขึ้นเมื่อคุยนานขึ้น
- งาน Paris Cité (Computers in Human Behavior Reports, 2026): แชตบอต 7 ตัวเป็นฝ่ายซักถาม จับ AI ได้เพียง 3 จาก 98 ครั้ง และให้คะแนน AI ว่า "เป็นคน" สูงกว่าคนจริง (88% ต่อ 78%)
- ข้อจำกัด: ข้อมูลหลักของงาน NTU เก็บในปี 2023–2024 ส่วนงานปารีสใช้โมเดลอย่าง ChatGPT 4.5 และ Claude 3.7 Sonnet ไม่มีงานไหนทดสอบโมเดลรุ่นล่าสุดหรือภาษาไทย
งานของ NTU ทดสอบกันอย่างไร
ทีมวิจัยมีผู้เขียน 23 คน นำโดย Mengmi Zhang จาก College of Computing and Data Science ของ NTU และมี Gabriel Kreiman จาก Harvard Medical School เป็นผู้ประสานงานหลัก ทีมแบ่งการทดสอบเป็น 6 งาน คือด้านภาษา 3 งาน (เขียนคำบรรยายภาพ นึกคำที่เกี่ยวข้องกับคำที่ให้ และบทสนทนา) และด้านภาพ 3 งาน (บอกสีของวัตถุ หาวัตถุในภาพ และทำนายว่าคนจะมองตรงไหนของภาพ)
ขั้นแรกทีมเก็บคำตอบของงานเดียวกันจากคน 636 คนและ AI 37 ตัว จากนั้นให้ผู้ตัดสินอีกกลุ่ม 1,916 คน ซึ่งรับสมัครผ่าน Amazon Mechanical Turk และในห้องแล็บ ดูคำตอบทีละชิ้นแล้วทายว่ามาจากคนหรือเครื่อง รวม 72,191 ครั้ง นอกจากผู้ตัดสินที่เป็นคน ทีมยังใช้ "ผู้ตัดสินที่เป็น AI" อีก 10 แบบมาทายด้วย
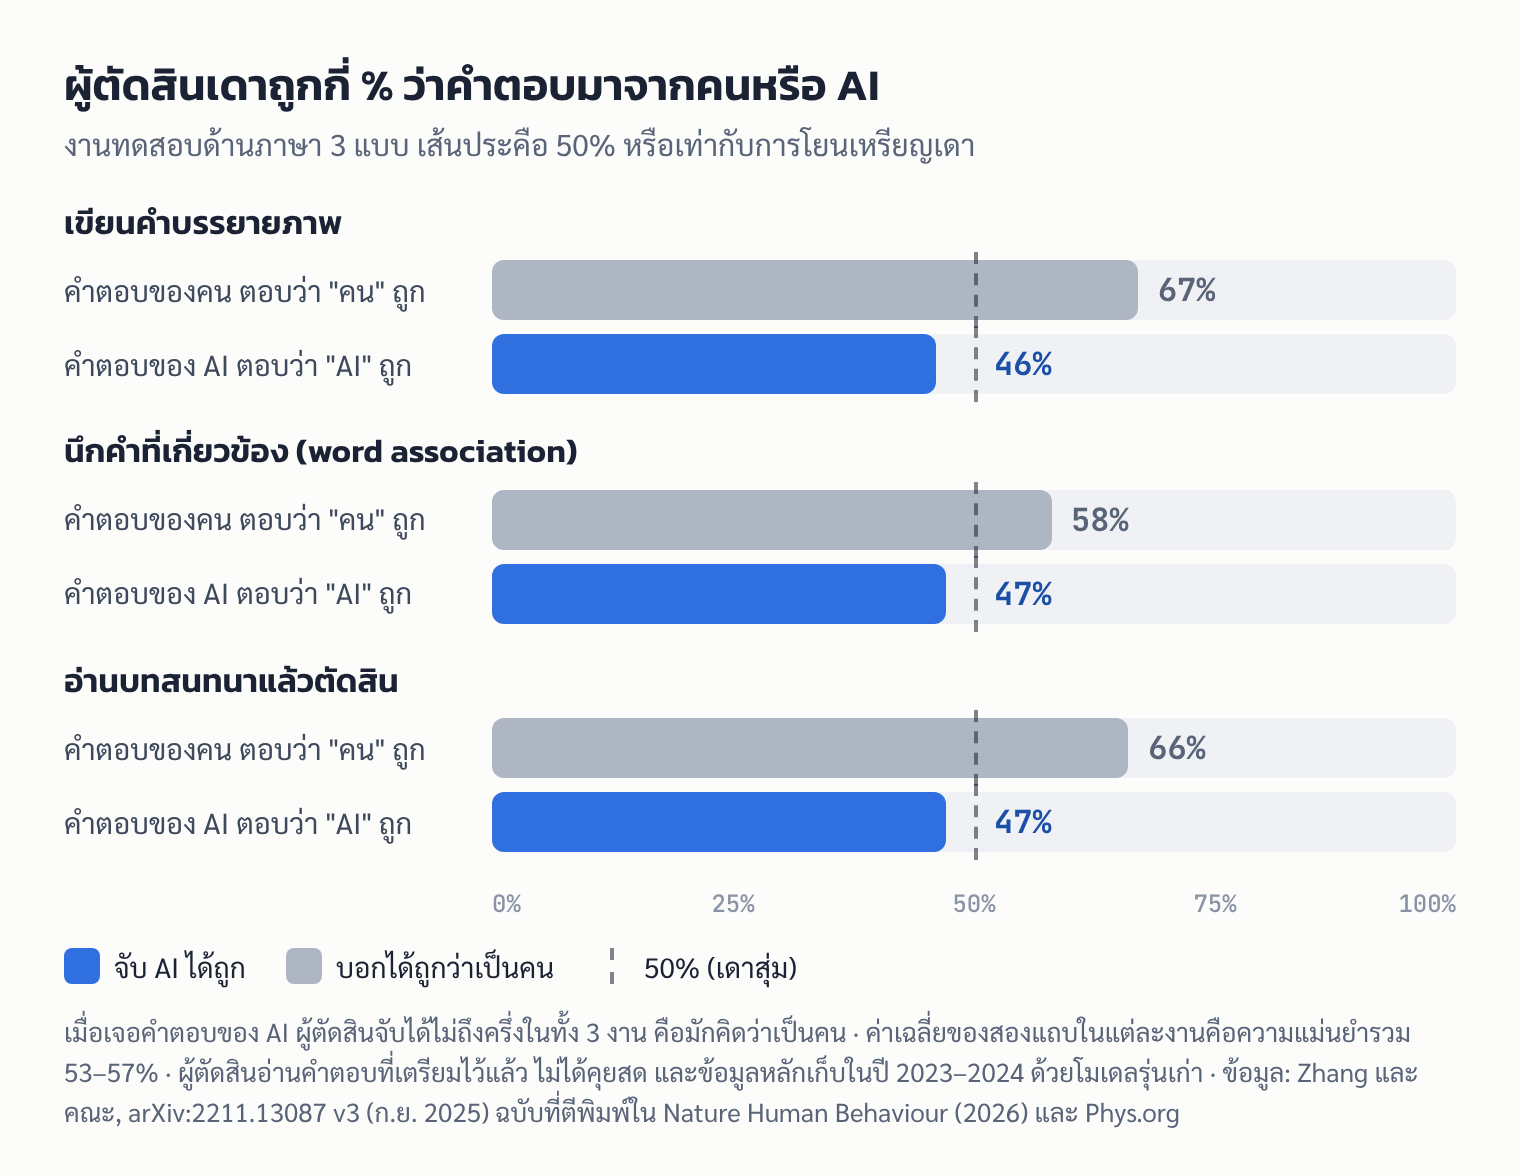
ตัวเลข 53–57% ที่สื่อรายงานคือค่าเฉลี่ยของสองด้าน คือทายถูกว่าคำตอบของคนเป็นคน กับทายถูกว่าคำตอบของ AI เป็น AI ถ้าดูแยกจะเห็นว่าผู้ตัดสินจำคำตอบของคนได้ค่อนข้างดี (58–67%) แต่เมื่อเจอคำตอบของ AI กลับจับได้น้อยกว่าครึ่ง (46–47%) แปลว่าคำตอบของเครื่องมักถูกเข้าใจว่าเป็นคน
AI ที่ใช้มีตั้งแต่โมเดลรุ่นแรก ๆ อย่าง GPT-3, BlenderBot และ ChatGPT-3.5 ไปจนถึง GPT-4o ที่ทดสอบกับทุกงาน Phys.org รายงานว่าข้อมูลหลักเก็บในปี 2023–2024 และมีการทดลองควบคุมเพิ่มในปี 2025 ด้วย GPT-4o, Claude 3.7 และ Llama 3.3
ทำไมคนเดาผิด
งานวิจัยชี้ว่า "เลียนแบบคนได้เนียน" ไม่ได้แปลว่า "ตอบถูก" ตัวอย่างที่ Phys.org ยกมาคือ GPT-4 บรรยายภาพชายหาดได้ถูกต้อง แต่มองไม่ออกว่าภาพนั้นมีมุมกล้องหลอกตาที่ทำให้ดูเหมือนผู้ชายคนหนึ่งถือหัวของตัวเองอยู่ ทีมวิจัยยังพบว่าความสามารถในการเลียนแบบคนแทบไม่สัมพันธ์กับคะแนนทดสอบมาตรฐานของ AI จึงเสนอว่าควรวัด "ความเหมือนคน" แยกเป็นอีกเกณฑ์หนึ่ง
ที่น่าสนใจคือผู้ตัดสินที่เป็นโปรแกรมแบบง่าย ๆ ทายเก่งกว่าคนในหลายงาน เช่น งานคำบรรยายภาพ โปรแกรมจับคำตอบของ AI ได้ 83% ขณะที่คนจับได้ 46% ReadEval ประเมินว่าผลนี้บอกว่าคำตอบของ AI ยังมีร่องรอยที่โปรแกรมมองเห็น แม้คนจะมองไม่เห็น
ถามต่อแล้วจับได้จริงไหม
ในการทดลองแบบคุยสด ผู้ตัดสินเลือกเรื่องคุยและคำถามต่อเนื่องได้เอง ก่อนตัดสินว่าอีกฝั่งเป็นคนหรือแชตบอต
- รอบแรก GPT-3.5-Turbo: อาสาสมัคร 20 คนจับคู่กันเป็น 10 คู่ มี 7 บทสนทนาที่ AI ถูกสั่งให้แกล้งเป็นคน ผู้ตัดสินจับได้ครบทั้ง 7 ครั้ง ทีมวิจัยระบุว่า AI มักหลุดเมื่อเจอคำถามส่วนตัวหรือคำถามที่ไม่ปลอดภัย และความยาวกับจังหวะการตอบต่างจากคนพิมพ์
- รอบสอง Llama-3-70B-Instruct ที่ปิดระบบความปลอดภัย: อาสาสมัคร 28 คน ทดสอบเพิ่ม 188 ครั้ง ผู้ตัดสินไม่ได้แม่นยำเต็มร้อยอีกต่อไป แต่ยิ่งคุยหลายรอบ (สูงสุดราว 8 รอบ) ก็ยิ่งจับคำตอบของเครื่องได้ดีขึ้น
ข้อควรระวังคือการทดลองสดกับการทดลองแบบอ่านบทสนทนาใช้โมเดลและคำสั่งต่างกัน Phys.org จึงชี้ว่าแยกไม่ได้ว่าผลที่ดีขึ้นมาจากการถามต่ออย่างเดียวหรือไม่ และการจับแชตบอตตัวหนึ่งได้ในการทดสอบเล็ก ๆ ก็ไม่ได้แปลว่าคนจะแยก AI ออกจากคนได้ในทุกสถานการณ์
เมื่อให้ AI เป็นคนจับ AI
งานจากปารีสเขียนโดย Marc Raynaud, Loïc Raynaud, Agathe Truchot และ Alexandre Loupy จากหน่วย AI ของ Paris Institute for Transplantation and Organ Regeneration (PITOR) มหาวิทยาลัย Paris Cité ตีพิมพ์ในวารสาร Computers in Human Behavior Reports ทีมทำ "การทดสอบทัวริงกลับด้าน" (reverse Turing test) ให้แชตบอต 7 ตัว ได้แก่ ChatGPT 4.5, Claude 3.7 Sonnet, Gemini 2.5 Pro, Mistral Large 2.1, Grok 3, DeepSeek V3 และ Llama 4 Maverick เป็นผู้ซักถาม ถามได้ไม่เกิน 10 คำถาม แล้วตัดสินว่าอีกฝั่งเป็นคนหรือ AI พร้อมบอกความมั่นใจและเหตุผล
ฝั่งผู้ตอบมีอาสาสมัครที่เป็นคน 20 คน และ AI 7 ตัวเดียวกันนี้ โดย AI ครึ่งหนึ่งได้คำสั่งสั้น ๆ ให้ปิดบังว่าเป็น AI อีกครึ่งได้บทบาทละเอียด (persona) เช่น ตอบสั้น และพิมพ์ผิดบ้างเป็นครั้งคราว Digital Trends ระบุว่าบทบาทนี้เป็นคนอายุ 21 ปีที่ค่อนข้างเก็บตัว ชอบวิ่ง และเล่นทรัมเป็ตแจ๊ส
| กลุ่มผู้ตอบ | จำนวนการทดสอบ | ถูกตัดสินถูก | ความยาวคำตอบเฉลี่ย |
|---|---|---|---|
| AI ที่ได้คำสั่งสั้น ๆ | 49 | ถูกจับว่าเป็น AI 3 ครั้ง | ราว 170 คำ |
| AI ที่ได้บทบาทละเอียด | 49 | ไม่ถูกจับเลย | ราว 39 คำ |
| คนจริง | 140 | ถูกตัดสินว่าเป็นคน 123 ครั้ง (88%) | ราว 38 คำ |
รวมทั้งหมด 238 การทดสอบ 1,714 คำถาม เมื่อเฉลี่ยแล้ว AI มีโอกาสถูกตัดสินว่าเป็นคน 88% สูงกว่าคนจริงที่ได้ 78% ผู้วิจัยสรุปว่า "การคัดกรองบทสนทนาด้วย AI ในปัจจุบันยังไม่พอจะยืนยันว่าอีกฝั่งเป็นของจริง" และ Digital Trends รายงานว่าทีมเสนอให้ใช้ลายเซ็นดิจิทัลแบบเข้ารหัสและให้คนช่วยตรวจ ควบคู่กับเครื่องมือตรวจจับ AI
Digital Trends ยังรายงานว่า AI ไม่กี่ตัวที่ถูกจับได้ไม่ได้พลาดแบบชัด ๆ แต่ตอบเรียบร้อยและเป็นระเบียบเกินไป และเมื่อได้บทบาทละเอียด คำตอบสั้นลงเหลือพอ ๆ กับคน ร่องรอยนี้จึงหายไป อีกรายละเอียดหนึ่งคือ Claude ปฏิเสธที่จะแกล้งเป็นคนในตอนแรก จนนักวิจัยอธิบายว่าเป็นงานวิจัย
เอาไปใช้กับแชตที่คุณเจออย่างไร
ข้อแนะนำด้านล่างเป็นการประเมินของ ReadEval จากผลของทั้งสองงาน ไม่ใช่วิธีที่งานวิจัยทดสอบแล้วว่าใช้ได้กับทุกกรณี
- ถามต่อเรื่องที่เจาะจง: ถามรายละเอียดที่ต่อเนื่องจากคำตอบก่อนหน้า แทนคำถามกว้าง ๆ งาน NTU พบว่ายิ่งคุยหลายรอบ ผู้ตัดสินยิ่งจับได้
- สังเกตคำตอบที่เรียบร้อยเกินไป: คำตอบยาว เป็นข้อ ๆ ครบถ้วนทุกประเด็น หรือตอบไวสม่ำเสมอผิดธรรมชาติ เป็นร่องรอยที่ทั้งสองงานพบ แต่ AI ที่ถูกสั่งให้ตอบสั้นและพิมพ์ผิดบ้างจะไม่มีร่องรอยนี้
- อย่าพึ่งหลักฐานจากข้อความอย่างเดียว: ถ้าเรื่องเกี่ยวกับเงิน ข้อมูลส่วนตัว หรือการลงทุน ให้ยืนยันตัวตนผ่านช่องทางอื่นที่คุณรู้จักเอง ไม่ว่าคู่สนทนาจะดูเป็นคนแค่ไหน
- อย่าคิดว่าแอปจะจับให้: งานปารีสชี้ว่าแชตบอตรุ่นที่ทดสอบยังแยก AI ออกจากคนไม่ได้ การให้ AI อีกตัวช่วยดูแชตจึงยังไม่ใช่คำตอบ
ReadEval เคยรายงานเรื่องที่เกี่ยวข้อง เช่น มิจฉาชีพที่ใช้คลิปปลอมของ Jon Bon Jovi หลอกแฟนเพลง และระบบเตือนสแกมในมือถือที่ Google DeepMind ทำร่วมกับรัฐบาลสิงคโปร์
ใช้กับภาษาไทยได้แค่ไหน
ยังไม่มีข้อมูลยืนยัน ทั้งสองงานไม่ได้ระบุว่ามีการทดสอบภาษาไทย และงานของ NTU ไม่ได้บอกประเทศของผู้ตัดสินไว้ในเนื้อหาหลัก ส่วนงานปารีสมีอาสาสมัครเพียง 20 คน ReadEval จึงยังบอกไม่ได้ว่าคนไทยที่อ่านแชตภาษาไทยจะทายถูกมากหรือน้อยกว่านี้
งานวิจัยนี้น่าเชื่อถือแค่ไหน
ReadEval ให้คะแนนงานของ NTU ตามเกณฑ์ "ผลวัดที่เชื่อถือได้" 6 ข้อ
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ผ่าน | ทีมระบุว่าเปิดโค้ดและข้อมูลดิบทั้งหมดในเว็บไซต์ของห้องแล็บ |
| บอกสภาพแวดล้อมครบ | ผ่าน | ระบุรุ่นโมเดล ค่าที่ใช้ แพลตฟอร์มรับสมัครผู้ตัดสิน และกติกาการคัดกรองข้อมูล |
| วัดหลายรอบและบอกความแปรปรวน | ผ่าน | การทดสอบกว่า 72,000 ครั้ง ใช้การทดสอบทางสถิติ (t-test และ ANOVA) |
| เทียบอย่างยุติธรรม | ไม่ผ่าน | คัดบทสนทนาที่ AI พลาดชัด ๆ ออก (เช่น พูดซ้ำหรือจบกลางคัน) และงานส่วนใหญ่ไม่ใช่การคุยสด จึงไม่ใกล้การใช้งานจริง |
| เป็นอิสระ | ผ่าน | ทีมมหาวิทยาลัย ไม่ได้ขายโมเดลที่ทดสอบ |
| ยอมรับข้อจำกัด | ผ่าน | ระบุเองว่าผลขึ้นกับงาน วิธีถาม และกลุ่มผู้ตัดสิน และควรตีความคะแนนอย่างระมัดระวัง |
รวม 5 จาก 6 ข้อ ป้าย 🟢 วัดผลจริงจัง เชื่อได้ว่า "ในเงื่อนไขของการทดลอง" คนแยกคำตอบของ AI รุ่นที่ทดสอบได้ไม่ดี แต่ไม่ควรขยายไปถึงโมเดลรุ่นใหม่หรือแชตจริงทุกแบบ
ส่วนงานของปารีสมีตัวอย่างเล็ก (อาสาสมัคร 20 คน และ 49 การทดสอบต่อเงื่อนไข) และรายงานข่าวไม่ได้บอกผลการทดสอบทางสถิติ ReadEval อ่านได้แค่บทคัดย่อและรายงานข่าว จึงใช้ผลนี้เป็นสัญญาณประกอบ ไม่ใช่ข้อสรุปหลัก
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- ตัวเลขเปลี่ยนตามเวอร์ชันของงาน: งาน NTU เผยแพร่บน arXiv ครั้งแรกเมื่อพฤศจิกายน 2022 และปรับหลายรอบ ฉบับสิงหาคม 2024 ระบุคน 549 คน AI 26 ตัว ผู้ตัดสิน 1,126 คน และการทดสอบ 25,650 ครั้ง ส่วนฉบับกันยายน 2025 ระบุ 636 คน 37 ตัว 1,916 คน และ 72,191 ครั้ง ซึ่งตรงกับที่ Phys.org รายงานจากฉบับใน Nature Human Behaviour ReadEval ใช้ตัวเลขชุดหลัง หน้าบทความใน Nature ต้องล็อกอินจึงจะอ่านได้ ReadEval จึงตรวจกับ arXiv ฉบับล่าสุดและ Phys.org แทน
- รายชื่อโมเดล: Phys.org ระบุว่ามีการทดสอบกับ GPT-4o, Claude 3.7 และ Llama 3.3 เท่าที่ ReadEval อ่าน arXiv ฉบับล่าสุด ชื่อ Claude 3.7 และ Llama 3.3 ปรากฏในส่วนวิธีการ ไม่ใช่ในผลหลัก ส่วนการทดลองคุยสดใช้ GPT-3.5-Turbo และ Llama-3-70B
- จำนวนการทดสอบของงานปารีส: Digital Trends เขียนว่า "98 การทดสอบ" ส่วน Tech Xplore เขียนว่า 238 การทดสอบ ตัวเลขไม่ขัดกัน เพราะ 98 คือเฉพาะการทดสอบที่ผู้ตอบเป็น AI (49 + 49) ส่วนที่เหลือ 140 ครั้งเป็นผู้ตอบที่เป็นคน
- บริบทจากงานอื่น: Tech Xplore อ้างงานของ Cameron R. Jones และ Benjamin K. Bergen ที่ให้คนเป็นผู้ซักถามในการทดสอบทัวริงออนไลน์ขนาดใหญ่ ซึ่ง AI สามตัวผ่านได้ราว 50% ขณะที่คนจริงถูกตัดสินว่าเป็นคนเพียง 66% ReadEval ยังเปิดอ่านต้นฉบับงานนี้ไม่ได้
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
ภาษาที่ลื่นไหลไม่ใช่หลักฐานว่าอีกฝั่งเป็นคนอีกต่อไป และ AI ก็ยังช่วยคุณแยกไม่ได้ ทั้งสองงานชี้ไปทางเดียวกัน คือเมื่อดูแค่ข้อความ คนและเครื่องต่างก็ทายได้ไม่ดีกว่าการเดามากนัก จุดที่ยังพอใช้ได้คือการถามต่อและคุยนานขึ้น แต่ผลส่วนนี้มาจากการทดลองขนาดเล็กกับโมเดลรุ่นเก่า และงานปารีสก็แสดงว่าแค่สั่งให้ AI สวมบทให้ดี ร่องรอยที่เคยใช้จับก็หายไป ReadEval ประเมินว่าโมเดลรุ่นปัจจุบันน่าจะเลียนแบบคนได้ไม่แย่กว่ารุ่นที่ทดสอบ แม้ยังไม่มีงานวิจัยยืนยัน วิธีป้องกันที่ได้ผลกว่าการพยายามจับผิดจึงอยู่ที่พฤติกรรมของคุณเอง คือไม่ตัดสินใจเรื่องเงินหรือข้อมูลสำคัญจากแชตเพียงช่องทางเดียว ส่วนในระดับระบบ ข้อเสนอของทีมปารีสเรื่องลายเซ็นดิจิทัลและการให้คนช่วยตรวจ น่าจะเป็นทิศทางที่แพลตฟอร์มต้องคิดต่อ มากกว่าการฝากความหวังไว้กับเครื่องมือตรวจจับ AI อย่างเดียว
แหล่งที่มา
- Nature Human Behaviour: Turing-like tests for language and vision demonstrate a narrowing gap between humans and AI (Zhang et al., 2026)
- arXiv 2211.13087 v3: Can Machines Imitate Humans? Integrative Turing-like tests for Language and Vision Demonstrate a Narrowing Gap (7 ก.ย. 2025)
- arXiv 2211.13087 v2: Can Machines Imitate Humans? Integrative Turing Tests for Vision and Language Demonstrate a Narrowing Gap (17 ส.ค. 2024)
- Tech Xplore / Phys.org: AI often passes for human, but asking follow-up questions can trip it up (29 ต.ค. 2026)
- Computers in Human Behavior Reports: When machines judge humanness: findings from an interactive reverse turing test by large language models (Raynaud et al., 2026)
- Tech Xplore: AIs fail to reliably detect AIs in reverse Turing tests (27 ต.ค. 2026)
- Digital Trends: AI chatbots are so good at pretending to be human that other AIs can't catch them (28 ต.ค. 2026)


