Ai2 ให้ AI ตามค่าที่ถูกสลับไปมาในเอกสารยาว Gemini, Claude, GPT-6 แม่นเหลือไม่เกิน 13%
ชุดทดสอบ StateBench ของ Ai2 พบว่าโมเดลแนวหน้า 4 ตัวตามค่าที่ถูกแก้หรือสลับในเอกสารยาวไม่ทัน โจทย์ยากสุดเหลือแม่น 13% หรือต่ำกว่า

สารบัญ (8 หัวข้อ)
ลองนึกภาพนักมายากลวางลูกบอลไว้ใต้ถ้วยใบหนึ่งจากห้าใบ แล้วสลับถ้วยไปมาไม่หยุด คนที่ตั้งใจดูก็ยังพอตามได้ว่าลูกบอลอยู่ใต้ใบไหน แต่เมื่อสถาบันวิจัย Ai2 (Allen Institute for AI) ให้โมเดล AI แนวหน้า 4 ตัว คือ Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol และ GPT-6 Luna ตามโจทย์ทำนองนี้ในเอกสารที่ยาวมาก ความแม่นของโมเดลกลุ่มนี้ตกลงเหลือ 13% หรือต่ำกว่าในโจทย์ระดับยากที่สุด
ชุดทดสอบใหม่นี้ชื่อ StateBench ไม่ได้ใช้ถ้วยจริง แต่เป็นรายการคำสั่งยาวเหยียดว่าค่าแต่ละตัวถูกตั้งหรือแก้เป็นอะไร เช่น "ใส่เลข 8 ในช่อง A1" แล้วถามว่าสุดท้ายแต่ละค่าเป็นเท่าไร โจทย์มี 4 ระดับที่ Ai2 เทียบกับเรื่องใกล้ตัว ระดับแรกเหมือนวันเกิดที่ไม่เคยเปลี่ยน ระดับสองเหมือนปุ่มตั้งอุณหภูมิที่ดูแค่ค่าล่าสุดก็พอ ระดับสามเหมือนคะแนนเกมที่ต้องบวกสะสมไปเรื่อย ๆ และระดับสี่เหมือนถ้วยที่สลับกัน คือค่าหนึ่งไปหยิบค่าปัจจุบันของอีกตัวมา
ผลคือโมเดลทั้งสี่ทำสองระดับแรกได้ดี แต่พอถึงระดับสามและสี่ ความแม่นร่วงลงเรื่อย ๆ เมื่อเอกสารยาวขึ้น ตรงนี้ต่างจากเกมถ้วยตรงที่ไม่มีมือไวหลอกตา ทุกขั้นเขียนไว้ครบให้ย้อนอ่านได้ แต่ AI ก็ยังพลาด Ai2 อธิบายว่าในโจทย์ระดับยาก แทบทุกขั้นมีผลต่อคำตอบสุดท้าย พลาดไปขั้นเดียวคำตอบก็ผิดทั้งข้อ
เรื่องนี้ใกล้ตัวกว่าที่คิด เพราะงานจริงหลายอย่างคือการตามค่าที่เปลี่ยนไปเรื่อย ๆ เช่น แชตยาวที่คุณแก้แผนเที่ยวหลายรอบ งบประมาณที่ปรับยอดไปมา ไฟล์ที่แก้หลายครั้ง หรือเอเจนต์ AI ที่ทำงานต่อเนื่องหลายขั้น อย่างไรก็ตาม นี่เป็นงานวิจัยฉบับก่อนตีพิมพ์ที่ยังไม่ผ่านการตรวจของผู้ทรงคุณวุฒิ และใช้โจทย์ที่สร้างขึ้นเพื่อทดสอบ ไม่ใช่แชตจริงของผู้ใช้
ถ้าคุณให้ AI ช่วยตามยอดหรือรายการที่เปลี่ยนบ่อย ReadEval แนะนำให้แบ่งงานเป็นช่วงสั้น ขอให้มันสรุปสถานะล่าสุดเป็นระยะ ให้สูตรในสเปรดชีตคำนวณยอดแทนการให้ AI นับเอง และตรวจตัวเลขสำคัญด้วยตัวเองเสมอ ด้านล่างมีตาราง 4 ระดับ กราฟผลของแต่ละโมเดล เหตุผลที่โครงสร้างของโมเดลสำคัญ และคะแนนความน่าเชื่อถือของผลทดสอบนี้
สรุปประเด็นสำคัญ
- ใครทำ: Ai2 เปิดตัว StateBench เมื่อ 3 พ.ย. 2026 พร้อมเปเปอร์บน arXiv (ลงวันที่ 2 พ.ย. 2026) ของ Jackson Petty, William Merrill และ Ashish Sabharwal ทั้งสามคนสังกัด Ai2 (Petty สังกัด New York University ด้วย ส่วน Merrill สังกัด Toyota Technological Institute at Chicago ด้วย)
- ทดสอบอะไร: ความสามารถ "ตามสถานะ" (state tracking) คือรู้ว่าค่าแต่ละตัวเป็นอะไรหลังถูกแก้ไขมาหลายครั้งในเอกสารยาว แบ่งเป็น 4 ระดับความยาก
- โมเดลแนวหน้า: Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol และ GPT-6 Luna ทำสองระดับแรกได้ดี แต่ในระดับสามและสี่ความแม่นตกลงตามความยาวของเอกสาร Ai2 รายงานว่าในโจทย์ระดับสี่ที่ยาวที่สุด ความแม่นเหลือ 13% หรือต่ำกว่า
- โครงสร้างของโมเดลมีผล: เมื่อฝึกโมเดลเล็กกับโจทย์นี้โดยตรง โมเดลแบบ Gated DeltaNet และแบบผสม (hybrid) ตามได้ไกลกว่า transformer มาก ส่วน transformer ไม่เคยเรียนรู้โจทย์ระดับสี่ได้เลย
- สถานะงานวิจัย: เป็นงานวิจัยฉบับก่อนตีพิมพ์ (preprint) ยังไม่ผ่าน peer review เปิดโค้ดภายใต้สัญญาอนุญาต Apache-2.0 และเปิดชุดข้อมูลบน Hugging Face
- คะแนนความน่าเชื่อถือของ ReadEval: 4 จาก 6 🟡 พอใช้อ้างอิงได้
StateBench ทดสอบอะไร และ 4 ระดับต่างกันอย่างไร
โจทย์ทุกข้อเป็นรายการคำสั่งที่ตั้งหรือแก้ค่าของตัวแปรหลายตัว แล้วถามว่าตอนจบแต่ละตัวมีค่าเท่าไร Ai2 อธิบายแต่ละระดับด้วยตัวอย่างในโค้ดและในชีวิตประจำวันดังนี้
| ระดับ | ชื่อในงานวิจัย | ตัวอย่างในโค้ด | เทียบกับชีวิตจริง | ต้องจำอะไร |
|---|---|---|---|---|
| 1 (ง่ายสุด) | R-trivial | let x = 4 แล้วไม่เปลี่ยนอีก | วันเกิด | แค่ค่าแรก |
| 2 | Aperiodic | x = 4 แล้วต่อมา x = 2 | ปุ่มตั้งอุณหภูมิ | แค่ค่าล่าสุด |
| 3 | Soluble | x = x + 5 | คะแนนเกมที่บวกสะสม | ทุกครั้งที่เปลี่ยน เพราะแต่ละครั้งต่อยอดจากค่าเดิม |
| 4 (ยากสุด) | General finite | x = y หรือสลับค่าสองตัว | ลูกบอลใต้ถ้วยห้าใบที่ถูกสลับไปมา | ความเชื่อมโยงระหว่างตัวแปรทุกตัวตลอดทาง |
จุดที่ทำให้การเทียบนี้ยุติธรรมคือ Ai2 เริ่มจากโจทย์ระดับสี่หนึ่งชุด แล้วแปลงเป็นโจทย์ระดับที่ง่ายกว่าอีกสามชุด ทั้งสี่ชุดมีจำนวนตัวแปร จำนวนค่า และตำแหน่งของคำสั่งเหมือนกันทุกอย่าง ต่างกันแค่ชนิดของการแก้ค่า ถ้าโมเดลพลาดในระดับยาก จึงบอกได้ว่าพลาดเพราะชนิดของโจทย์ ไม่ใช่เพราะเอกสารยาวกว่าหรือมีตัวแปรมากกว่า
การแบ่ง 4 ระดับนี้ไม่ได้ตั้งขึ้นลอย ๆ แต่มาจากทฤษฎี Krohn–Rhodes ในพีชคณิต ซึ่งอธิบายว่าโจทย์ตามสถานะแบบต่าง ๆ แยกเป็นชิ้นส่วนพื้นฐานได้อย่างไร แต่ละระดับใช้ชิ้นส่วนพื้นฐานต่างชุดกัน
โจทย์ชุดเดียวกันยังถูกเขียนออกมาหลายรูปแบบ เปเปอร์ระบุว่ามี 6 รูปแบบ เช่น โค้ดที่ใช้ตัวเลข การกรอกช่องในสเปรดชีต และการทาสีลูกบาศก์ เพราะรูปแบบการเขียนอย่างเดียวก็ทำให้ผลต่างกันได้มาก (ดูหัวข้อถัดไป) ความยาวของโจทย์ไล่ตั้งแต่ 8 ถึง 64,000 คำสั่ง
โมเดลแนวหน้าทำได้แค่ไหน
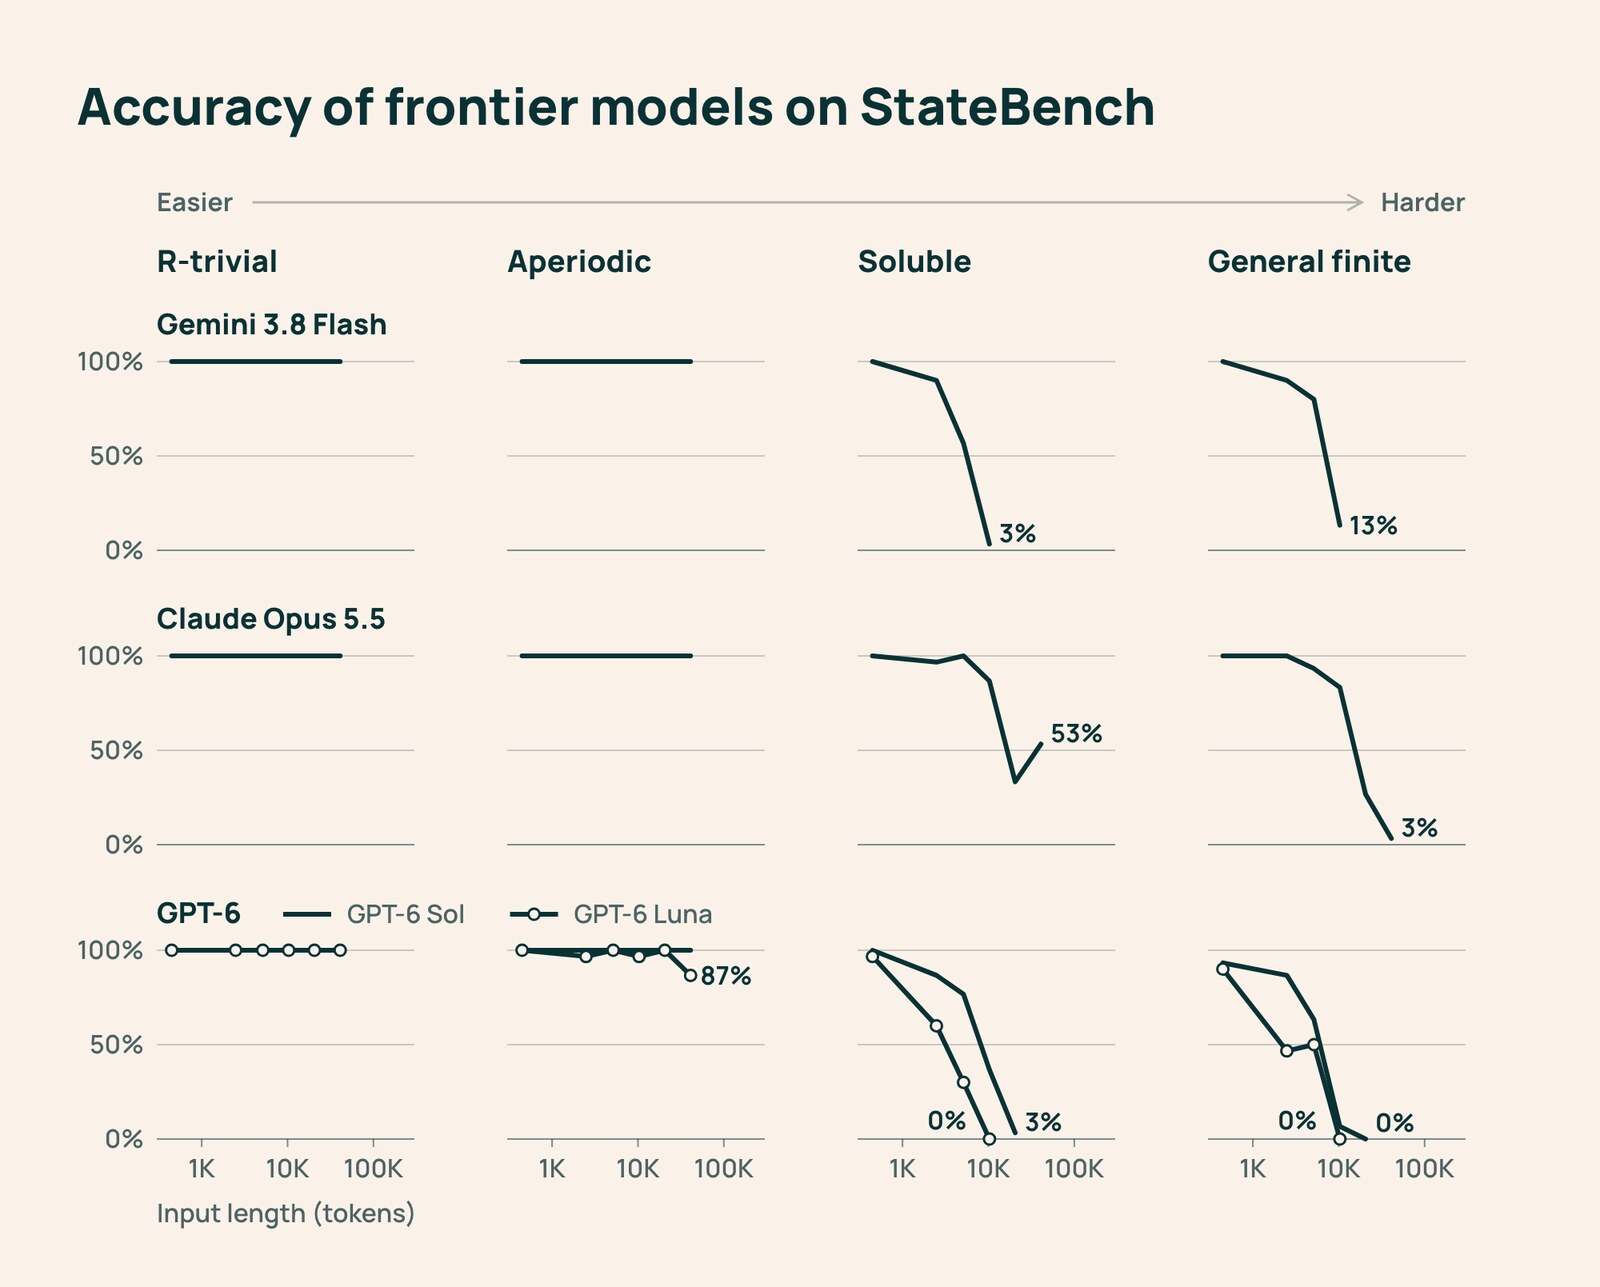
Ai2 ให้โมเดลแนวหน้าทั้งสี่อ่านรายการคำสั่งแล้ว "เขียน" ค่าสุดท้ายของตัวแปรทุกตัวเอง ไม่ใช่เลือกจากตัวเลือก ผลที่ Ai2 สรุปไว้มีดังนี้
- ระดับ 1 และ 2: ทั้งสี่โมเดลทำได้ดี กราฟของ Ai2 แสดงว่าเกือบทุกจุดอยู่ที่หรือใกล้ 100%
- ระดับ 3 และ 4: ความแม่นตกลงชัดเจนเมื่อเอกสารยาวขึ้น บล็อกของ Ai2 ระบุว่าในโจทย์ระดับสี่ที่ยาวที่สุด ความแม่นเหลือ "13% หรือต่ำกว่า" ส่วนเปเปอร์เขียนว่าโมเดลแนวหน้าตกลงไปถึงระดับเดาสุ่มในโจทย์ระดับสามและสี่ เมื่อความยาวถึงช่วง 10,000 ถึง 64,000 โทเค็น
- เหตุผลที่ Ai2 คาดไว้: ความไว (sensitivity) ของโจทย์ ในระดับยาก แทบทุกขั้นส่งผลถึงคำตอบสุดท้าย โมเดลจึงพลาดได้น้อยมากก่อนที่คำตอบจะผิด
อ่านกราฟนี้อย่างไร: เส้นของแต่ละโมเดลจบที่ความยาวไม่เท่ากัน และตัวเลขท้ายเส้นคือความแม่นที่จุดสุดท้ายที่ทดสอบ ในระดับสี่ ตัวเลขท้ายเส้นของทุกโมเดลอยู่ระหว่าง 0% ถึง 13% ซึ่งเป็นที่มาของคำว่า "13% หรือต่ำกว่า" ในระดับสาม ตัวเลขท้ายเส้นกระจายกว่านั้นมาก ตั้งแต่ 0% ถึง 53% เพราะความยาวสุดท้ายไม่เท่ากัน กราฟนี้จึงไม่ควรใช้จัดอันดับว่าโมเดลไหนเก่งกว่า ทั้งบล็อกและเปเปอร์ก็ไม่ได้จัดอันดับไว้ นอกจากนี้เปเปอร์ไม่ได้บอกว่าตั้งระดับการคิด (reasoning) ของแต่ละโมเดลไว้อย่างไร และบล็อกไม่ได้พูดถึงการให้โมเดลใช้เครื่องมือหรือรันโค้ดช่วย
ทำไมโครงสร้างของโมเดลจึงสำคัญ
โมเดลภาษาส่วนใหญ่ที่ใช้กันทุกวันนี้สร้างบนโครงสร้างแบบ transformer ซึ่งอ่านข้อความทั้งก้อนแล้วเลือกจุดที่ต้องดู Ai2 ระบุว่ามีงานวิจัยแสดงข้อจำกัดทางทฤษฎีของ transformer กับโจทย์ตามสถานะที่มีห่วงโซ่ยาว ทางเลือกอีกแบบคือโมเดลที่ "พกความจำติดตัว" ไปทีละขั้น อย่าง Gated DeltaNet หรือโมเดลแบบผสมที่ใช้ทั้งสองแบบ เทียบง่าย ๆ คือ transformer เหมือนคนที่ย้อนเปิดสมุดจดทั้งเล่มทุกครั้งที่ต้องตอบ ส่วน Gated DeltaNet เหมือนคนที่จดยอดปัจจุบันไว้ในกระดาษแผ่นเดียวแล้วแก้ทุกครั้งที่มีคำสั่งใหม่ (การเปรียบเทียบนี้หยาบ เพราะโมเดลจริงทั้งสองแบบซับซ้อนกว่านั้นมาก)
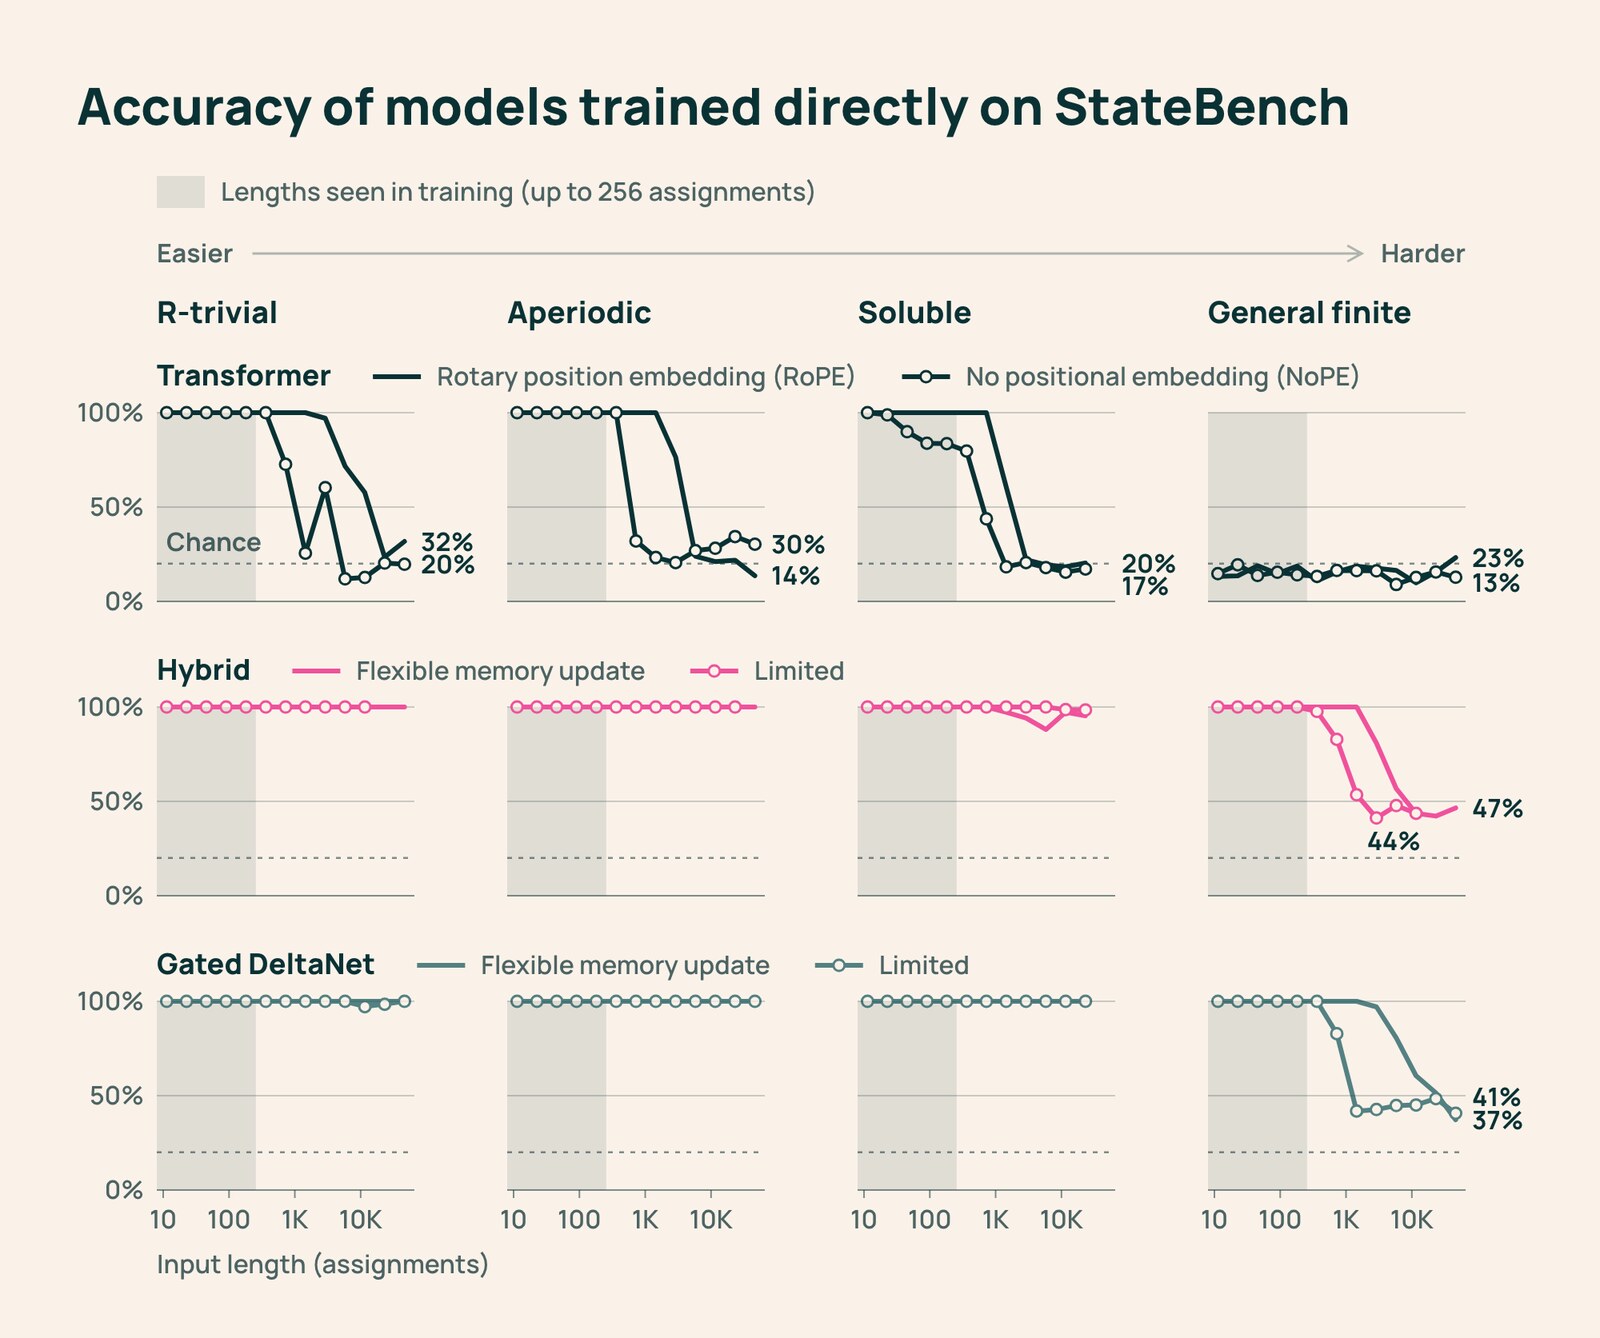
เมื่อฝึกกับโจทย์นี้โดยตรง: Ai2 ฝึกโมเดลขนาด 275 ล้านพารามิเตอร์ขึ้นมาใหม่ 6 ตัว (transformer 2 แบบ, แบบผสม 2 แบบ และ Gated DeltaNet 2 แบบ) ด้วยโจทย์ยาวไม่เกิน 256 คำสั่ง แล้วทดสอบกับโจทย์ยาวถึง 64,000 คำสั่ง หรือ 250 เท่าของที่เคยเห็นตอนฝึก
- Gated DeltaNet และแบบผสมแทบไม่พลาดเลยในระดับ 1 ถึง 3 ไปจนถึงโจทย์ยาวหลายหมื่นคำสั่ง
- transformer เรียนระดับง่ายได้ แต่ความแม่นตกลงเมื่อโจทย์ยาวเกินที่เคยฝึก และไม่เคยเรียนรู้ระดับสี่ได้เลยแม้แต่โจทย์ที่ยาวเท่าตอนฝึก
- ในระดับสี่ Gated DeltaNet แบบที่ปรับความจำได้ยืดหยุ่นกว่า (ค่า eigenvalue ติดลบได้) ยังแม่นเกือบสมบูรณ์ไปถึงราว 10 เท่าของความยาวตอนฝึก ส่วนแบบที่จำกัดกว่าเริ่มพลาดทันทีที่เลยความยาวตอนฝึก
โมเดลเปิดที่ผ่านการฝึกทั่วไปมาแล้ว: Ai2 ทดสอบ Olmo 3 (transformer ขนาด 7,000 ล้านพารามิเตอร์) Olmo Hybrid (ขนาดเท่ากันแต่เพิ่มชั้น Gated DeltaNet) และโมเดลที่เล็กกว่า ทุกตัวฝึกด้วยข้อมูลชุดเดียวกันและไม่เคยเห็นข้อความยาวเกิน 64,000 โทเค็น ผลคือเกือบทุกตัวทำระดับหนึ่งได้ดี ระดับสองแม่นน้อยลงเมื่อยาวขึ้น และระดับสี่อยู่ในระดับเดาสุ่มทุกความยาว Ai2 สรุปว่าสำหรับ Gated DeltaNet และแบบผสม ปัญหาอยู่ที่การฝึก ไม่ใช่โครงสร้าง เพราะเมื่อฝึกตรงก็ทำได้ ส่วน transformer ทำระดับสี่ไม่ได้แม้ฝึกตรง จึงชี้ไปที่ข้อจำกัดของโครงสร้าง
รูปแบบการเขียนโจทย์ก็มีผล: โมเดลเล็กแบบผสมและ Gated DeltaNet ทำโจทย์ระดับหนึ่งที่เขียนแบบชุดทดสอบ RULER ได้เกือบเต็ม แต่พอเขียนโจทย์เดียวกันเป็นการแก้ช่องในสเปรดชีต กลับได้ผลใกล้ระดับเดาสุ่ม ข้อนี้เป็นผลของโมเดลเปิดขนาดเล็ก ไม่ได้ทดสอบกับโมเดลแนวหน้า
เรื่องนี้เกี่ยวกับการใช้ AI ของฉันอย่างไร
StateBench ไม่ได้ทดสอบแชตจริง แต่โจทย์ของมันคล้ายงานที่คนใช้ AI ทำกันบ่อย ReadEval ประเมินว่างานที่เสี่ยงที่สุดคืองานที่ค่าหนึ่งต้องคำนวณจากค่าก่อนหน้า (แบบระดับสาม) หรือขึ้นกับค่าอื่น (แบบระดับสี่) เช่น
- แชตยาวที่คุณแก้แผนหลายรอบ เช่น "ย้ายวันเที่ยวเชียงใหม่ไปแทนวันที่เคยจะไปภูเก็ต"
- การให้ AI ตามยอดเงิน เช่น งบทริปที่เพิ่มหรือลดทีละรายการ หรือยอดหนี้ที่แบ่งจ่ายกันหลายคน
- สเปรดชีตหรือเอกสารที่แก้หลายรอบ แล้วถามว่าตอนนี้ช่องไหนมีค่าอะไร
- เอเจนต์ AI ที่ทำงานยาวหลายขั้นและต้องจำว่าตัวเองเปลี่ยนอะไรไปแล้วบ้าง
สิ่งที่ทำได้ (คำแนะนำของ ReadEval ไม่ใช่ของ Ai2):
- แบ่งงานยาวเป็นช่วงสั้น แล้วเริ่มแชตใหม่พร้อมสรุปสถานะล่าสุด แทนการคุยต่อในแชตเดียวไปเรื่อย ๆ
- ขอให้ AI เขียน "สถานะปัจจุบัน" ทั้งหมดออกมาเป็นตารางเป็นระยะ แล้วตรวจตารางนั้นเอง
- งานที่เป็นตัวเลข ให้ใช้สูตรในสเปรดชีตคำนวณ หรือขอให้ AI เขียนสูตรหรือโค้ดให้ แทนการให้มันบวกลบในหัว
- ตรวจยอดสุดท้ายที่สำคัญ เช่น เงินที่ต้องโอนหรือวันที่ต้องจอง ด้วยตัวเองเสมอ
ลองเองได้: พิมพ์คำสั่งสลับค่าสั้น ๆ ให้แชตบอตที่คุณใช้ เช่น "A=1, B=2, C=3 จากนั้นสลับ A กับ B แล้วให้ C เท่ากับ A แล้วสลับ B กับ C" แล้วถามค่าสุดท้าย โจทย์สั้นแบบนี้โมเดลส่วนใหญ่น่าจะตอบถูก ปัญหาในงานวิจัยเกิดเมื่อคำสั่งยาวถึงหลายหมื่นโทเค็น
ภาษาไทยล่ะ: ยังไม่ยืนยัน เปเปอร์และบล็อกไม่ได้ระบุว่าทดสอบด้วยภาษาอื่นนอกจากรูปแบบที่กล่าวถึง ReadEval จึงไม่ทราบว่าผลจะต่างไปอย่างไรเมื่อสั่งงานเป็นภาษาไทย
ความน่าเชื่อถือของผลทดสอบ
ReadEval ให้คะแนนผลทดสอบนี้ตามเกณฑ์ 6 ข้อ
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ผ่าน | เปิดโค้ดบน GitHub ภายใต้ Apache-2.0 และเปิดชุดข้อมูลบน Hugging Face ใครก็สร้างโจทย์และวัดซ้ำได้ |
| บอกสภาพแวดล้อมครบ | ไม่ผ่าน | บอกขนาดและการฝึกของโมเดลเปิดครบ แต่ไม่บอกการตั้งค่าระดับการคิดของโมเดลแนวหน้า และไม่บอกจำนวนโจทย์ที่ใช้กับโมเดลแนวหน้า |
| วัดหลายรอบและบอกความแปรปรวน | ผ่าน | กราฟในเปเปอร์แสดงช่วงความเชื่อมั่นแบบ Wilson ไม่ได้รายงานแค่ตัวเลขเดียว |
| เทียบอย่างยุติธรรม | ผ่าน | โจทย์ทั้ง 4 ระดับสร้างจากลำดับคำสั่งเดียวกัน ต่างกันแค่ชนิดของการแก้ค่า และทดสอบหลายรูปแบบการเขียน |
| เป็นอิสระ | ไม่ผ่าน | Ai2 ไม่ได้ขายโมเดลแนวหน้าที่ทดสอบ แต่ Ai2 พัฒนา Olmo Hybrid ที่ใช้ชั้น Gated DeltaNet เอง ข้อสรุปที่ว่าโครงสร้างแบบนี้ไปได้ไกลกว่าจึงตรงกับทิศทางของ Ai2 และยังไม่มีบุคคลที่สามหรือ peer review ยืนยัน |
| ยอมรับข้อจำกัด | ผ่าน | บอกชัดว่า StateBench ใช้จำนวนตัวแปรคงที่ ไม่ครอบคลุมงานที่มีสิ่งใหม่เพิ่มเข้ามาระหว่างทาง และยังมีคำถามทางทฤษฎีที่เปิดอยู่ |
| รวม | 4 จาก 6 | 🟡 พอใช้อ้างอิงได้ |
เปเปอร์ยังมีหมายเหตุเรื่องการใช้ AI ว่าผู้เขียนใช้ Claude Opus 5.5 และ Gemini 3.6 Flash ช่วยพัฒนาโครงสร้างตัวเลขในบทพิสูจน์บางส่วน และใช้ AI ช่วยเขียนโค้ดสร้างโจทย์และกราฟ
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- 13% หรือเดาสุ่ม: บล็อกของ Ai2 บอกว่าความแม่นของโมเดลแนวหน้าเหลือ "13% หรือต่ำกว่า" ในโจทย์ระดับสี่ที่ยาวที่สุด ส่วนเปเปอร์เขียนว่าตกลงถึง "ระดับเดาสุ่ม" ในระดับสามและสี่ และบทนำเขียนว่า "เกือบเป็นศูนย์" ในระดับยากสุด สองแบบนี้ไม่ขัดกันในระดับสี่ แต่ในระดับสาม กราฟของ Ai2 เองแสดงว่าตัวเลขท้ายเส้นของโมเดลหนึ่งอยู่ที่ 53% ซึ่งสูงกว่าระดับเดาสุ่ม ReadEval จึงใช้ตัวเลขจากบล็อกและกราฟ และใช้ 13% เฉพาะกับโจทย์ระดับสี่ของโมเดลแนวหน้าทั้งกลุ่ม
- อย่าสับสนกับ 13% อีกจุดหนึ่ง: ในกราฟผลของโมเดลเล็กที่ Ai2 ฝึกเอง มี transformer ตัวหนึ่งที่ได้ 13% ในระดับสี่ด้วย ตัวเลขนี้เป็นคนละเรื่องกับผลของโมเดลแนวหน้า
- รายละเอียดที่มีแค่สื่อรอง: Unite.AI ระบุว่าชุดข้อมูลมี 68,000 แถว ขนาด 1.05GB ReadEval ไม่ได้ตรวจตัวเลขนี้กับหน้าชุดข้อมูลโดยตรง และหน้าผู้เขียนของ Unite.AI ระบุว่าบทความเขียนด้วย AI แล้วให้กองบรรณาธิการตรวจ
- ชื่อซ้ำ: บน PyPI มีแพ็กเกจชื่อ statebench อีกตัวที่วัดความถูกต้องของสถานะของ LLM เหมือนกัน แต่ไม่ได้ระบุว่าเป็นของ Ai2 ถ้าจะลองใช้ ให้ใช้โค้ดจาก GitHub ของ allenai/state-bench
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
AI ระดับท็อปยังเชื่อไม่ได้เวลาต้องตามค่าที่เปลี่ยนต่อเนื่องในเอกสารยาว ให้ AI ช่วยร่างและจัดระเบียบได้ แต่ยอดสุดท้ายควรให้สูตรหรือคุณเองเป็นคนตรวจ จุดเด่นของ StateBench คือแยกให้เห็นว่า "งานจำ" แต่ละชนิดยากไม่เท่ากัน การหาค่าล่าสุด (แบบปุ่มตั้งอุณหภูมิ) โมเดลแนวหน้าทำได้ดี แต่การบวกสะสมหรือสลับค่าที่ขึ้นต่อกันยังเป็นจุดอ่อน ซึ่งช่วยอธิบายได้ว่าทำไมแชตที่แก้รายละเอียดหลายรอบจึงได้คำตอบที่ผิดเงียบ ๆ ข้อควรจำคือโจทย์เป็นตัวแปรที่สร้างขึ้น ยาวหลายหมื่นโทเค็น และไม่ได้บอกว่าให้โมเดลใช้เครื่องมือช่วยหรือไม่ ในงานจริงที่เอเจนต์เขียนโค้ดหรือใช้สเปรดชีตคำนวณได้ ผลอาจต่างออกไป ส่วนข้อเสนอว่าโครงสร้างแบบ Gated DeltaNet ไปได้ไกลกว่า transformer ยังเป็นผลจากโมเดลขนาดเล็กในห้องทดลอง และมาจาก Ai2 ที่พัฒนาโมเดลแบบนี้เอง จึงควรรอดูว่าทีมอื่นทำซ้ำแล้วได้ผลเดียวกันหรือไม่
แหล่งที่มา
- Ai2: StateBench: Testing how language models track state changes over long documents
- arXiv: A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models (Petty, Merrill, Sabharwal)
- GitHub: allenai/state-bench (โค้ด Apache-2.0)
- Unite.AI: Ai2 releases StateBench to measure long-context state tracking
- PyPI: statebench (โครงการอื่นที่ใช้ชื่อเดียวกัน)


