งานวิจัยพบหัวหน้าไว้ใจลูกน้องที่ใช้ ChatGPT ทำงานน้อยลง เว้นแต่บริษัทประกาศสนับสนุนให้ใช้
งานวิจัยใน The Leadership Quarterly พบหัวหน้าเชื่อใจลูกน้องที่ใช้ AI อย่าง ChatGPT น้อยกว่าคนทำเอง (68% ต่อ 24% ในเกมทดลอง) เว้นแต่บริษัทสนับสนุนให้ใช้

สารบัญ (9 หัวข้อ)
ลองนึกภาพว่าคุณส่งงานชิ้นเดียวกันให้หัวหน้าสองครั้ง เนื้องานเหมือนกันทุกอย่าง ต่างกันแค่ครั้งหนึ่งหัวหน้ารู้ว่าคุณใช้ ChatGPT ช่วยทำ งานวิจัยใหม่ในวารสาร The Leadership Quarterly พบว่าแค่รู้ว่าใช้ AI หัวหน้าก็เชื่อใจลูกน้องน้อยลงอย่างชัดเจน แม้บริษัทจะไม่ได้ห้ามใช้ก็ตาม
ทีมของ Samuel Meyers นักศึกษาปริญญาเอก และ Yochanan Bigman อาจารย์ที่ปรึกษา จาก Hebrew University of Jerusalem ในอิสราเอล ร่วมกับ Roman Briker จาก WHU – Otto Beisheim School of Management ในเยอรมนี ทำการศึกษาหลายชิ้น ส่วนใหญ่เป็นเกมทดลองที่ผู้เข้าร่วมรับบทหัวหน้าและมีเงินรางวัลจริงเป็นเดิมพัน ในเกมหนึ่ง "หัวหน้า" ต้องเลือกว่าจะเชื่อรายงานเวลาทำงานที่ลูกน้องแจ้งมา หรือจะตรวจเอง ลูกน้องที่ทำงานเองได้รับความเชื่อใจ 68% แต่ถ้าใช้ AI เหลือ 24% หรือไม่ถึง 1 ใน 4 ทั้งที่หัวหน้าไม่ได้ดูคุณภาพงานเลย
เรื่องนี้คล้ายครูที่รู้ว่านักเรียนใช้เครื่องคิดเลขทำการบ้าน ครูไม่ได้คิดว่าคำตอบผิด แต่เริ่มสงสัยว่านักเรียนทำเองได้แค่ไหน ต่างกันตรงที่ในงานนี้ ความสงสัยไม่ได้หยุดอยู่ที่ชิ้นงาน การทดลองอื่นในชุดเดียวกันพบว่าความเชื่อใจที่ลดลงพาให้หัวหน้าประเมินผลงาน และมองความเหมาะสมที่จะเลื่อนตำแหน่ง ต่ำลงตามไปด้วย อย่างน้อยการใช้ AI ยังถูกมองดีกว่าการลอกงานคนอื่น
จุดที่น่าสนใจที่สุดคือกติกาของบริษัท เมื่อบริษัทประกาศชัดว่าสนับสนุนให้ใช้ AI ช่องว่างความเชื่อใจแคบลงจนไม่มีนัยสำคัญทางสถิติ แต่ถ้าบริษัทห้าม หรือไม่ได้พูดถึงเลย คนใช้ AI ถูกเชื่อใจน้อยกว่าอย่างชัด ส่วนประสบการณ์ใช้ AI ของหัวหน้าเองไม่ได้ช่วยลบความเสียเปรียบนี้
ถ้าคุณใช้ ChatGPT หรือ Gemini ทำงาน ลองเช็กก่อนว่าที่ทำงานมีนโยบายเรื่อง AI หรือยัง ถ้ายังไม่มี การคุยกับหัวหน้าให้ชัดว่าใช้กับงานแบบไหนได้ น่าจะดีกว่าแอบใช้ ซึ่งนักวิจัยเตือนว่าจะกลายเป็น "AI เงา" (shadow AI) อย่างไรก็ตาม ผลส่วนใหญ่มาจากเกมทดลอง และยังไม่มีข้อมูลว่าใช้กับที่ทำงานในไทยได้แค่ไหน ด้านล่างมีกราฟผลเรื่องนโยบาย ข้อจำกัดของงาน และสิ่งที่คุณทำได้
สรุปประเด็นสำคัญ
- งานวิจัย: "Psychological Reactions to Subordinates' LLM Use at Work" โดย Samuel Meyers, Roman Briker และ Yochanan E. Bigman ตีพิมพ์ใน The Leadership Quarterly เล่ม 37 ฉบับที่ 6 (ธันวาคม 2026) บทความหมายเลข 102004 ฉบับออนไลน์ขึ้นตั้งแต่ 30 ก.ย. 2026 เปิดให้อ่านฟรีภายใต้ CC BY 4.0 ส่วน Hebrew University ส่งข่าวผ่าน EurekAlert! เมื่อ 4 พ.ย. 2026
- ผล: ลูกน้องที่ใช้ผลงานจากโมเดลภาษา (LLM) ได้รับความเชื่อใจจากหัวหน้าน้อยกว่าคนที่ทำเอง แต่มากกว่าคนที่ลอกงาน และความเชื่อใจที่ลดลงส่งผลต่อการประเมินผลงาน พฤติกรรมช่วยองค์กร และโอกาสเลื่อนตำแหน่งในสายตาหัวหน้า
- สิ่งที่เปลี่ยนผลได้: มีเพียงนโยบายของบริษัท เมื่อบริษัทสนับสนุนให้ใช้ การใช้ AI ไม่ได้ลดความเชื่อใจอย่างมีนัยสำคัญ ส่วนความสำคัญของงานและประสบการณ์ AI ของหัวหน้าไม่ได้เปลี่ยนผลอย่างมีความหมาย
- ข้อจำกัด: การศึกษา 5 ใน 6 ชิ้นเป็นเกมทดลอง มีเพียงชิ้นเดียวที่ใช้หัวหน้าจริง (อาจารย์ที่ดูแลนักศึกษา) และ ReadEval เปิดบทความฉบับเต็มไม่ได้ จึงยังไม่รู้จำนวนผู้เข้าร่วมและประเทศที่เก็บข้อมูล
- ความน่าเชื่อถือ: 🟡 พอใช้อ้างอิงได้ (3 จาก 6 ข้อตามเกณฑ์ของ ReadEval)
เขาทดลองอย่างไร
บทคัดย่อของบทความระบุว่าเป็นการศึกษา 6 ชิ้น แบ่งเป็นเกมเศรษฐศาสตร์ที่มีเงินรางวัลจริง (incentivized economic games) 5 ชิ้น และการศึกษาในสถานการณ์จริง 1 ชิ้น เกมแบบนี้ต่างจากแบบสอบถามที่ถามว่า "คุณจะเชื่อใจไหม" ตรงที่ผู้เข้าร่วมต้องตัดสินใจโดยมีเงินของตัวเองเป็นเดิมพัน คำตอบจึงใกล้การตัดสินใจจริงกว่า แต่ผู้เข้าร่วมก็ยังเป็นคนที่ "รับบท" หัวหน้า ไม่ใช่หัวหน้าที่มีลูกน้องจริง
ข่าวของมหาวิทยาลัยเล่าเกมหนึ่งไว้ว่า ผู้เข้าร่วมที่รับบทหัวหน้าต้องเลือกว่าจะเชื่อรายงานของลูกน้องเรื่องเวลาที่ใช้ทำงาน หรือจะตรวจสอบเอง โดยรู้อยู่แล้วว่าลูกน้องทำงานเองหรือใช้ AI ตัวเลข 68% กับ 24% คือโอกาสที่ "หัวหน้า" จะเลือกเชื่อรายงาน ไม่ใช่คะแนนความพอใจในตัวงาน
| การศึกษา | ทดสอบอะไร (ตามบทคัดย่อ) | ผล |
|---|---|---|
| 1 | ลูกน้องทำเอง ใช้ AI หรือลอกงานคนอื่น | ใช้ AI ได้รับความเชื่อใจน้อยกว่าทำเอง แต่มากกว่าลอกงาน |
| 2 | นโยบายบริษัท: ไม่มีนโยบาย ห้าม หรือสนับสนุน | เมื่อสนับสนุน การใช้ AI ไม่ได้ลดความเชื่อใจอย่างมีนัยสำคัญ |
| 3 | งานสำคัญมากหรือน้อย | ไม่เปลี่ยนผลอย่างมีความหมาย |
| 1–4 และ 6 | ประสบการณ์ใช้ AI ของหัวหน้าเอง | ไม่เปลี่ยนผลอย่างมีความหมาย |
| 1 และ 5 | ผลต่อเนื่องผ่านความเชื่อใจ | ผลงานที่หัวหน้ารับรู้ พฤติกรรมช่วยองค์กร และโอกาสเลื่อนตำแหน่งลดลง |
| 6 | อาจารย์ประเมินนักศึกษาบัณฑิตศึกษาของตัวเองจากงานจริง | ยิ่งนักศึกษาใช้ AI ในงานหลายส่วน อาจารย์ยิ่งเชื่อใจน้อยลง |
ข่าวของมหาวิทยาลัยไม่ได้บอกว่าตัวเลข 68% กับ 24% มาจากการศึกษาชิ้นไหน และทั้งข่าวกับบทคัดย่อไม่ได้ระบุจำนวนผู้เข้าร่วม แพลตฟอร์มที่ใช้หาผู้เข้าร่วม หรือประเทศที่เก็บข้อมูล บทความฉบับเต็มเปิดให้อ่านฟรีบน ScienceDirect แต่เว็บไซต์ปฏิเสธการเข้าถึงจากเครื่องมือของ ReadEval ข้อมูลวิธีการทดลองในข่าวนี้จึงมาจากบทคัดย่อ (ผ่านฐานข้อมูล OpenAlex) ข้อมูลบทความใน Crossref และข่าวของมหาวิทยาลัย
นโยบายบริษัทเปลี่ยนผลได้แค่ไหน
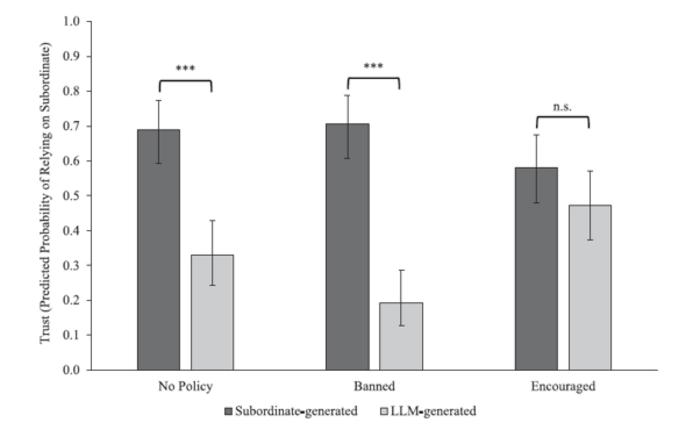
กราฟนี้ทีมวิจัยเผยแพร่มากับข่าวของมหาวิทยาลัย แกนตั้งคือโอกาสที่ "หัวหน้า" จะเลือกเชื่อรายงานของลูกน้อง (0 ถึง 1) แท่งสีเข้มคือลูกน้องที่ทำงานเอง แท่งสีอ่อนคือลูกน้องที่ใช้ผลงานจาก AI ส่วนเส้นบนแท่งแสดงช่วงความคลาดเคลื่อน ReadEval อ่านค่าจากกราฟโดยประมาณได้ดังนี้
| นโยบายของบริษัท | ทำงานเอง | ใช้ AI | ความต่าง |
|---|---|---|---|
| ไม่มีนโยบาย (No Policy) | ราว 0.69 | ราว 0.33 | มีนัยสำคัญ (***) |
| ห้ามใช้ (Banned) | ราว 0.71 | ราว 0.19 | มีนัยสำคัญ (***) |
| สนับสนุนให้ใช้ (Encouraged) | ราว 0.58 | ราว 0.47 | ไม่มีนัยสำคัญ (n.s.) |
สองเรื่องที่ควรรู้ก่อนสรุป อย่างแรก คำว่า "ไม่มีนัยสำคัญ" แปลว่าข้อมูลยังไม่พอจะยืนยันว่ามีความต่าง ไม่ได้แปลว่าความต่างเป็นศูนย์ ในกราฟแท่ง AI ยังต่ำกว่าเล็กน้อย อย่างที่สอง ReadEval สังเกตจากกราฟว่าช่องว่างที่แคบลงในกลุ่ม "สนับสนุน" มาจากสองทาง คือคนใช้ AI ได้รับความเชื่อใจมากขึ้น และคนทำงานเองดูได้รับความเชื่อใจต่ำกว่ากลุ่มอื่นด้วย แต่ความต่างข้ามกลุ่มนี้ข่าวและบทคัดย่อไม่ได้ทดสอบหรืออธิบายไว้ จึงยังสรุปไม่ได้
อีกจุดที่น่าสังเกตคือ "ไม่มีนโยบาย" ให้ผลใกล้กับ "ห้ามใช้" มากกว่า "สนับสนุน" ข่าวของมหาวิทยาลัยจึงเน้นว่าการไม่ห้ามยังไม่พอ บริษัทต้องบอกให้ชัดว่าสนับสนุนการใช้อย่างรับผิดชอบ
ใช้กับที่ทำงานในไทยได้แค่ไหน
ยังยืนยันไม่ได้ ข้อมูลที่ ReadEval เข้าถึงได้ไม่ระบุว่าผู้เข้าร่วมเป็นคนประเทศใด ทีมวิจัยอยู่ในอิสราเอลและเยอรมนี แต่นั่นไม่ได้แปลว่าเก็บข้อมูลในสองประเทศนี้ การศึกษาชิ้นที่ 6 ก็เป็นอาจารย์กับนักศึกษาในมหาวิทยาลัย ไม่ใช่หัวหน้ากับพนักงานในบริษัท
ReadEval ประเมินว่ากลไกหลักของงานนี้ คือการที่คนตัดสินความน่าเชื่อถือจาก "วิธีทำงาน" ไม่ใช่แค่ผลงาน น่าจะพบได้ในที่ทำงานหลายแบบ แต่ระดับของผลอาจต่างกันมากตามวัฒนธรรมองค์กร สายงาน และช่วงเวลา เพราะทัศนคติต่อ AI เปลี่ยนเร็ว นี่เป็นการประเมินของ ReadEval ไม่ใช่ผลที่งานนี้ทดสอบ
งานนี้ต่อจากงานวิจัยไหน และอย่าสับสนกับเรื่องไหน
- คนใช้ AI ถูกมองว่าขี้เกียจกว่า: งาน "Evidence of a social evaluation penalty for using AI" ของ Jessica Reif, Richard Larrick และ Jack Soll ในวารสาร PNAS (พฤษภาคม 2025) ทดลอง 4 ชิ้นที่ลงทะเบียนแผนไว้ล่วงหน้า ผู้เข้าร่วมรวม 4,439 คน พบว่าคนที่ใช้ AI ทำงานคาดว่าจะถูกมองแย่ลงเรื่องความสามารถและความขยัน และก็ถูกมองแบบนั้นจริง งานใหม่ขยายจาก "ภาพลักษณ์" มาสู่ "ความเชื่อใจ" ของหัวหน้า และเพิ่มเรื่องนโยบายบริษัทเข้ามา
- คนละเรื่องกับหัวหน้าที่ใช้ AI เขียนอีเมล: งานของ Anthony Coman จาก University of Florida และ Peter Cardon จาก University of Southern California (สิงหาคม 2025) สำรวจคนทำงาน 1,100 คน พบว่าลูกน้องมองหัวหน้าที่ใช้ AI ช่วยเขียนข้อความมากว่าจริงใจน้อยลง งานนั้นศึกษาทิศกลับกัน คือลูกน้องมองหัวหน้า ไม่ใช่หัวหน้ามองลูกน้อง
ควรบอกหัวหน้าไหมว่าใช้ AI
งานนี้ไม่ได้ทดสอบว่า "เปิดเผย" หรือ "ปิดบัง" แบบไหนดีกว่า ในทุกการทดลอง หัวหน้ารู้อยู่แล้วว่าลูกน้องทำงานอย่างไร และไม่ได้ทดสอบว่าถ้าแอบใช้แล้วถูกจับได้จะเป็นอย่างไร สิ่งที่บอกได้คือ เมื่อไม่มีนโยบาย การที่หัวหน้ารู้ว่าคุณใช้ AI ทำให้เสียเปรียบ ซึ่งอาจผลักให้คนเลือกแอบใช้ นักวิจัยเรียกสิ่งนี้ว่า "AI เงา" และมองว่าเป็นปัญหาขององค์กร
ข้อด้านล่างจึงเป็นคำแนะนำของ ReadEval ที่ตั้งตามข้อสรุปของงาน ไม่ใช่วิธีที่งานวิจัยทดสอบแล้ว
- เช็กกติกาที่มีอยู่ก่อน: ดูคู่มือพนักงาน ประกาศของฝ่ายบุคคลหรือฝ่ายไอที หรือถามตรง ๆ ว่าบริษัทอนุญาตให้ใช้เครื่องมือ AI ตัวไหน กับข้อมูลแบบไหน
- ถ้ายังไม่มี ให้ตกลงกับหัวหน้า: บอกว่าใช้ AI กับขั้นไหนของงาน เช่น ร่างอีเมล สรุปเอกสาร หรือหาไอเดีย และขอให้หัวหน้าบอกให้ชัดว่ายอมรับแบบไหน ผลของงานชี้ว่าการ "สนับสนุนอย่างชัดเจน" ต่างจากการ "ไม่ได้ห้าม"
- แสดงส่วนที่คุณทำเอง: บอกว่าคุณตรวจข้อเท็จจริง แก้ไข และรับผิดชอบผลงานส่วนไหน ข้อนี้ ReadEval ตั้งจากผลที่ว่าหัวหน้าตัดสินจากวิธีทำงาน ไม่ใช่จากคุณภาพงาน
- อย่าใส่ข้อมูลลับของบริษัทในบัญชี AI ส่วนตัว: แม้จะไม่เกี่ยวกับความเชื่อใจโดยตรง แต่นี่คือเหตุผลหลักที่หลายองค์กรกังวลเรื่อง AI เงา
- ถ้าคุณเป็นหัวหน้า: ลองถามตัวเองว่ากำลังตัดสินที่ผลงาน หรือที่ "วิธีทำ" และถ้าทีมใช้ AI ได้ ควรบอกให้ชัดเป็นลายลักษณ์อักษร
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- "68% ของเวลา" หรือ "โอกาส 68%": ข่าวต้นฉบับบน EurekAlert! เขียนว่าลูกน้องที่ทำงานเอง "มีโอกาส 68%" ที่จะได้รับความเชื่อใจ ส่วนบทสรุปบนหน้า Phys.org เขียนทำนองว่าหัวหน้า "เชื่อใจ 68% ของเวลา" ReadEval ยึดถ้อยคำในข่าวต้นฉบับ ซึ่งตรงกับกราฟที่ใช้คำว่าโอกาสที่คาดการณ์ (predicted probability)
- วิธีวิจัย: หน้าข่าวบน EurekAlert! ติดป้ายวิธีวิจัยว่า "Survey" (แบบสำรวจ) แต่บทคัดย่อระบุว่าเป็นเกมเศรษฐศาสตร์ที่มีเงินรางวัลจริง 5 ชิ้นและการศึกษาในสถานการณ์จริง 1 ชิ้น ReadEval ยึดตามบทคัดย่อ
- "ผู้เข้าร่วม" กับ "หัวหน้า": พาดหัวข่าวใช้คำว่า "your boss" แต่ในเกมทดลอง ผู้เข้าร่วมรับบทหัวหน้า มีเพียงการศึกษาชิ้นที่ 6 ที่เป็นผู้ดูแลจริง (อาจารย์กับนักศึกษา)
ความน่าเชื่อถือของผลวัด
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ไม่ผ่าน | ReadEval ยังยืนยันไม่ได้ว่าทีมเปิดชุดข้อมูลและวัสดุการทดลองให้คนอื่นทดลองซ้ำ |
| บอกสภาพแวดล้อมครบ | ไม่ผ่าน | บทคัดย่อบอกรูปแบบการศึกษาทั้ง 6 ชิ้น แต่ข้อมูลที่ ReadEval เข้าถึงได้ไม่มีจำนวนผู้เข้าร่วมและประเทศ |
| วัดหลายรอบและบอกความแปรปรวน | ผ่าน | ผลซ้ำในหลายการศึกษา กราฟแสดงช่วงความคลาดเคลื่อนและการทดสอบนัยสำคัญ |
| เทียบอย่างยุติธรรม | ผ่าน | ทุกกลุ่มทำงานแบบเดียวกัน ต่างกันเฉพาะวิธีผลิตงาน มีกลุ่มลอกงานเป็นตัวเทียบ และมีการศึกษาในสถานการณ์จริงเสริม |
| เป็นอิสระ | ผ่าน | ทีมมหาวิทยาลัยไม่ได้ขายเครื่องมือ AI ทุนวิจัยมาจากมหาวิทยาลัย สหภาพยุโรป และ Israel Science Foundation |
| ยอมรับข้อจำกัด | ไม่ผ่าน | ReadEval เปิดส่วนข้อจำกัดในบทความฉบับเต็มไม่ได้ จึงให้ผ่านไม่ได้ |
รวม 3 จาก 6 ข้อ อยู่ในระดับ 🟡 พอใช้อ้างอิงได้ งานผ่านการตรวจทานโดยผู้ทรงคุณวุฒิ (peer review) ในวารสารด้านภาวะผู้นำ และออกแบบการเปรียบเทียบได้ดี แต่ส่วนใหญ่เป็นเกมทดลองที่ผู้เข้าร่วมสวมบทบาท ถ้าบทความฉบับเต็มเปิดเผยจำนวนผู้เข้าร่วม ประเทศ และข้อมูลดิบ คะแนนอาจสูงขึ้น
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
ปัญหาของการใช้ AI ในที่ทำงานอาจไม่ได้อยู่ที่ตัวงาน แต่อยู่ที่ "กติกาที่ยังไม่มีใครพูดให้ชัด" งานนี้แสดงอย่างหนักแน่นพอสมควรว่า เมื่อคนรู้ว่างานมาจาก AI ความเชื่อใจลดลงทั้งที่คุณภาพงานไม่ได้ต่าง และผลนี้เกิดซ้ำในหลายการทดลอง ข้อค้นพบที่ใช้ได้จริงที่สุดคือเรื่องนโยบาย เพราะบอกว่าความเสียเปรียบนี้ไม่ได้ติดตัวคนใช้ AI ไปตลอด แต่ขึ้นกับว่าองค์กรส่งสัญญาณอย่างไร ข้อจำกัดคือหัวหน้าในห้าการศึกษาเป็นผู้เข้าร่วมที่สวมบทบาท ตัวเลข 68% กับ 24% มาจากเกมเดียวที่วัดการเลือกเชื่อรายงาน ไม่ใช่ผลสำรวจหัวหน้าทั่วไป และยังไม่รู้ว่าเก็บข้อมูลที่ประเทศไหน จึงไม่ควรอ่านว่า "หัวหน้าทุกคนไม่ไว้ใจคนใช้ ChatGPT" สิ่งที่ควรอ่านคือ ถ้าบริษัทอยากให้พนักงานใช้ AI การแจกเครื่องมืออย่างเดียวไม่พอ ต้องบอกให้ชัดว่าใช้ได้และใช้อย่างไร ส่วนคนทำงาน หลักจำง่าย ๆ คือ ตกลงกติกากับหัวหน้าให้ชัดก่อน ดีกว่าใช้แบบเงียบ ๆ แล้วหวังว่าจะไม่มีใครรู้
แหล่งที่มา
- The Leadership Quarterly: Psychological Reactions to Subordinates' LLM Use at Work (Meyers, Briker, Bigman, 2026)
- OpenAlex: บทคัดย่อและสังกัดผู้เขียนของบทความ (DOI 10.1016/j.leaqua.2026.102004)
- Crossref: ข้อมูลเล่ม วันที่ สัญญาอนุญาต CC BY 4.0 และแหล่งทุนของบทความ
- EurekAlert! (Hebrew University of Jerusalem): Using ChatGPT at work? Your boss may trust you less, new study finds
- Phys.org: ข่าวงานวิจัยของ Hebrew University เรื่องหัวหน้าเชื่อใจลูกน้องที่ใช้ ChatGPT น้อยลง (4 พ.ย. 2026)
- PNAS: Evidence of a social evaluation penalty for using AI (Reif, Larrick, Soll, 2025)
- University of Florida News: Is writing with AI at work undermining your credibility? (6 ส.ค. 2025)


